Strata 双 V100 部署实测:老旧数据中心显卡如何跑动 125B MoE 大模型
数据中心退役的旧显卡,历来是预算有限的 AI 爱好者眼中的”香饽饽”。曾售价上万美元的 NVIDIA V100,如今在二手市场只需几千块就能入手。但当大模型开源生态爆发,这些”老古董”能否在新兴的推理引擎上焕发第二春?
答案是:可以,但需要一点”黑科技”。
本文基于 Strata 官方仓库的文档和社区实测,聊聊在两张 V100 上部署 Strata 推理引擎、运行 Qwen3.8-Flash-Next 125B MoE 大模型的完整路径。
被”门槛”卡住的 Volta 老卡
要理解为什么 V100 需要特殊对待,得先弄清楚 Strata 的硬件支持策略。
Strata 官方白纸黑字写的支持门槛是 Compute Capability 7.5,也就是说从 RTX 20 系列(Turing)起才有”正式支持”。而 V100 属于 Volta 架构, compute capability 仅为 7.0(sm_70),刚好卡在门槛之下。
这意味着什么?V100 在 Strata 官方眼里是”二等公民”——走的是实验性 CUDA 12 引擎路径。社区里有人跑通了,但官方文档明晃晃写着”非官方支持,没有预编译引擎”八个大字。
雪上加霜的是,CUDA 13 直接砍掉了 Pascal 和 Volta 的支持。这意味着如果你想在 V100 上编译 Strata,必须使用 CUDA 12.x(官方测试用的是 12.8)。这是一切麻烦的起点。
编译这回事:Linux 上的坑
Windows 用户其实相对幸福——Strata 的 Windows 安装包会自动下载 strata-windows-x64-cuda12.zip,基本不用自己动手。Linux 用户就没这待遇了,得自己从源码编译。
核心构建命令如下:
cmake -S . -B build -DSTRATA_ENABLE_CUDA=ON \
      -DSTRATA_BUILD_TESTS=OFF \
      -DCMAKE_CUDA_ARCHITECTURES=70 \
      -DSTRATA_EXPERIMENTAL_SM60=ON
cmake --build build --target strata -j
关键点在于 -DCMAKE_CUDA_ARCHITECTURES=70——双 V100 是同架构显卡,一条命令搞定。如果是混插卡(比如 V100 + RTX 3080),需要指定多架构:-DCMAKE_CUDA_ARCHITECTURES="70;86"。社区有人在 issue #509 里报告过这种玩法。
但编译过程不是总一帆风顺。根据 issue #1074 的血泪经验,在 openEuler 24.03 + GCC 12.3 + CUDA 12.8 + 双 V100 环境下,host 编译阶段需要加一个 flag:-D_BITS_OPT_RANDOM_H。有趣的是,同一条 issue 里有人说不加也能跑——可能是环境差异导致的玄学问题。
另外,vmm.hpp 里的 size_t 报错在 0.1.40.2 版本已修复,如果遇到类似问题先确认版本。
双卡层切分:不是张量并行
双 V100 最大的卖点是层切分(layer split)流水线并行。这不是张量并行,别搞混了。
配置非常简单:
{
  "gpu": [0, 1],
  "layer_split": "auto"
}
或者用 CLI:
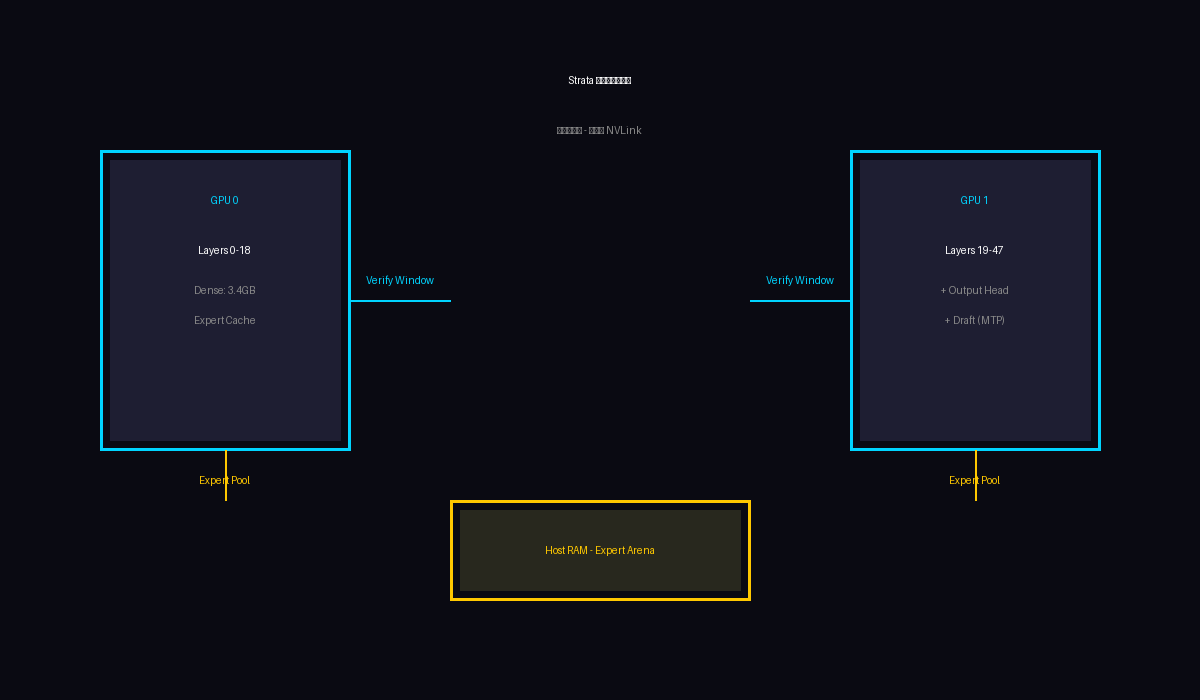
--gpus 0,1 --cuda 12工作原理是这样的:第一张卡跑模型的前半部分(layers 0 到 K-1),第二张卡跑后半部分加上输出头和 draft(MTP)层。第二张卡上会额外占用约 0.8GB 存储输出头和 draft 相关的数据。
有意思的是,双卡不需要 NVLink。Strata 官方明确说了:每个 verify window 的 token 通过 pinned RAM(主机内存)跨卡传输,传输量只有几百 KB,PCIe x4 甚至 x1 插槽都够用。这对没有 NVLink 桥接器的普通服务器是重大利好。
每张卡的显存分配也很清晰:
专家竞技场(CPU pool)放在主机内存里,所有卡共享一份。双卡跑,专家缓存空间翻倍——这才是双卡加速的核心逻辑。层切分本身并不加快 prompt 处理速度,官方文档里写得明明白白:两卡轮流处理单个请求,切分的主要目的是增加专家缓存空间。
auto 模式会枚举所有可能的切分方案,选专家缓存装得最多的那个。Strata 还会自动把跑得快的卡放在最后——因为最后那张卡要跑输出头、draft 和 verify。
双 V100 官方没有测速基准。NVIDIA_V100.md 文档里明确说了”没有官方基准”。后文会给出其他双卡场景的参照数据。
V100 专属优化:两个关键开关
V100 有两个专属优化开关,值得专门说说。
开关一:STRATA_SM70_TABLE=1
这是 opt-in 的 Volta decode 内核优化,启用 gfx906 专家模式 8、Volta rows table 和延迟隐藏的 norm/up 操作。社区有人在 V100-SXM2-32GB(搭配 Threadripper 2990WX,无 AVX-512,96GB RAM)上用 Strata v0.1.41 源码、Unsloth UD-IQ4_XS native pack、262K 上下文、KV int8 量化测过,两组顺序交换的 A/B 对比:
| A/B 对 | 优化前 (tok/s) | 开 STRATA_SM70_TABLE=1 (tok/s) | 提升 |
| 第一对 | 28.16 | 30.92 | +9.8% |
| 第二对(顺序交换) | 28.64 | 32.94 | +15.0% |
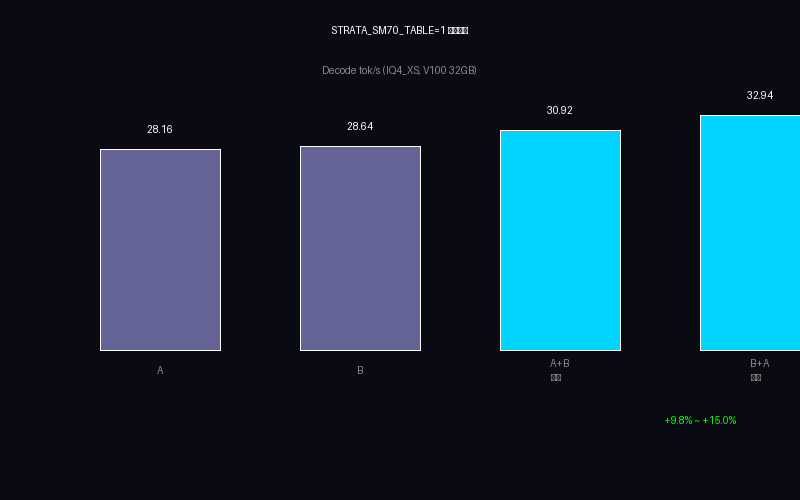
四次运行全部 bit-identical(结果可复现)。Prompt 吞吐不变,只有 decode 环节受益。
开关二:v70 prompt attention 内核
这是针对 prompt 处理的新内核,使用 mma.m8n8k4 指令。在单卡 V100-PCIE-32GB(i9-7960X CPU,UD-IQ4_XS,int8 KV,--spec 2)上测得:
| Prompt 长度 | 旧路径 | 新内核 |
| 7,194 tokens | 1,010 tok/s | 1,164 tok/s |
| 28,650 tokens | 1,063 tok/s | 1,251 tok/s |
| 114,338 tokens | 973 tok/s | 1,123 tok/s |
Decode 阶段(38-51 tok/s)不受影响。另外,V100 没有 int8 tensor core,MoE 专家走 dp4a 内核;BF16 权重转 FP16 跑 tensor core;Q4_0 KV 的 prompt attention 用 decode 内核。
性能参照:其他双卡方案的数据
既然官方没有双 V100 的基准,我们看看其他双卡场景的数据作为参照。
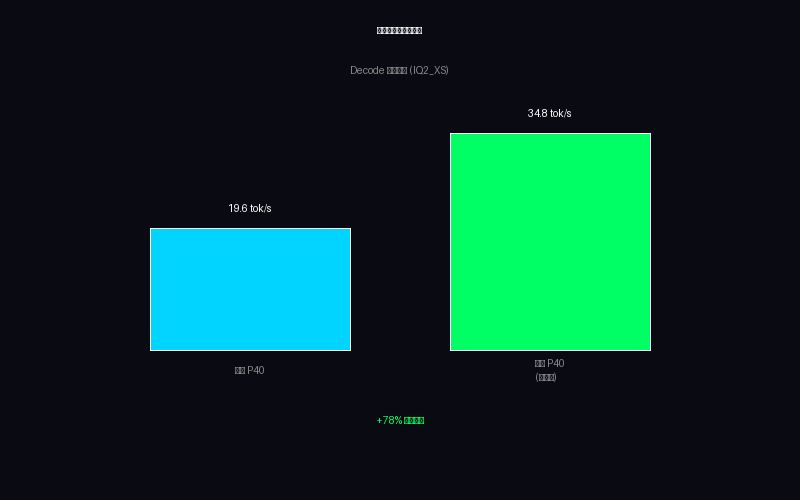
2× Tesla P40 24GB(sm_61)层切分跑 IQ2_XS 量化,单卡 decode 19.6 tok/s,双卡 34.8 tok/s。这是 issue #1028 里的单条实验报告,同架构双卡的加速效果有一定参考价值。
| 配置 | 单卡 Decode | 双卡 Decode | 提升 |
| 2× P40 (sm_61) | 19.6 | 34.8 | +77% |
| V100 + P100 | – | – | +6-11% |
V100 + P100 双卡方案(P100 当专家 helper 缓存)在 0.1.39→0.1.40 升级中实现了 +6-11% 的 decode 提升(issue #1079)。
对于多卡 prompt 场景(4× GP100,和 V100 同源架构),官方测过开 --prefill-pipe 1024(按机器标定 chunk 大小)前后的对比:
| Prompt 长度 | 4 卡 auto (tok/s) | 4 卡 + prefill-pipe (tok/s) | 提升 |
| 2K tokens | 180.9 | 228.0 | +26% |
| 10K tokens | 261.1 | 432.6 | +66% |
| 29K tokens | 475.7 | 559.7 | +18% |
注意 --prefill-pipe 的 chunk 参数不是万能的——不同机器标定的最优值能差一个数量级(官方实测固定 1024 在某些机器上反而慢 19-24%),所以 Strata 的 setup 提供 --calibrate 自动测量本机最优值再写进配置。
预期与限制:诚实说在前面
双 V100 跑 125B MoE 有几个必须认清的限制: