周四拍板,连夜搬家:一家AI公司500GB生产数据库的跨大西洋迁移实录
10月8日,ClickHouse 官方发布了一篇客户实录:AI招聘公司 Clera 用一个晚上,把500GB、500多张表的生产数据库从欧洲搬到了美国,全程生产流量没停。值得看的不仅是这场闪电行动,更是它前面的那场比武——Supabase、Neon、PlanetScale、ClickHouse 四家同跑,基准测试仓库整个开源。
忍不了的数据库痛点
Clera 是一家 AI 人才中介,代表超过20万名候选人,平台上有约2250个在招岗位,每天还有2000多名新候选人进来。匹配引擎全靠数据喂养——每一段对话、每一个岗位信号都进引擎,引擎的上限就是数据库的上限。
迁移前,他们的 Postgres 已超500GB(如今接近1TB)。一次本该瞬间返回的候选人查询要跑约3秒;数据库连续6天CPU打满;超时、丢写、写失败是日常,最糟时连主键更新都写不进去。
四家比武,输赢在存储
团队把工作负载拆成三类:热读取(浏览与物化视图)、点查(本该亚毫秒的主键读写)、后台分析(重型CTE查询和刷新任务)。最痛的是点查——总被后台查询堵死,再叠上抓取任务的IOPS尖峰。
他们把500GB生产数据装进四家供应商,模拟负载回放真实查询,测QPS、P99延迟、错误率、连接等待和等待事件;再用sysbench TPC-C交叉验证。结果ClickHouse几乎拿下全部项目,尤其IOPS——分水岭是本地NVMe存储对上一多数厂商的网络挂载存储。仅这一条,就当场淘汰了Supabase和Neon。
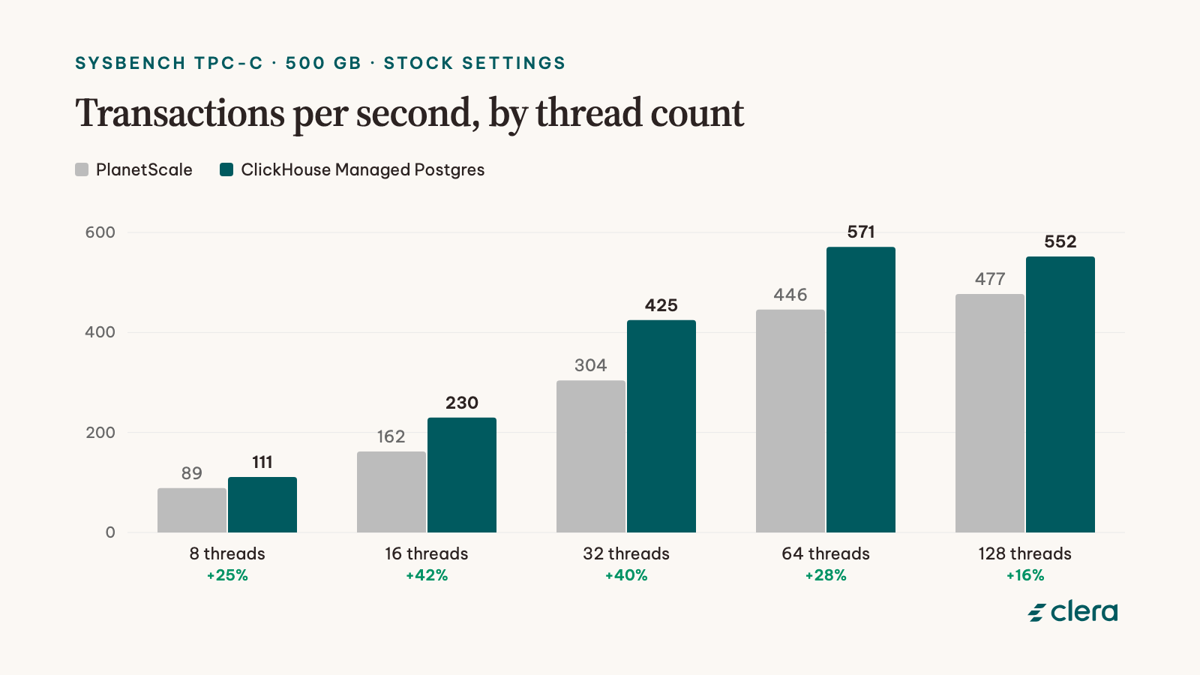
TPC-C上,ClickHouse默认配置对PlanetScale的吞吐优势从16%到42%不等。整个基准——结果、日志、脚本、Terraform文件——开源在GitHub上,还贴心地附了给LLM用的上下文dump。Clera说得坦率:你可以错,然后人们可以纠正你——这就是社区分享知识的美。
闪电迁移夜
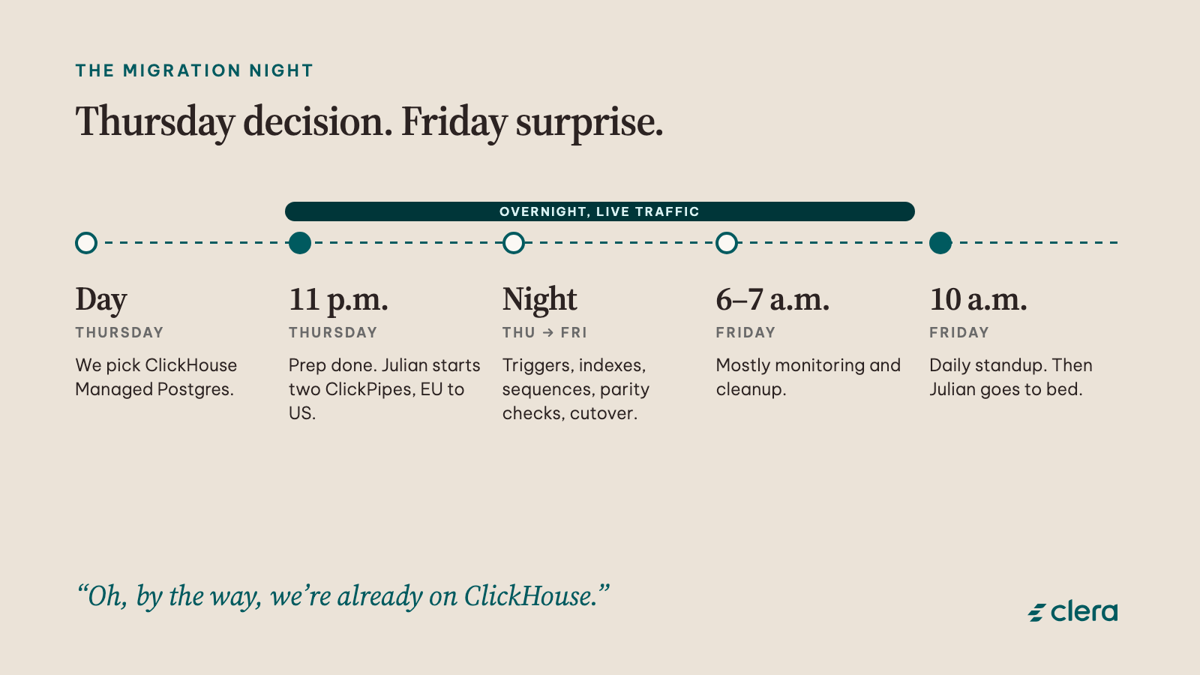
周四拍板。周五早会,CTO Daniel刚要讲迁移计划,工程师来了一句:“对了,我们已经迁到ClickHouse了。”前一晚11点他就做完了全部准备——他的逻辑很简单:准备工作做完还坐着不动,这事就永远会往后拖。
两条ClickPipes管道并行,一条管核心数据,一条管非核心数据;500多张表横跨大西洋,生产流量全程在线。最麻烦的是扩展插件——各家私有插件互不兼容,他们提前几天改造系统,就是为了“随时能干净地迁走”。真正花功夫的是迁后:恢复触发器、重建索引、重排序列、一致性校验、整体切换。到清晨六七点,剩下的就只有监控和收尾。
成绩单
迁移后:CPU从“连续6天100%”降到常态10%–20%;参数一个没改;价格持平甚至略降;查询明显变快,团队再也不用担心谁随手跑一条分析查询就把系统拖垮。
值得注意的是,Clera搬去的不只是ClickHouse分析库,而是它的托管Postgres——本质是原生Postgres换了本地NVMe盘。但路径留好了:哪天分析量撑不住,托管Postgres可以直接同步进ClickHouse。
小夏点评
小夏认为,这个案例最值钱的启示是:数据库选型的水位线已经从内核挪到了存储架构。本地NVMe对网络挂载存储的IOPS和延迟差,足以当场淘汰两家当红serverless Postgres厂商。中国运维同学评估数据库时,请先问一句:我的盘是本地还是网络的?这个问题往往比用哪家数据库更致命。
第二,小夏要夸的是方法论:生产数据回放+标准基准双轨验证,仓库全开源,欢迎别人来挑错。我们太多团队选数据库靠厂商PPT和会议演示,很少像Clera这样拿真实数据自己跑一遍、把代码晒出来让别人审计。这套流程,国内团队可以直接抄。
第三,给国内IT运维提个醒:托管数据库的私有扩展插件就是锁定钩子。Clera提前几天专门处理扩展可移植性,就是为了留退路。任何云上托管服务都一样——进去的时候,就要想好怎么出来。
结语
把视野拉回本周:Supabase在10月2日发布了Multigres和OrioleDB,ClickHouse在10月8日甩出这篇托管Postgres实录——serverless与托管Postgres的竞争正在白热化,而且比拼点已从SQL功能挪到存储、基准和迁移体验这些工程层。对用户这是好事:厂商开始拼可复现的性能,而不是营销幻灯片。
参考链接:
Clera Blog: How we migrated our 500 GB production database to ClickHouse Managed Postgres overnight