
DuckDB 差分存储实战:快照、时间旅行与可写分支的数据管线革命
摘要: DuckDB 社区扩展 duckdb-differential 带来了快照、时间旅行、可写分支等版本控制能力。该扩展解决了数据验证、报告复现、迁移测试等真实场景痛点,让本地数据实验具备了 Git 一样的版本控制体验。
数据工程师的版本控制困境
日常数据工作中,有几个反复出现的场景:
- – 数据导入需要先验证再采纳,不想污染主库
- – 月度报告需要能倒回去查看历史版本的数字
- – 数据库迁移需要用真实数据跑测试,不能每次都重置
- – 分析师想对比两种不同数据转换策略的结果
- – AI Agent 需要一个安全的地方尝试修改,不用担心搞崩生产
这些需求在软件工程领域早就被 Git 解决了,但在数据库世界里,特别是对嵌入式分析数据库,长期没有一个顺手的工具。
DuckDB 社区扩展 duckdb-differential 正是为解决这个问题而生的。它为原生 DuckDB 数据库带来了快照(snapshot)、时间旅行(time travel)、可写分支(writable branch)和克隆(clone)等版本控制能力。所有操作都在本地完成,可选 S3 远程发布让其他机器也能查询保留版本或恢复到某个可写数据库。
核心概念:快照、分支与克隆
理解差分存储之前,需要先搞清楚三个核心概念:
Snapshot(快照)
快照保留数据库的检查点状态。调用 differential_create_snapshot('retail', name => 'baseline') 就能把当前数据库状态”拍照”保存,之后随时可以倒回去。
Branch(分支)
分支从某个快照开始创建一个可写的延续。这就像 Git 的 branch——你在分支上的所有修改都不会影响主数据库。可以用分支来做导入验证、实验性修改、测试新转换逻辑。
Clone(克隆)
克隆创建一个独立的数据库身份和完整的快照历史。读者可以继续查询原始版本,而其他工作独立推进——适合需要”各玩各的”的多人协作场景。
Reader(读者)
在共享模式下,多个读者可以同时查询原始数据库,而写作者在分支上工作。互不干扰,各取所需。
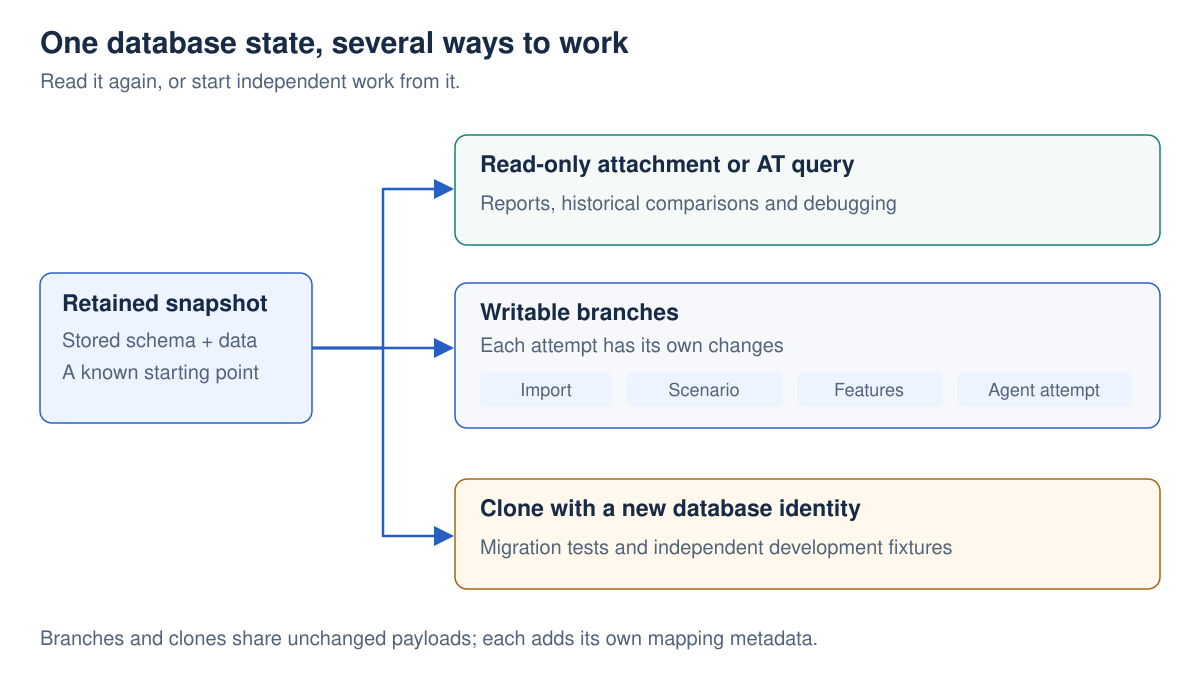
图:一份数据库状态,多种工作方式(图源:tobilg.com)
场景一:导入验证——先验后收
每天的数据导入就像往血管里输血——出错了就是事故。传统做法是半夜手动检查,或者写复杂的校验脚本。差分存储给了一种更优雅的解法:
-- 从快照 1 创建导入检查分支
CALL differential_create_branch('retail', 'import_check', snapshot => 1);
ATTACH 'differential:retail' AS incoming (BRANCH 'import_check');

-- 在分支上做导入和校验
-- 如果发现数据问题,分支一删了之
-- 如果校验通过,一次性合并回主库
对国内数据团队来说,这个模式特别适合 ODS → DWD 的每日 ETL 校验场景。
场景二:报告复现——和时间旅行
“上个月那个数字到底是怎么算出来的?”这是每个数据分析师都被问过的问题。差分存储让这件事变得可追溯:
-- 查看历史快照
SELECT * FROM differential_list_snapshots('retail');

-- 时间旅行:查询某个历史快照的数据
SELECT * FROM differential_at_snapshot('retail', 1);
这意味着你可以把数据库”倒带”到任何一个历史时刻,看当时的数据是什么样的。对需要审计追溯的金融、运营报表场景,这是硬需求。
场景三:Agent 的安全沙箱
AI Agent 正在成为数据工作流的新成员。但让 Agent 直接操作生产数据库是危险的——一次错误的 SQL 可能清空半个表。
差分存储给 Agent 开辟了一个安全的实验空间:
-- 给 Agent 创建一个独立分支
CALL differential_create_branch('retail', 'agent_experiment', snapshot => 3);
ATTACH 'differential:retail' AS agent_sandbox (BRANCH 'agent_experiment');

-- Agent 随便折腾
-- 满意了一键合并,不满意删掉分支重来
这就像给 Agent 发了一张不会被拒付的信用卡——用好了提升效率,用坏了损失可控。
底层原理:Differential Storage 是什么
MotherDuck(DuckDB 官方云服务团队)在官方博客中详细解释了差分存储的设计动机。简单说,Differential Storage 是一个”写时复制”(copy-on-write)的存储解决方案,解决了把 DuckDB 这个”单机嵌入式分析数据库”变成”多人协作数据仓库”面临的一系列工程难题:
- 1. 并发读:原生 DuckDB 假设数据库文件只有自己在改,这和多人协作场景冲突。差分存储允许高效地生成数据库的实时快照,实现并发读 replicas。
- 2. 对象存储兼容:原生 DuckDB 会随机覆盖数据库文件的各个区间,这让基于 S3 的对象存储无法直接用作底层存储。差分存储通过只追加新数据块的方式,解决了这个问题。
- 3. 零拷贝克隆:基于差分存储,克隆一个数据库可以瞬间完成——不需要真正复制数据,只需要复制元数据和指针。这是 MotherDuck 零拷贝克隆功能的底层支撑。
对国内数据团队的启示是:这些能力不只是云厂商的卖点,它们正在变成数据管线的基础设施层。
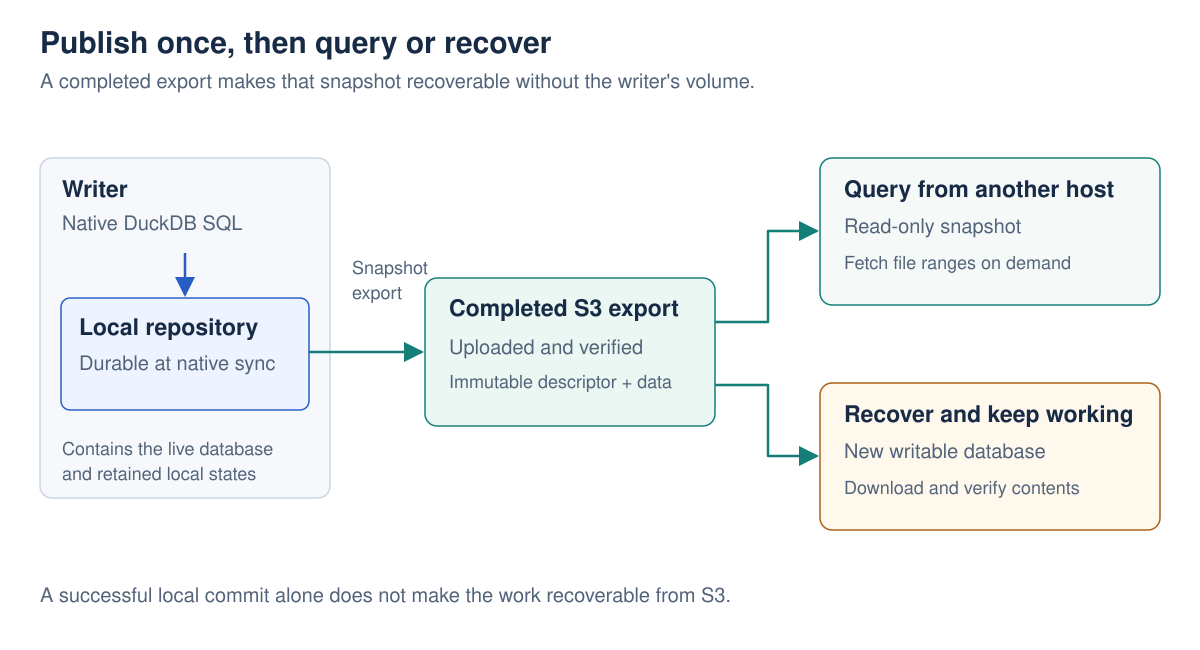
图:发布一次,然后查询或恢复——S3 发布模式让其他机器直接查询保留版本(图源:tobilg.com)
性能与局限
duckdb-differential 当前是实验阶段,目标 DuckDB 版本是 1.5.6,支持 Linux 和 macOS。生产使用前需要评估:
- – 差分存储引入了额外的元数据开销
- – 每次快照都有哈希和同步成本
- – 清理分支不会自动清理关联的快照,需要手动维护生命周期
这些限制意味着它目前最适合:
- – 本地数据实验
- – 小团队协作
- – Agent 沙箱
- – CI/CD 测试环境
大规模生产数据仓库场景,建议关注 MotherDuck 的托管服务。
小夏点评
- 1. 差分存储是数据工程领域的”Git 时刻”。 过去二十年,我们有了代码版本控制,但数据库变更管理一直停留在”备份/恢复”的原始阶段。快照+分支这个模型打通了数据管线的版本控制体验。
- 2. 对国内数据团队的实用价值被低估了。 很多团队还在用”导出一份 SQL 脚本存到文件里”这种土办法做数据版本管理。duckdb-differential 直接在 SQL 层面解决了这个问题,上手成本极低。
- 3. Agent + 差分存储 = 数据操作的未来范式。 给 AI Agent 一个可写分支,就像给一个初级工程师一间独立的办公司——能干活、闯不了祸。这个模式会让 Agent 在数据场景的渗透速度加快。
参考链接
- – 社区扩展文档:Differential storage for DuckDB
- – MotherDuck 官方博客:Differential Storage: A Key Building Block For A DuckDB-Based Data Warehouse
- – DuckDB 官方文档:https://duckdb.org/
- – duckdb-differential GitHub:https://github.com/duckdb/duckdb-differential