2025本地大模型GPU选购指南:一张表看懂消费级显卡真实性能
随着大模型开源生态的蓬勃发展,在本地运行LLM不再是极客的专属玩具。但面对琳琅满目的显卡选项,从千元的RTX 4060 Ti到近两万元的RTX 5090,究竟哪张卡更适合你的需求?近期,专业LLM硬件网站LocalLLM.in发布了一份详尽的2025消费级GPU基准测试报告,涵盖了从旗舰到入门的所有主流选择,并给出了不同场景下的选购建议。
VRAM:理解本地LLM的瓶颈
在选卡之前,必须先理解一个核心概念:VRAM使用量公式。本地运行LLM时,显存消耗分为两部分:
具体公式为:
VRAM [GB] = (P × b_w) + 0.55 + 0.08×P + (B × N × 2 × L × (d/g) × b_kv) / 10^9其中P是参数量(单位十亿),b_w是每个权重的字节数(Q4_K_M约为0.57字节),N是上下文长度。关键洞察是:KV缓存才是长文本场景的真正瓶颈,而非模型本身的大小。
这意味着,一块12GB显存的RTX 4060 Ti 16GB(实际可用约14GB)可以流畅运行7B模型(Q4量化),但对于13B模型在长上下文下可能吃力。
性能实测:RTX 5090称王,预算用户有惊喜
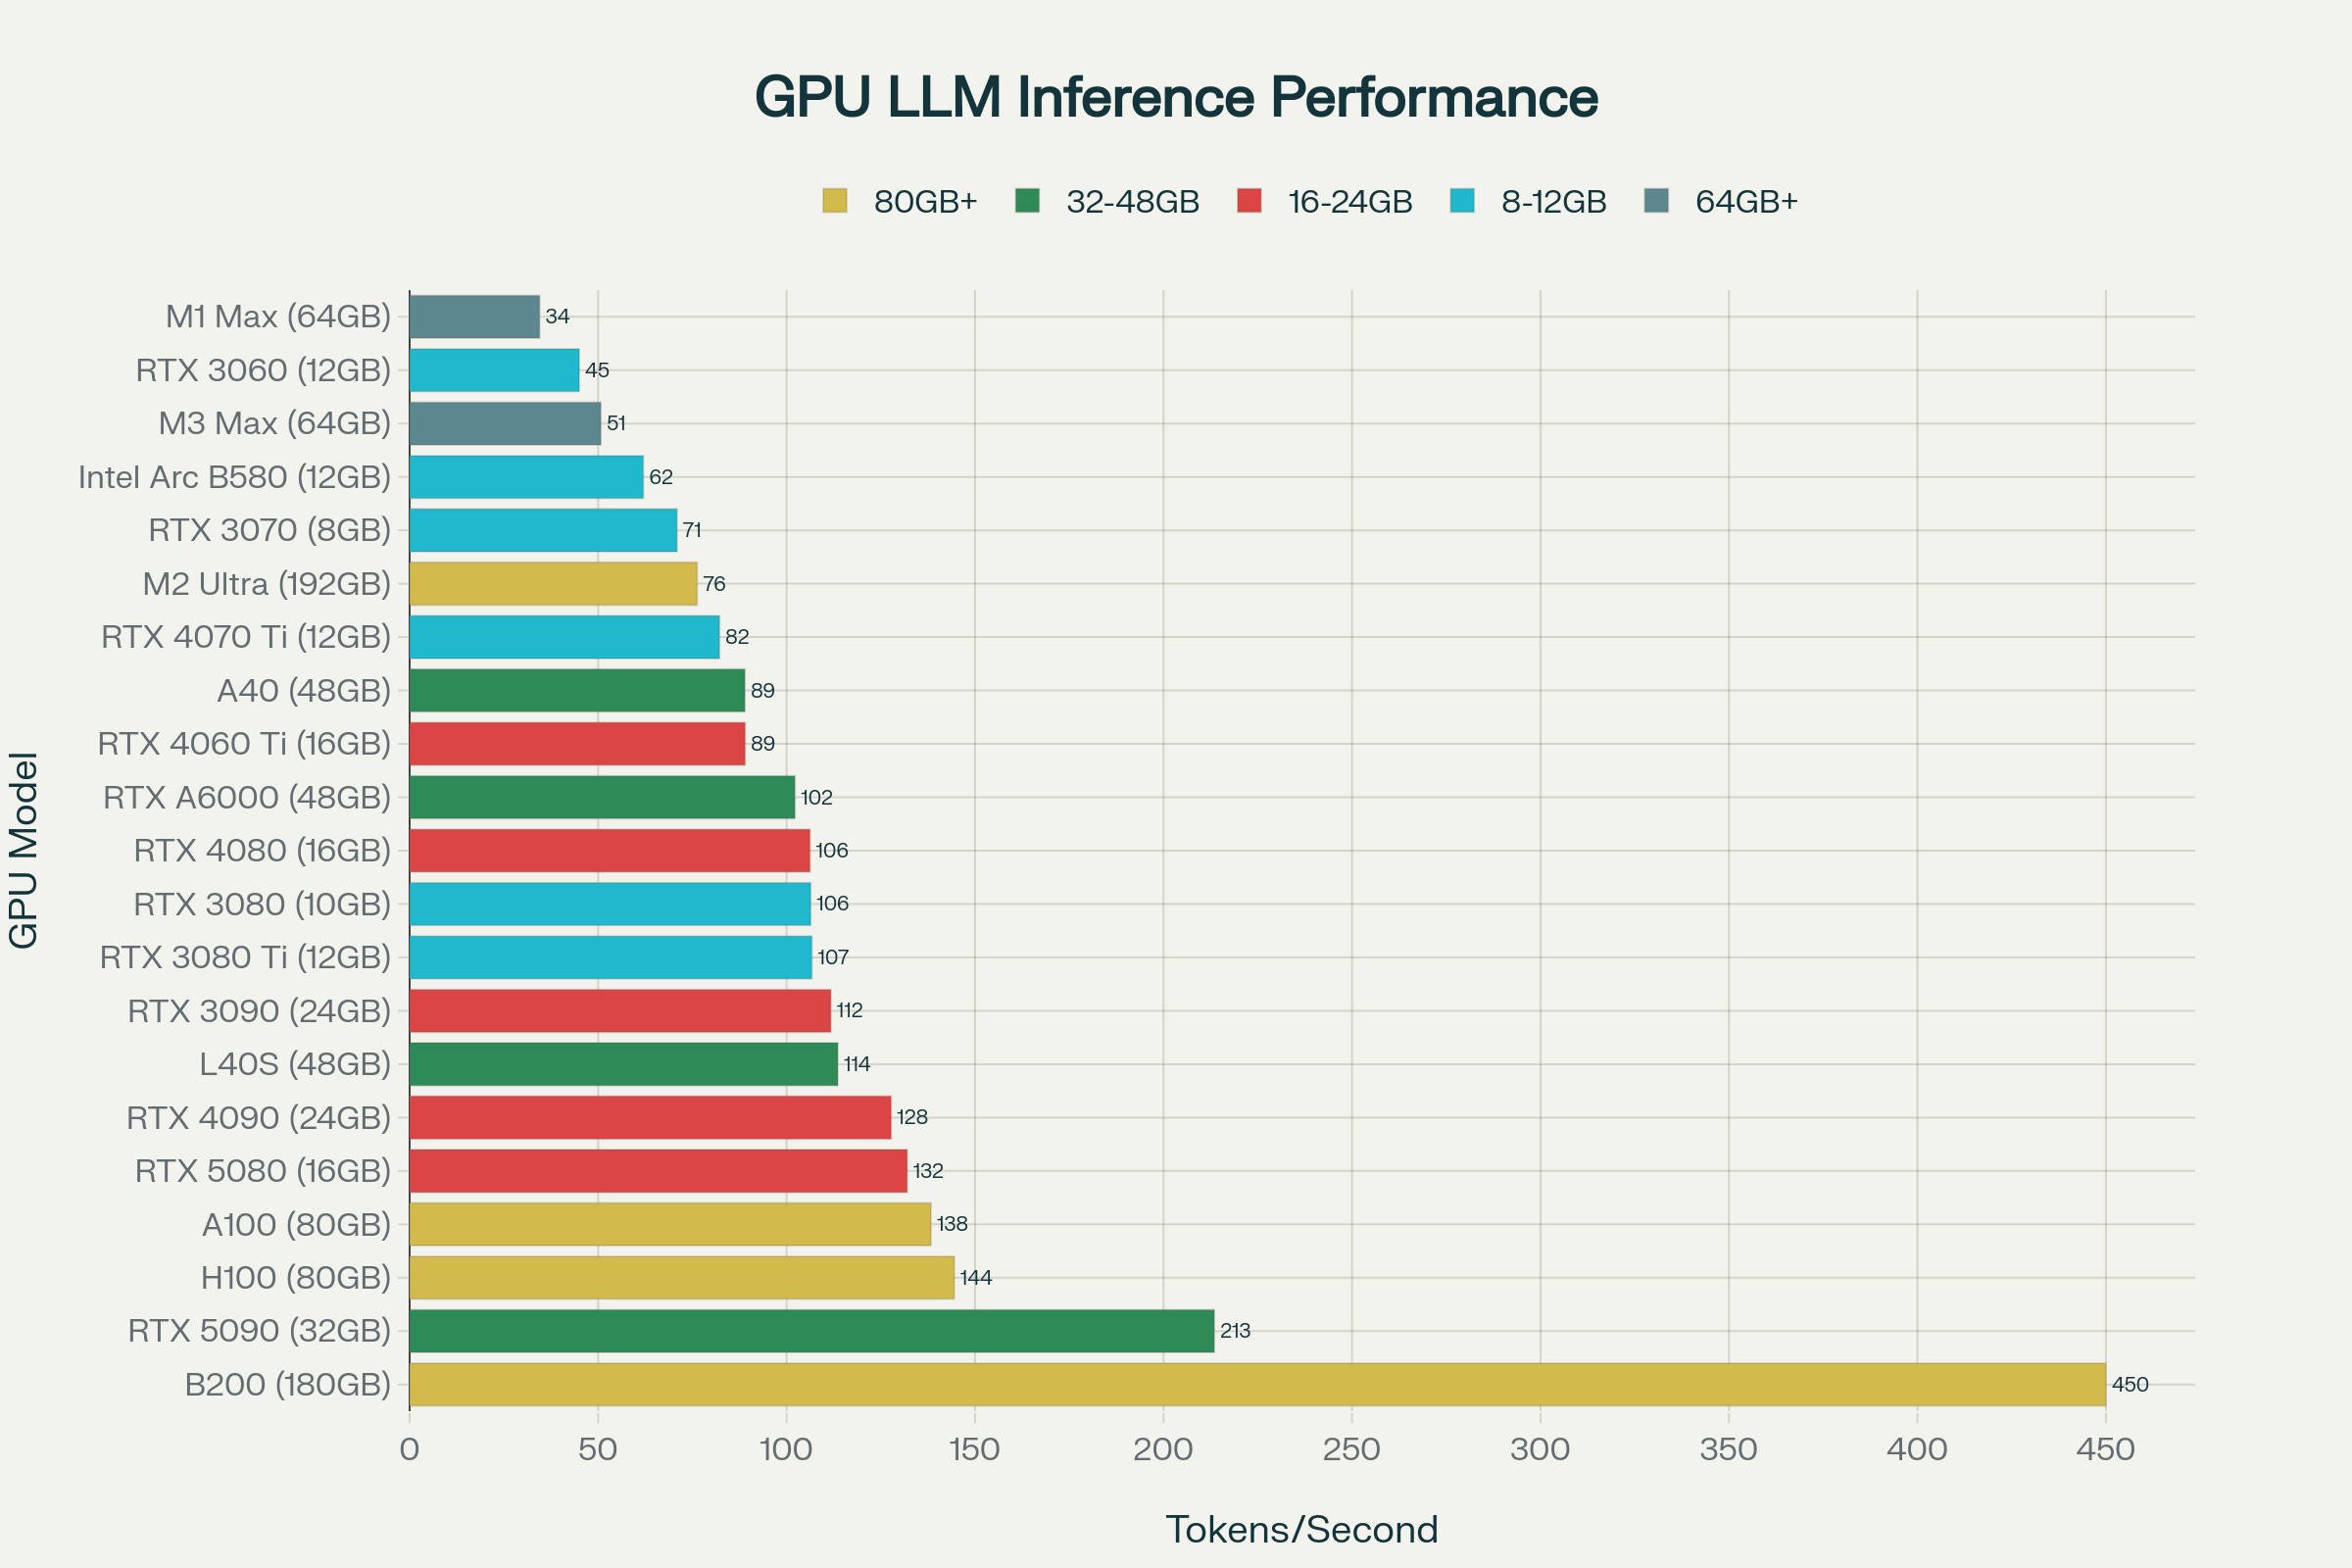
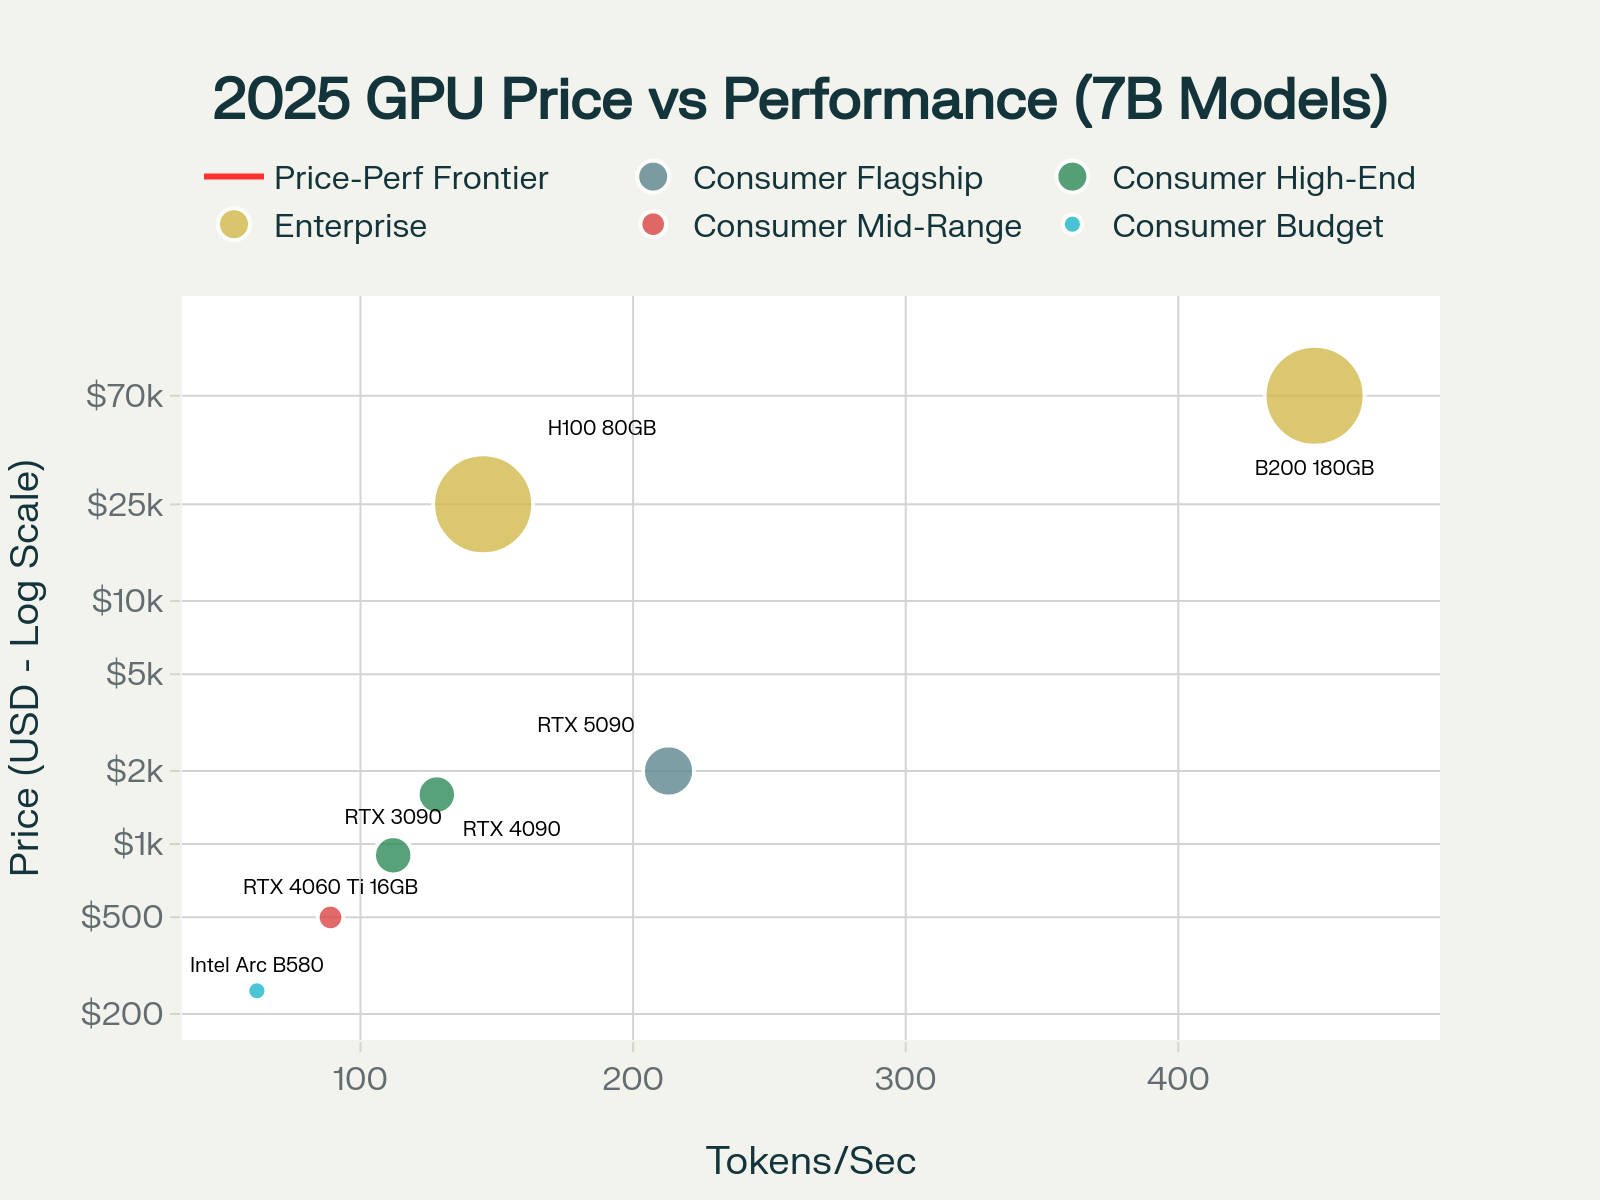
测试使用LLaMA 3 8B Q4_K_M量化模型作为统一基准,测得了以下结果:
| 级别 | 显卡 | 8B模型(tokens/s) | 价格 | 性价比($/tokens/s) |
| 旗舰 | RTX 5090 32GB | 213 | $1999 | $9.38 |
| 旗舰 | RTX 4090 24GB | 128 | $1599 | $12.49 |
| 次旗舰 | RTX 5080 16GB | 132 | $999 | $7.57 |
| 高端 | RTX 3090 24GB | 112 | $800-900* | $7.14 |
| 主流 | RTX 4080 Super | 105 | $999 | $9.51 |
| 主流 | RTX 4070 Ti Super | 92 | $799 | $8.69 |
| 入门 | RTX 4060 Ti 16GB | 89 | $499 | $5.61 |
| 入门 | Intel Arc B580 12GB | 62 | $249 | $4.02 |
| 入门 | RTX 3060 12GB | 45 | $350 | $7.78 |
*RTX 3090为二手价格
几个关键洞察:
内存溢出:比性能下降更可怕的陷阱
一个容易被忽视的问题是VRAM溢出。当模型权重+KV缓存超过显存容量时,数据会在CPU和GPU之间频繁交换:
教训很残酷:要么全装进显存,要么干脆用CPU。部分GPU使用反而因为PCIe传输开销而更慢。
32B模型实战:这些卡可以跑
| 模型 | 所需显存(Q4) | 推荐显卡 |
| 7B | ~4GB | 任意8GB+显卡 |
| 13B | ~8GB | RTX 4060 Ti 16GB |
| 30B | ~18GB | RTX 4090/5090 |
| 70B | ~35GB | 需要多卡或 quantized |
在Q4量化下,RTX 4090(24GB)和RTX 5090(32GB)可以舒适地运行30B模型。如果想挑战70B模型,需要多卡并行或接受较慢的推理速度。
MoE模型:新变量
2025年,混合专家(MoE)架构成为主流。一个70B参数的MoE模型,实际激活参数可能只有10-20B,这意味着:
典型MoE模型推荐配置:
选购决策树
根据你的使用场景:
场景一:刚入门,想体验(预算<$500)
→ Intel Arc B580 ($249)
场景二:认真做开发(预算$500-1500)
→ RTX 4060 Ti 16GB ($499) 或 RTX 3090二手 ($800-900)
场景三:追求旗舰性能(预算>$1500)
→ RTX 5090 ($1999)
场景四:专业工作站
→ RTX A6000 (48GB) 或 L40S