向量数据库横评:7大开源引擎真实性能数据与选型建议
当我们为RAG系统选择向量数据库时,网上铺天盖地的”最快””最强大”宣传让人眼花缭乱。但这些营销话术背后,不同数据库在实际生产环境中的表现差异究竟有多大?近期,专注于AI技术评估的AIMultiple发布了一份重磅实测报告,对7大主流开源向量数据库进行了全面的基准测试,覆盖单线程速度、并发吞吐量、内存占用、过滤查询、混合搜索、写入性能和索引构建等7个维度。这份测试不仅给出了具体数字,还揭示了一些反直觉的结论——比如,在检索质量上,7个数据库几乎打平。
为什么公开展览的benchmark数据参考价值有限
在深入数据之前,有必要理解测试的方法论。向量数据库的核心是近似最近邻(ANN)搜索,通过调整搜索参数(ef或nprobe)在召回率和速度之间做权衡。问题在于,如果固定同一个参数值去比较两个数据库,可能并不公平——其中一个可能用了更高的搜索精度来换取速度。
这份基准测试采用了一种更科学的做法:将每个引擎的参数调到相同召回率水平(Recall@10 = 0.95)后再比速度。这样一来,速度的差异就真正反映了数据库本身的效率高低,而非参数设置的花招。测试使用了bge-m3嵌入模型(1024维,余弦相似度),在MedRAG-50k(5万条医学问答数据,154个查询)和TechQA-28k两个真实数据集上验证,同时还有一轮225万向量的大规模测试。
单线程性能:7倍差距,但无关紧要
在单线程、相同召回率设定下,7个数据库的吞吐量差异相当惊人。Redis以764 QPS拔得头筹,随后是Qdrant(377)、Milvus(342)、Weaviate(341)、pgvector(257)、Chroma(197),最后是LanceDB(70)。从第一名到最后一名,相差近11倍。
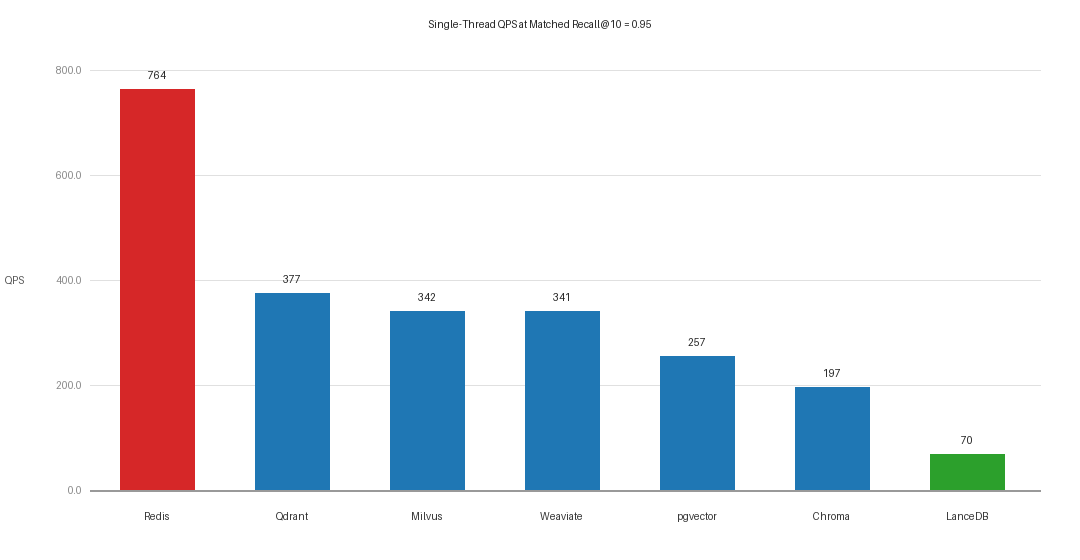
不过,作者特别指出一个关键点:对于大多数RAG应用来说,这个差距其实没那么重要。RAG系统的性能瓶颈通常不在向量检索,而在LLM生成环节——一次向量搜索可能只需几毫秒,但LLM生成答案可能需要几秒甚至十几秒。向量搜索从15ms优化到8ms,对于整个系统而言几乎是感知不到的。
真正值得关注的,是不同数据库在特定场景下的适用性。举个例子,如果你的系统需要低延迟的单一查询响应(比如面向终端用户的实时问答),Redis的低延迟优势就很有价值;但如果需要高并发吞吐量(比如后台批量处理),就需要看并发测试的结果。
并发性能:Weaviate称王,Redis掉队
单线程只能说明单个查询有多快,生产环境更关心多用户并发下的整体吞吐量。测试用32核CPU、1到512个并发请求来模拟真实场景,结果让人大跌眼镜。
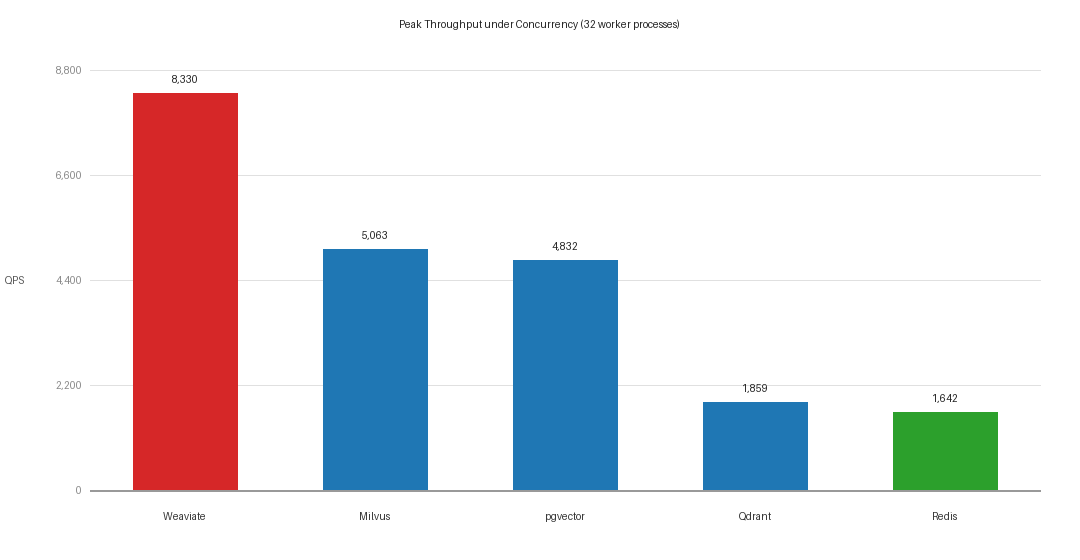
在高并发场景下,Weaviate从单线程的垫底位置逆袭,一跃达到8330 QPS的峰值,超过了所有对手。Milvus以5063 QPS位居第二,pgvector也有4832 QPS的表现。Redis虽然单线程最快,但在高并发下反而表现最差——这与它的架构设计有关,RediSearch的查询线程池默认关闭,在高并发下无法充分利用多核。
这个结果对国内开发者很有参考价值。如果你计划在K8s集群上部署RAG服务,需要考虑数据库的横向扩展能力。Weaviate和Milvus在这种场景下明显更适合。
内存占用:Milvus在大规模下最省钱
在5万向量规模下,各数据库的内存占用差异巨大:Redis仅需559 MB(但关闭了持久化),Chroma需要1.8 GB,pgvector约2 GB,Weaviate约1.2 GB,Milvus最高达3.3 GB。
但到了225万向量规模,情况发生了翻转:Milvus反而最节省内存,只用17 GB,而Chroma暴增到62.4 GB。这是因为Milvus采用了类似DiskANN的架构,将索引卸载到磁盘,而其他全内存数据库的内存消耗随数据量线性增长。
这个发现对成本敏感的项目非常重要。国内很多团队使用云服务器自建向量检索服务,选择Milvus可以在大规模数据下显著降低内存成本。但如果数据量较小(50万向量以内),Redis的低内存优势则更为突出。
过滤查询:被忽视的性能杀手
很多RAG系统会结合元数据过滤(比如按时间、类别筛选后再向量搜索),但这个场景在大多数基准测试中被忽略了。测试发现,过滤查询对性能的影响远超预期。
在带元数据过滤的查询中,最差情况下的召回率保持在0.968(Redis)到1.00(Weaviate、pgvector、LanceDB)之间,召回率本身不是问题。但过滤后的吞吐量差距巨大:Milvus在各种过滤选择性下都能保持268到732 QPS,而Chroma和pgvector只有10到56 QPS——相差40倍以上。
对于需要频繁使用元数据过滤的RAG应用(如多租户系统、按时间范围检索等),Milvus和Weaviate是更稳妥的选择。
混合搜索:向量+关键词的协同效应
现代RAG系统越来越倾向于混合搜索——既做向量相似度匹配,又做BM25关键词匹配,然后通过倒数排名融合(RRF)合并结果。测试发现,混合搜索可以显著提升检索质量,nDCG提升幅度从0.030到0.067不等。
各引擎的原生混合搜索能力差异很大:
如果你的RAG系统需要处理大量短查询和关键词匹配,原生混合搜索能力是关键考量。
写入与实时更新:Redis和Milvus最擅长
真实的RAG知识库需要持续更新——新增文档、修改内容、删除过期数据。测试模拟了持续写入场景,结果显示:
对于需要高频实时更新的RAG系统(如动态知识库、用户行为分析),Redis和Milvus是首选。
索引构建速度:13倍差距
从零开始构建向量索引的时间差异巨大。在5万向量规模下,最快的是LanceDB(7秒),最慢的是pgvector(88秒)。到了225万向量规模,差距拉大到13倍:LanceDB和Milvus仅需7-8分钟,而pgvector需要92分钟。
对于需要频繁重建索引的场景(如全量数据刷新),构建速度会显著影响运维体验。
核心结论:数据库不是瓶颈,嵌入模型才是
最重要的发现是:在相同召回率下,7个数据库的检索质量几乎相同。nDCG@10分数分布在0.803到0.817之间,差距仅为0.014。这意味着,选择向量数据库更多是选择运维特性(扩展性、写入性能、混合搜索能力),而非检索效果本身。
更令人深思的是,当数据规模扩大到225万向量时,所有数据库的检索质量都出现了断崖式下降——nDCG@10从0.81骤降至约0.56。这不是数据库的问题,而是嵌入模型本身的局限性:正确答案被海量干扰数据淹没了。
这也提醒国内开发者:过度优化向量数据库可能是浪费时间,把更多精力放在提升嵌入模型质量、引入重排序(Reranker)环节,可能对RAG效果提升更明显。