Push 胜过 Pull:vLLM 推送式 KV 传输让首 token 时延最多降 3 倍
vLLM 是当前最主流的开源 LLM 推理引擎之一。LLM 推理天然分两个阶段:prefill 处理提示词、构建键值(KV)缓存,decode 利用缓存逐 token 生成。两者在计算与内存特性上差异很大,生产部署正越来越多地采用「Prefill-Decode(P/D)分离推理」——把两个阶段放到独立的引擎实例上,分别扩缩容和调优。代价是:KV 缓存必须先从 prefill 实例传到 decode 实例,生成才能开始,这次传输的快慢直接决定首 token 时延(TTFT)。
卡点在哪:Pull 模式阻塞关键路径
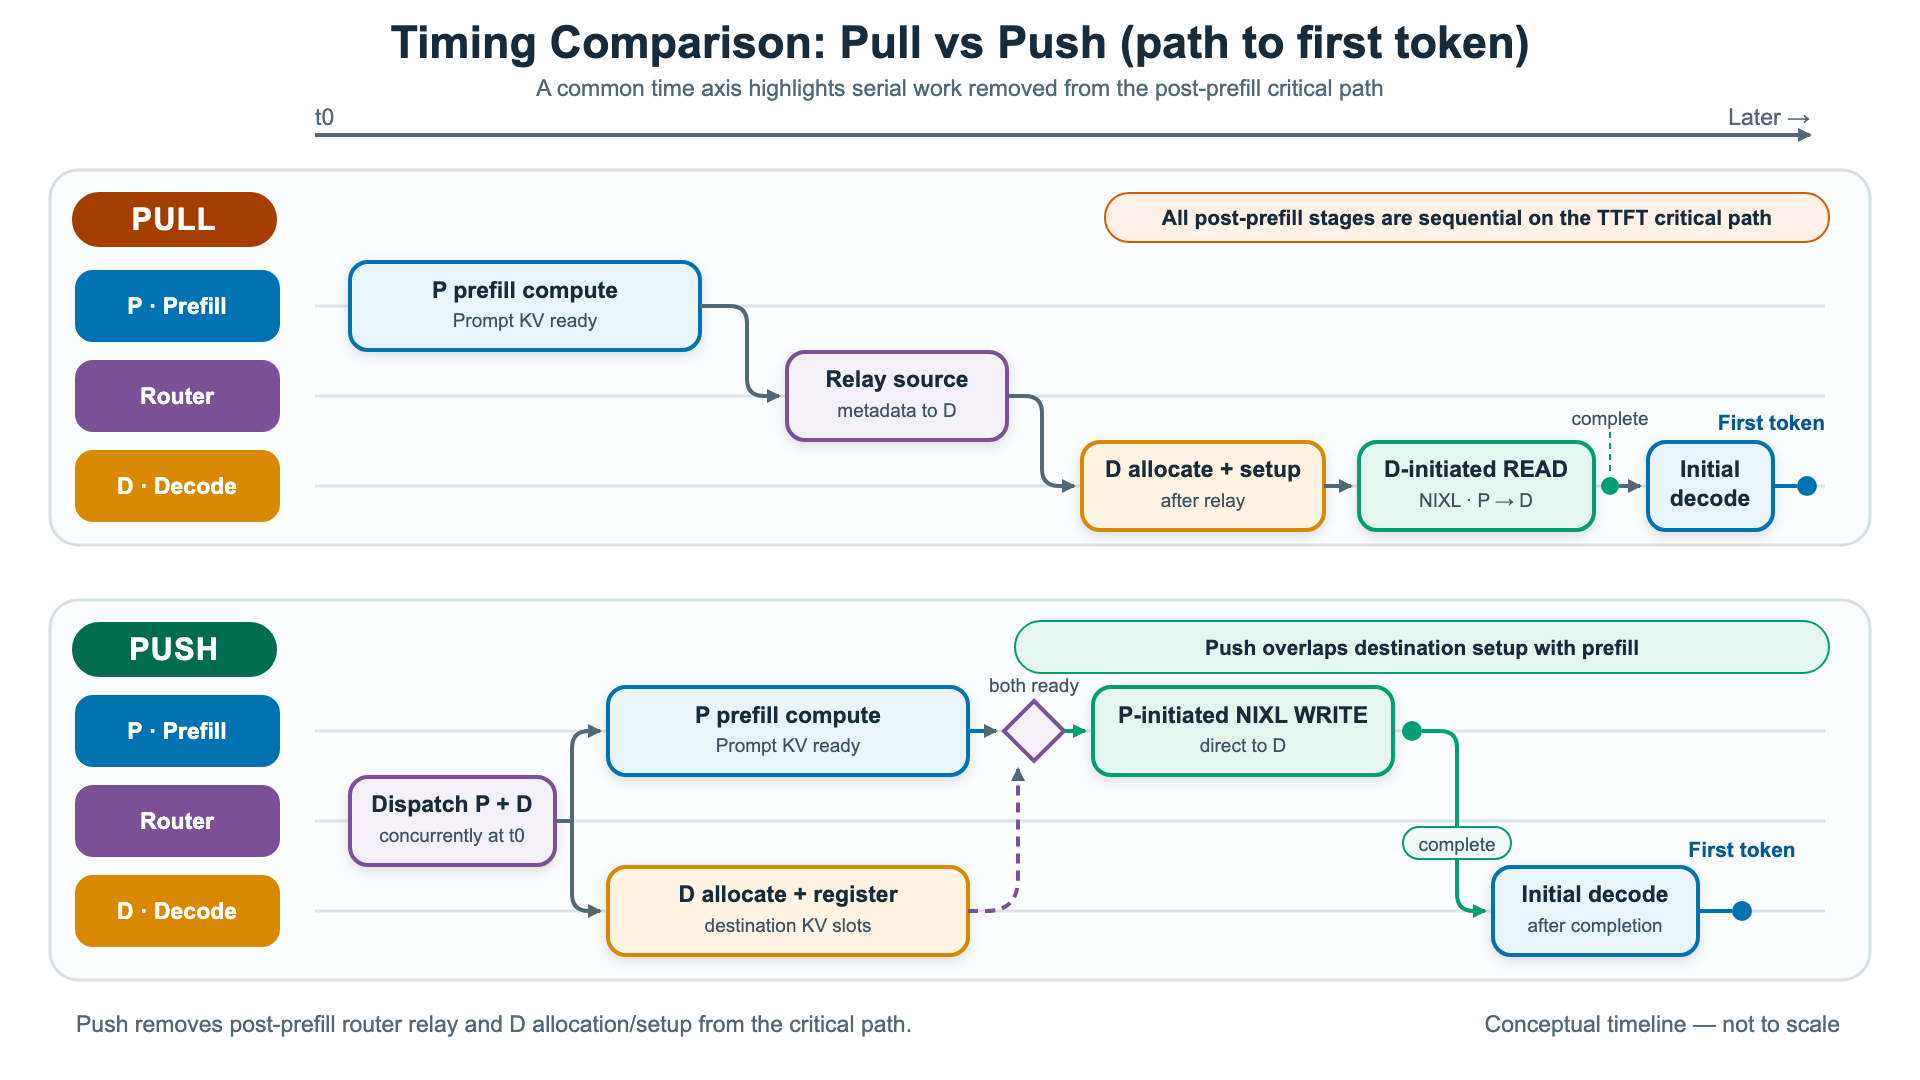
vLLM 通过 NVIDIA 的 Inference Xfer Library(NIXL)连接器完成这次传输,把 KV 块搬过 AWS EFA 这类支持 RDMA 的互连。默认模式是「拉」:prefill 完成后,路由把源端块元数据转给 decode 端,decode 端再分配目标块、准备传输描述符,最后发起 NIXL READ 拉取数据。问题在于,转发、分配、准备全部发生在 prefill 之后、decode 之前,串行地伸长在首 token 的关键路径上,高请求速率下代价会被放大。
Push 架构:先注册,后推送
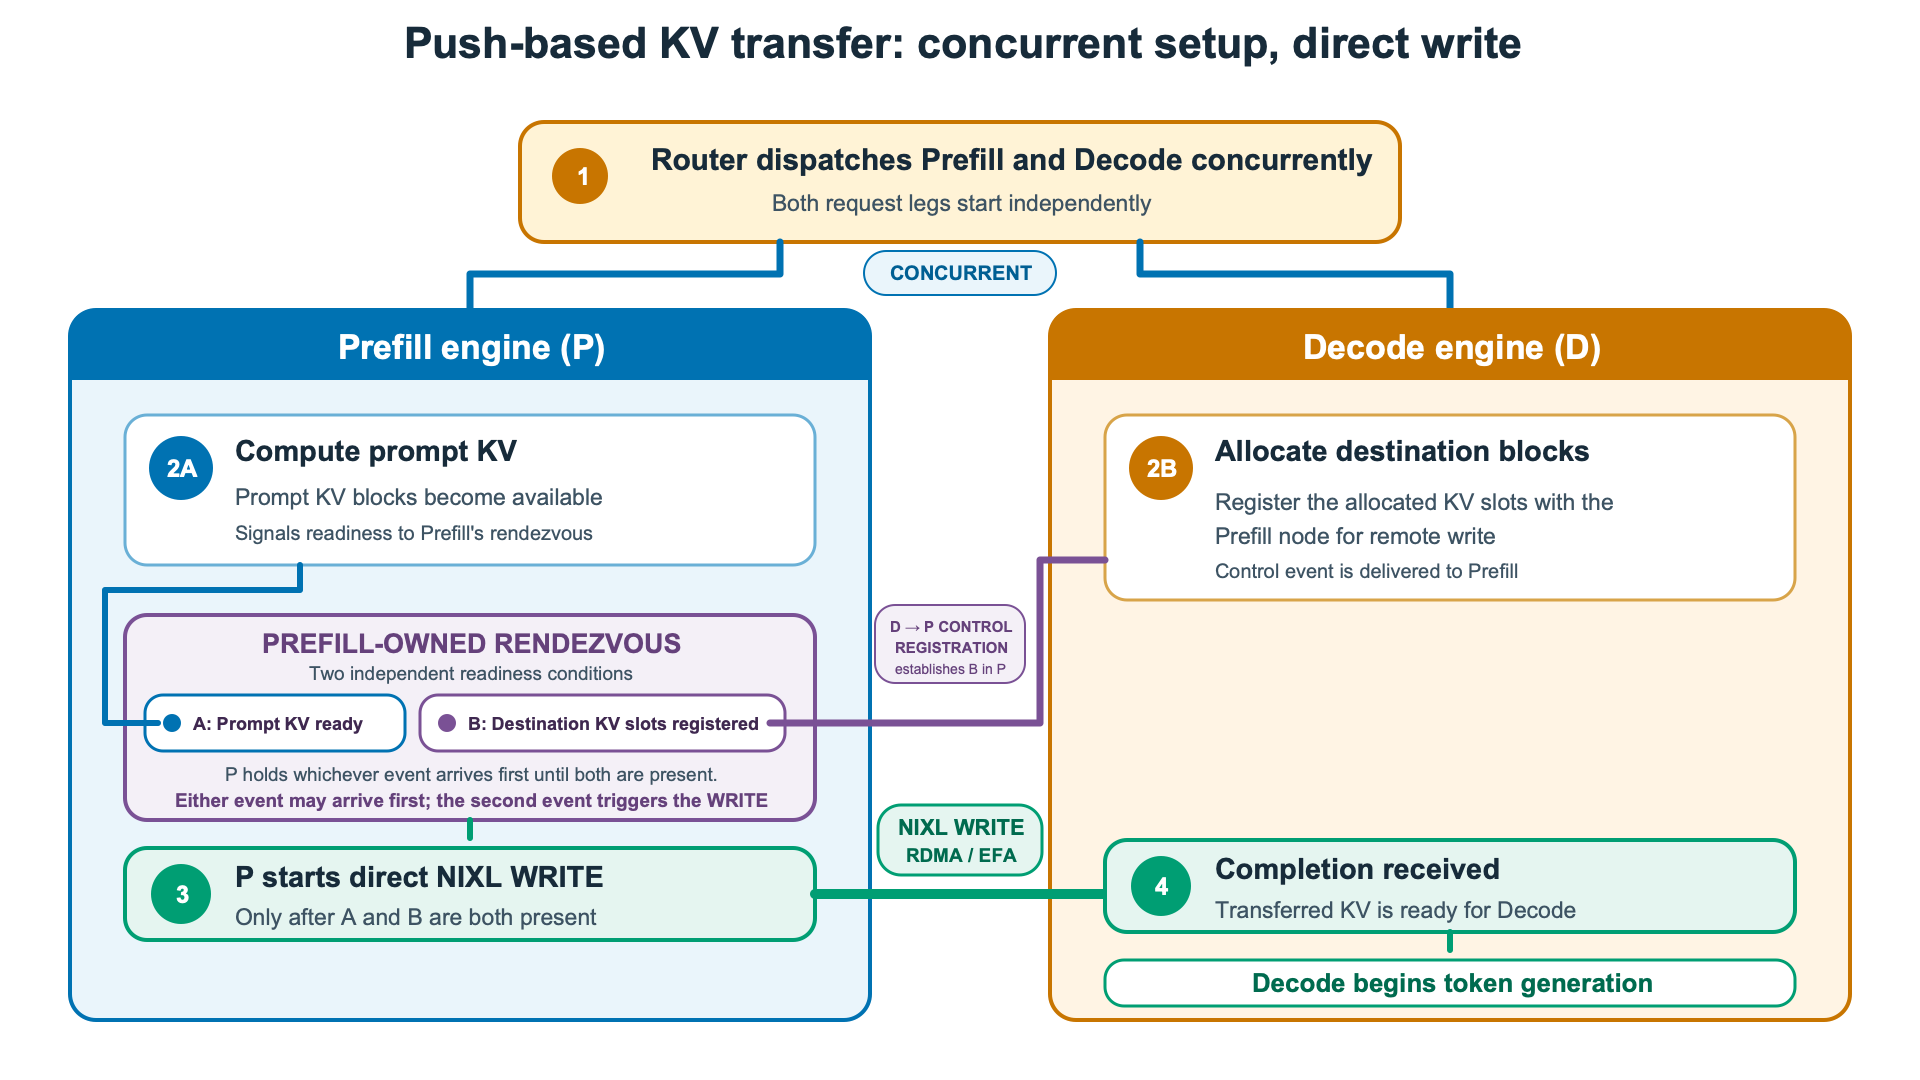
AWS 和 Mistral 的工程师给 vLLM 贡献了一个 push 版 NIXL 连接器,思路是把「传输协调与设置」移出关键路径。协议分三步。其一,注册:decode 实例为需要远端 prefill 的请求分配本地块后,立即通过 NIXL 通知把包含写入位置信息的注册发给 prefill 实例,prefill 端在算完前就知道该写到哪里。其二,会合:注册与 prefill 完成谁先到都可以,后到的事件触发传输;请求按标识匹配,能正确处理被抢占、重试的请求。其三,传输:prefill 端发起 NIXL WRITE,把 KV 块直接写进 decode 端注册好的内存,两端块布局可以不同;decode 端按生产者 rank 逐一计数完成通知,全部到齐才进入解码。
线程模型:传输准备挪到后台线程
为了不阻塞模型执行,push 连接器在每个 prefill worker 上开一条专用后台传输线程:decode 主循环分配并注册块的同时,prefill 主循环在算提示词的 KV 缓存;两者就绪后,主循环把 KV 块交给后台线程并立刻返回继续跑模型,由后台线程负责建立 NIXL 连接、把块 ID 映射成内存描述符、合并连续块为大传输区域并提交 WRITE。这样每个请求的准备开销不再卡住延迟敏感的主循环。
实测:TTFT 最多降 3 倍
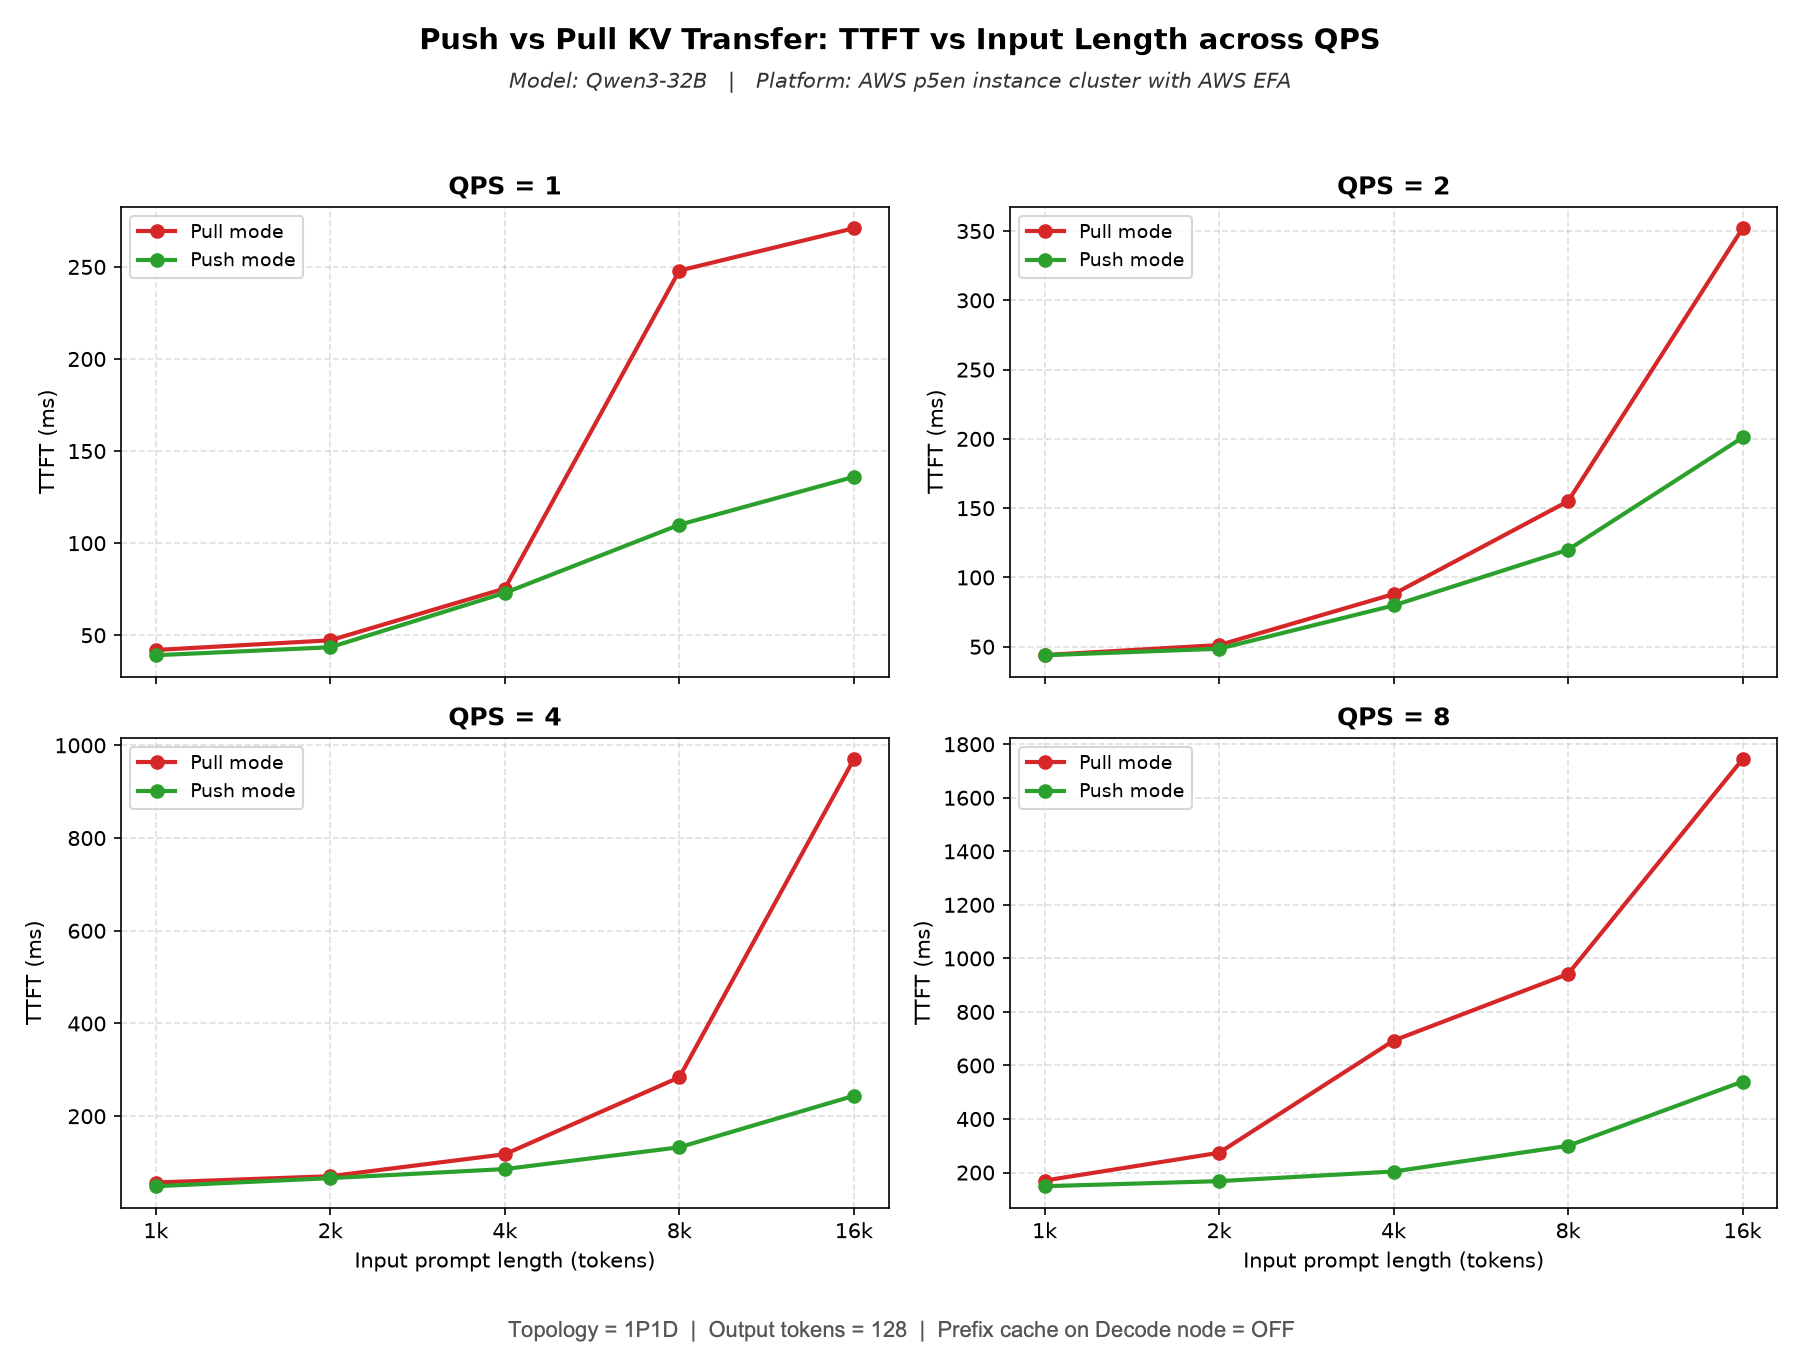
团队在两台经 EFA 组网的 Amazon EC2 P5en(8×H200)实例上部署 Qwen3-32B,1P1D 拓扑,关闭前缀缓存保证每个请求都完整传一遍 KV,扫描 1k–16k 输入长度与 1–8 QPS。低负载短提示下两种模式几乎持平;负载和输入变长后 pull 急剧劣化:8 QPS、16k 输入时 TTFT 约 1744 ms,push 只有约 540 ms,约 3 倍改进;TPOT 也从约 10.4 ms 降到 7 ms 附近,约 30% 提升。根源是 pull 在 decode worker 的引擎循环里同步地写 NIXL 描述符,会卡住 token 生成,而 push 把这部分挪进了后台线程。
Push 与 Pull 怎么选
这个特性与加速器无关:先在 AWS Trainium 集群上构建验证,再贡献进 vLLM;文中的结果来自 GPU 集群,说明收益同样适用于 GPU。路由上有个取舍:pull 允许路由在 prefill 完成后才选 decode 实例,利于负载感知路由和 QoS 管理;push 则提前选定 decode 实例,让设置与 prefill 重叠,换来同负载下 prefill 端更早释放 KV 块。使用时只需把 prefill 与 decode 两侧的连接器换成 NixlPushConnector。团队还提了 PR,想把后台线程模型带回 pull 连接器。若你的场景以低 TTFT 为第一优先级、且接受提前选 decode,push 值得上;需要双向 KV 传输、或要为负载感知路由保留选择空间时,pull 仍是更稳的选择。
小夏点评
- 关键路径思维是这篇文章的核心方法论:push 与 pull 的差别不在「传得更快」,而在协调步骤放在哪里——只要在关键路径上,毫秒都贵。这个思路同样适用于网关路由、缓存预热、你手上任何一条分布式链路。
- 线程模型常常比算法更值钱。本文的性能差距不是换了网络协议,而是把同步活挪进后台线程。调优时先检查「能异步的活是不是在同步做」,往往比换 kernel 更快见效。
- 开源生态的共创在加速。AWS 和 Mistral 联合把生产环境验证过的特性贡献进 vLLM,云厂商与模型公司正在直接给开源项目「供货」。跟官方博客和 PR 走,是拿到生产级优化经验最快的通道。
对中国 IT 运维者的启示:如果你已经在跑 vLLM P/D 分离,可以直接评估 NixlPushConnector——prefill 和 decode 两侧换一下 kv_connector 配置即可,不改代码。两条实操提醒:一是压测时务必关闭前缀缓存,否则 decode 端本地缓存命中会掩盖真实传输性能,对比数据会失真;二是在高 QPS、长提示的场景重点盯 TTFT/TPOT,push 与 pull 的差距在这里最大,也正是业务放量后的瓶颈窗口。若集群暂无 RDMA,也可以先在普通网络上验证「把准备工作移出关键路径」的收益,将来上 RDMA 只会更好。