Modular MAX 推理性能超越 vLLM 5.5 倍:Kimi K2.5 基准测试深度解析
Modular 在 MLSys 2026 大会上公布其 MAX 推理栈在 Nvidia B200 GPU 上运行 Kimi-K2.5 模型时,P50 首个 token 生成时间比 vLLM 快 5.5 倍。推理成本已超越训练成本成为企业关注焦点,Modular 试图用统一编译器栈打破硬件厂商锁定。

Share Life
Modular 在 MLSys 2026 大会上公布其 MAX 推理栈在 Nvidia B200 GPU 上运行 Kimi-K2.5 模型时,P50 首个 token 生成时间比 vLLM 快 5.5 倍。推理成本已超越训练成本成为企业关注焦点,Modular 试图用统一编译器栈打破硬件厂商锁定。
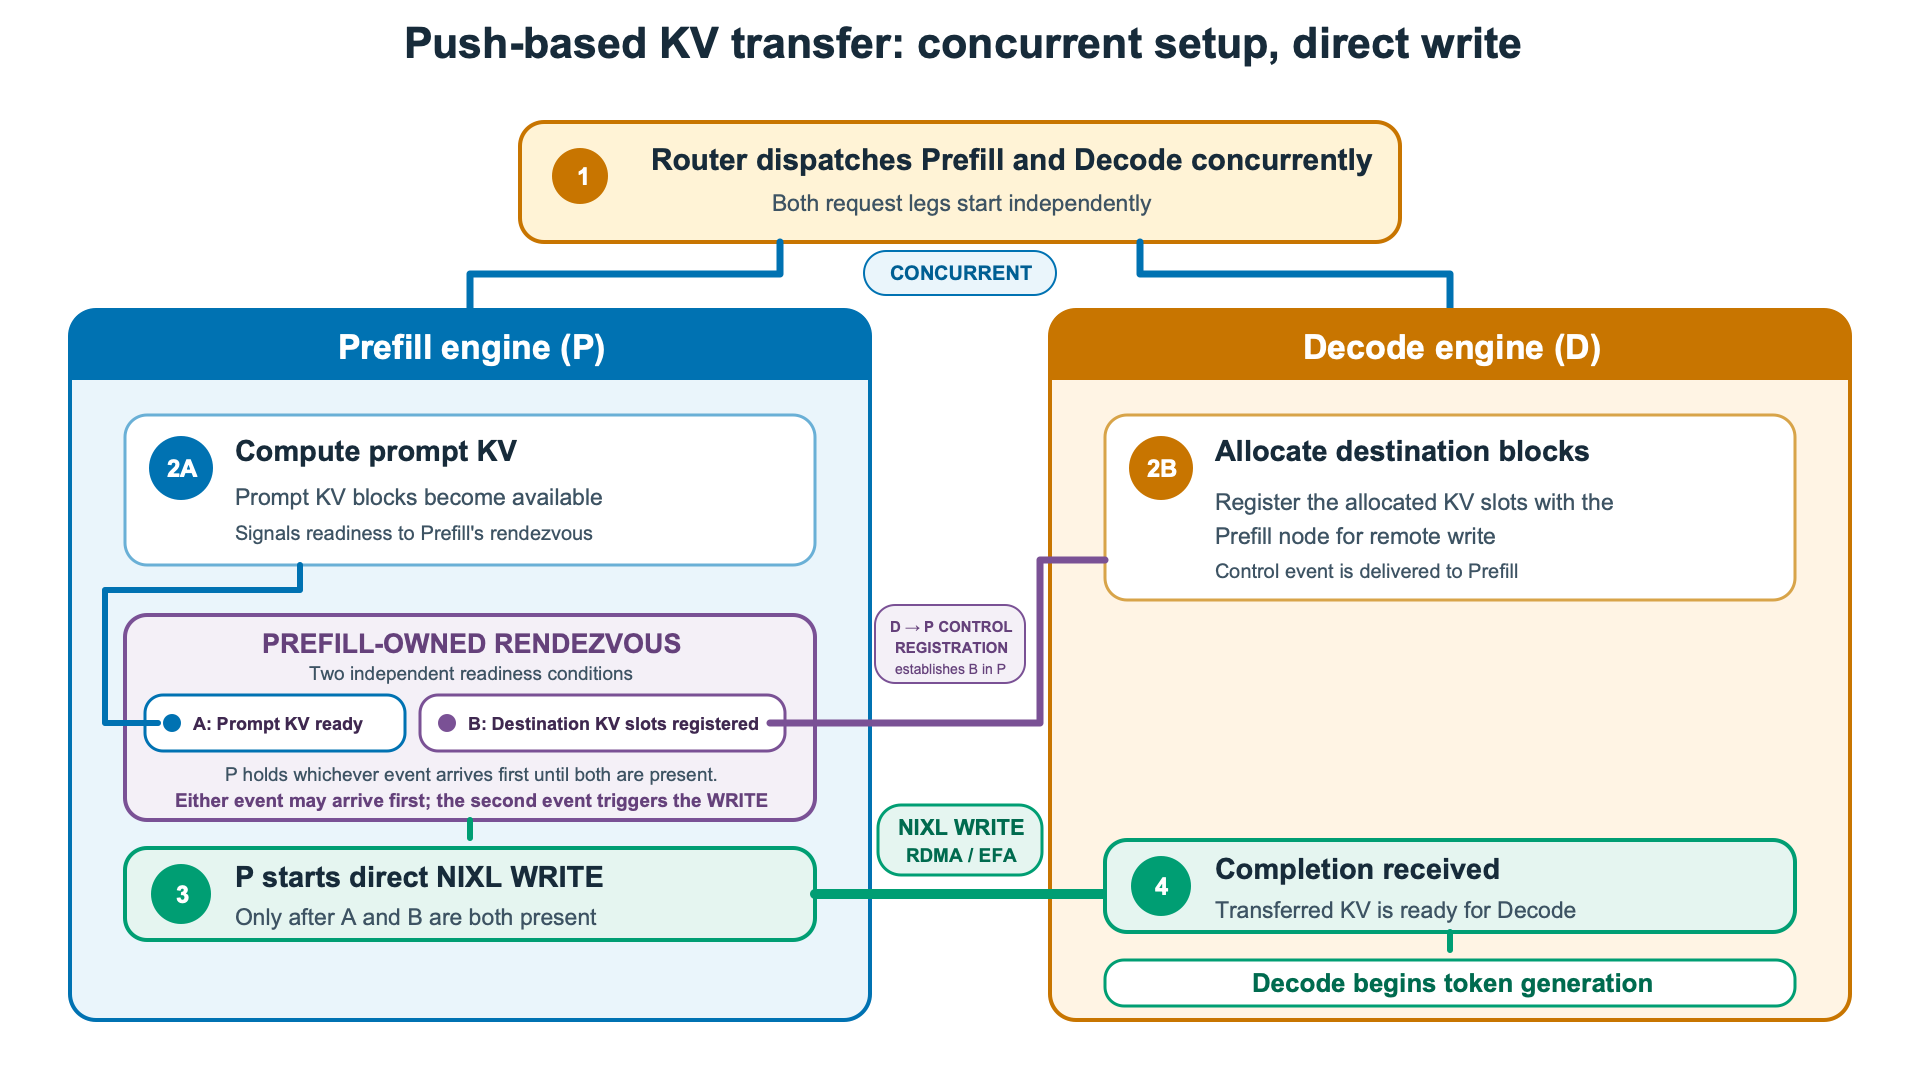
vLLM 新增 push 式 NIXL KV 传输连接器:decode 端预注册目标块,prefill 端算完提示词后通过后台线程直接推送 KV,把拉取路径上的串行协调与设置移出首 token 关键路径。Qwen3-32B 1P1D 部署实测,高并发长提示下 TTFT 最多改善 3 倍,TPOT 提升约 30%。
在H100 80GB上对比vLLM、TensorRT-LLM和SGLang三大推理引擎:TensorRT-LLM吞吐量领先13%但需28分钟编译;vLLM支持最广冷启动最快;SGLang的RadixAttention在共享前缀场景下有独特优势。选型建议按prefix overlap比例决策。
Speculative Decoding 是 2026 年 LLM 推理服务的核心加速技术:用小模型先猜 4 个 token,大模型一次并行验证,接受率 ~50% 时单步生成 3 个 token,输出质量零损失(数学证明等价于原始大模型采样)。和 PagedAttention 叠加可让 Llama 70B 服务吞吐提升 8-14×。
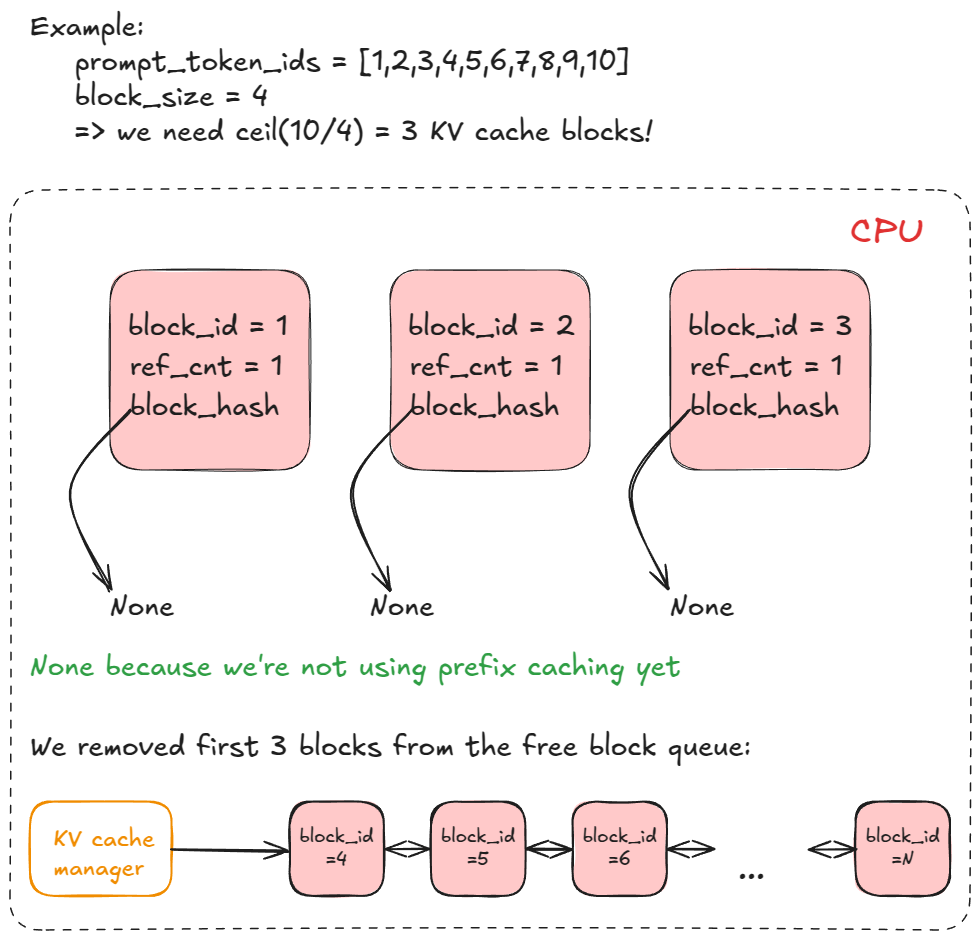
vLLM 凭什么一张 24GB 显卡顶住 30+ 路并发?靠 PagedAttention 把 OS 虚拟内存思想搬进 GPU,KV cache 从连续大块变可分散小块;连续批处理把 GPU 利用率从 30% 拉到 80%+。本文扒 vLLM 官方博客 + SOSP 论文讲清双引擎原理 + 实测性能。
2026 推理引擎百花齐放,vLLM / llama.cpp / TensorRT-LLM / NInfer 各自站位不同。本篇用同一台 4×H100 + Llama-3.3 70B FP8 把四条赛道横向对比:吞吐、TTFT、上下文、硬件覆盖、部署难度、冷启动,再给出四个具体场景的选型建议,10 分钟内帮你挑到合适的引擎。
狗云服务器优惠