Speculative Decoding 深度解析:小模型猜 + 大模型验,零损失 3× 加速
2026 年的大模型推理服务,除了 vLLM 的 PagedAttention 和连续批处理,还有一个”必杀技”——Speculative Decoding(投机解码)。它用一个**小模型先猜几个 token**,再用**大模型一次验证**,让原本一次只生成 1 个 token 的自回归过程,**单步生成 3-5 个 token**,但输出质量零损失。
这个 2018 年由 Stern 提出的、2023 年被 DeepMind 形式化的技术,今天已经成了 vLLM、TGI、TensorRT-LLM 的默认加速选项。本文扒 NVIDIA 官方博客和 BentoML 工程实践,把投机解码的原理、为什么无损、以及生产环境的真实收益讲清楚——以及它和 PagedAttention 怎么配合,把 24GB 显卡的服务能力再拉一档。
一、为什么 LLM 推理慢
Transformer 推理是自回归的——每生成一个新 token,都要等前一个 token 计算完。GPU 在这一步只能做 B × 1 的矩阵乘(B 是 batch size),大量算力浪费在”等上一个结果出来”的串行依赖上。这就是为什么 GPU 显存装得满满的、利用率却只有 30-40% 的根本原因。
如果能让 GPU 一次算 5 个 token 而不是 1 个,理论速度就是 5×。但问题是:你不知道要生成什么 token——只有把前一个算出来才能算下一个。投机解码的突破口就是:让一个便宜的小模型先猜,再用大模型并行验证。
二、投机解码的核心:draft-then-verify
投机解码分两步走:
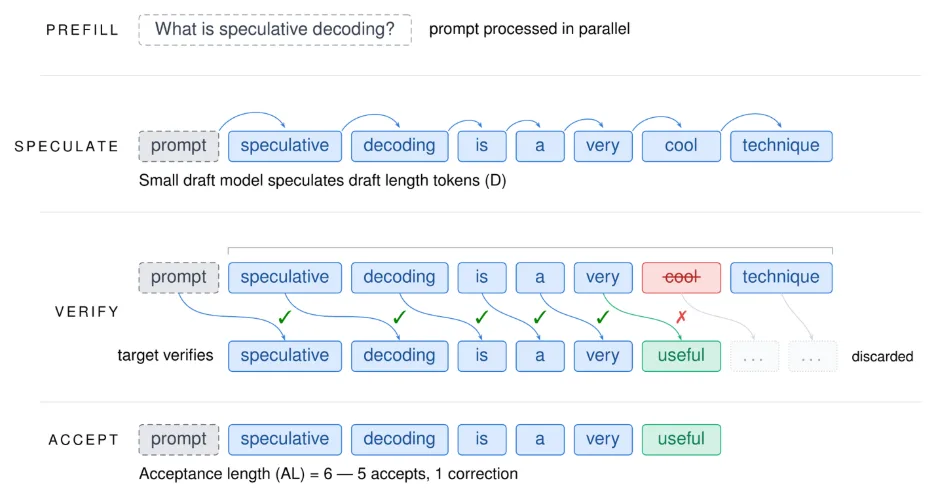
1. Draft(小模型猜):用一个参数量小 5-20 倍的 draft model(比如 7B 配 1B),基于当前上下文快速生成 K 个候选 token(比如 K=4)。这一步很快,因为小模型便宜。
2. Verify(大模型验):把 draft 出来的 K 个 token 打包成一次 forward pass,让大模型并行验证。大模型的注意力机制天然支持一次看多个位置(casual mask 仍然成立),所以一次就能验证 K 个 token,接受其中正确的、丢弃错误的。
关键洞察:验证比生成便宜得多。生成需要逐个串行,验证可以一次并行。所以”小模型猜 + 大模型一次验”在大多数情况下都比”大模型逐个生成”快。
三、为什么输出质量零损失
投机解码最神奇的地方是——它数学上等价于原始的大模型采样。这个证明来自 DeepMind 2023 年的 speculative sampling 论文:
大模型对每个候选 token 算一个接受概率。如果 draft 的 token 概率 ≥ 大模型的接受概率,接受;否则按某种分布拒绝并替换为大模型的采样。这个过程等价于从大模型的原始分布采样,所以输出分布与直接用大模型完全一致。
这意味着:速度提升 2-4×,输出质量/多样性/随机性都零损失。和量化(牺牲精度换速度)不同,投机解码是真正的”免费午餐”。
四、速度提升的关键参数
实际收益取决于三个参数:
- 接受率(acceptance rate):draft 猜对的 token 占比。接受率越高,K 个 token 里被接受的越多,平均每个 decode 步生成的 token 数越多。代码任务接受率高(~50%),创意写作低(~30%)
- draft 长度 K:K 越大潜在收益越高,但 K 太大时后面的 token 接受率暴跌(draft model 越猜越不准)。sweet spot 通常 K=4-5
- draft 模型大小:越小越快,但太小了质量差、接受率低。一般选 5-20× 小的模型
生产环境典型数据(vLLM + NVIDIA H100 + Llama 70B + Llama 7B draft):
- 短对话场景:2.5-3× 加速,接受率 ~45%
- 代码补全:3-4× 加速,接受率 ~55%(代码模式强)
- 长文档摘要:1.8-2.5× 加速,接受率 ~35%(长上下文累积误差)
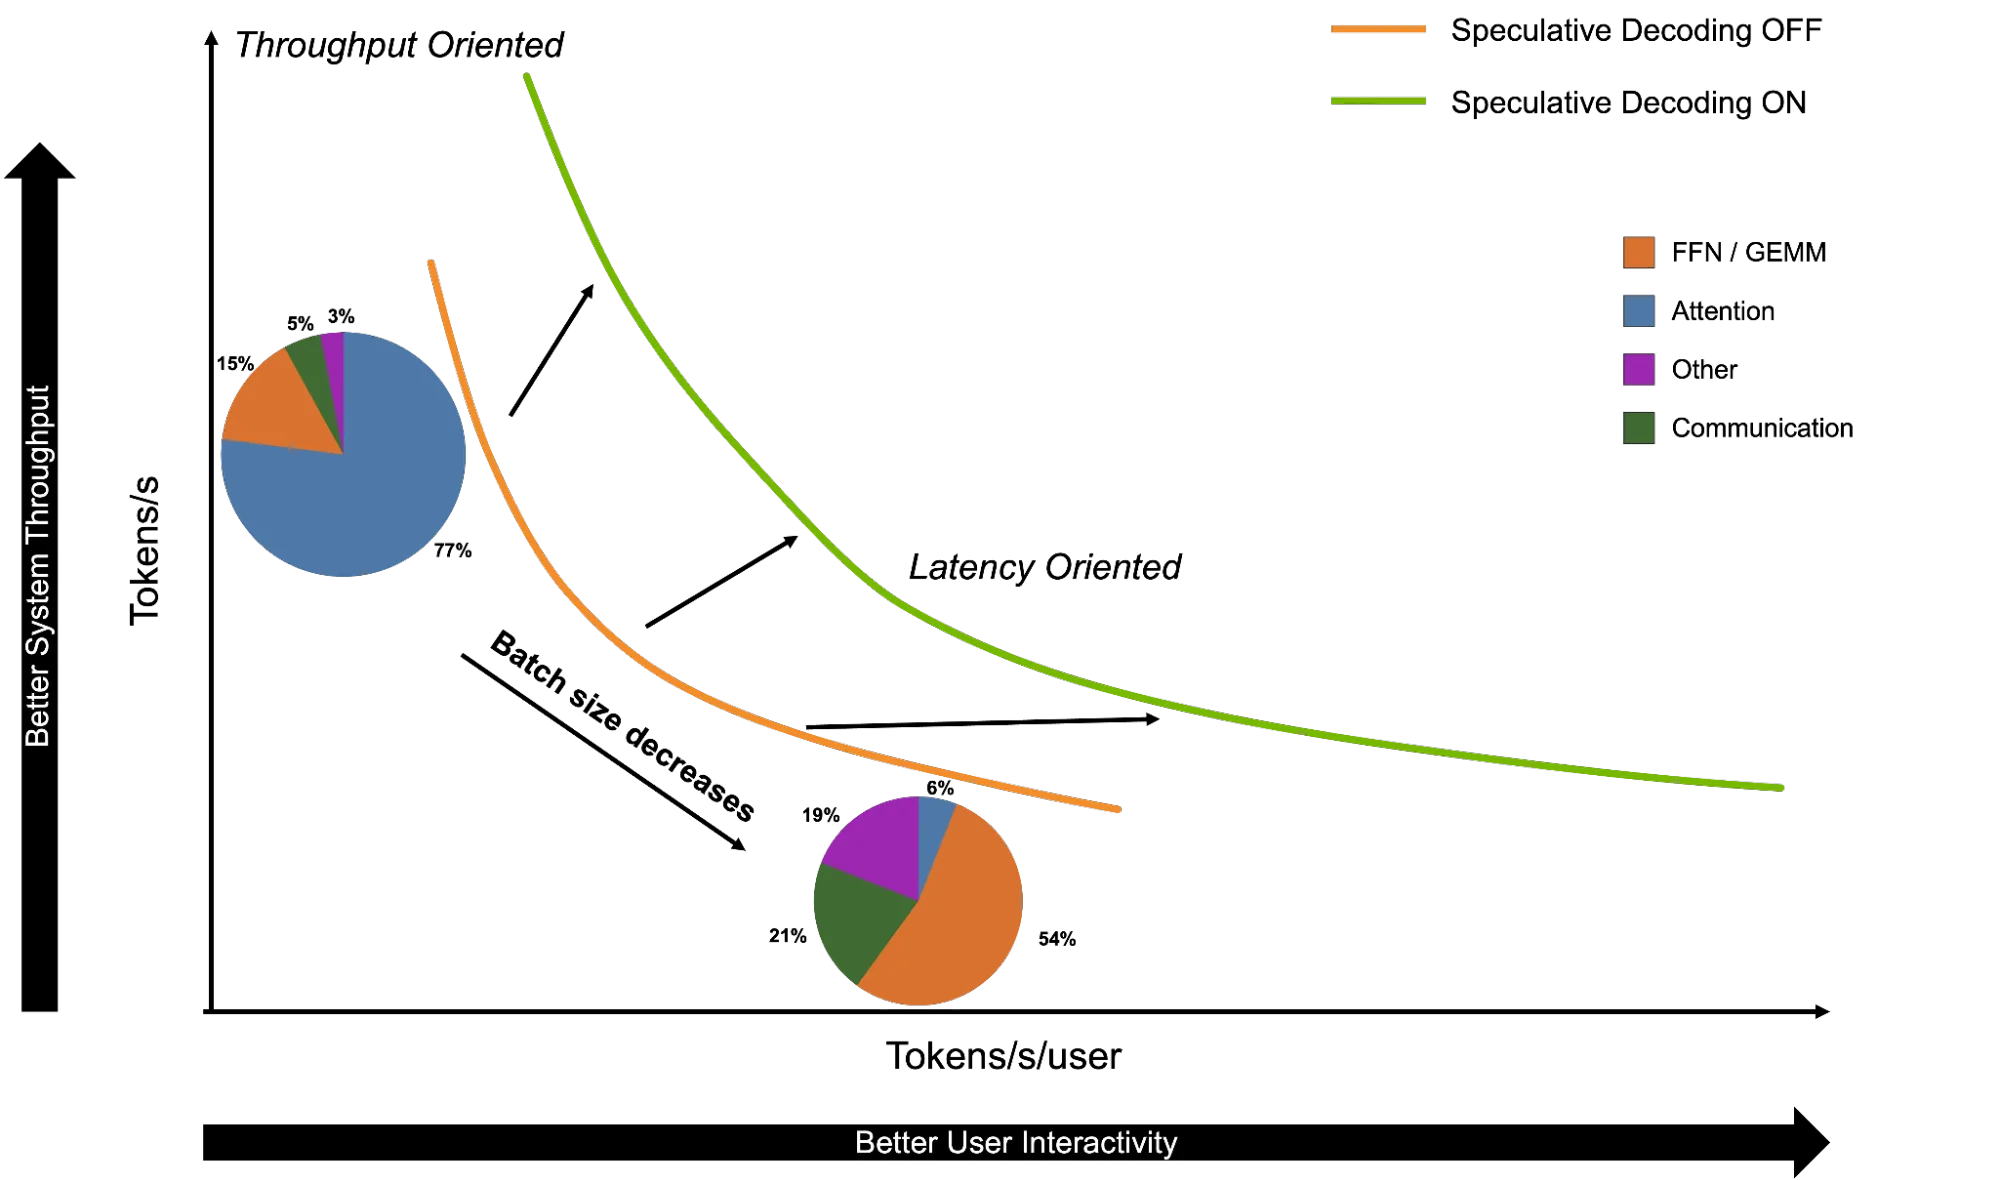
- 批处理场景:1.5-2× 加速(batching 已经把 GPU 喂饱了,投机空间小)
五、和 PagedAttention 配合:1+1>2
投机解码和 PagedAttention 不是替代关系,是叠加关系:
- PagedAttention 解决的是显存碎片,让 batch 装得下更多请求
- 投机解码解决的是每个请求本身的延迟,让每个请求生成得更快
两者叠加的典型效果:在 1×A100 80GB 上跑 Llama 70B,相比裸 HuggingFace Transformers:总吞吐提升 8-14×(PagedAttention ~3-4×、投机解码 ~2-3×,相乘)。这就是 vLLM 在 2026 年成为事实标准的原因——所有主流推理优化都打包好了,开箱即用。
六、小夏点评
看完投机解码的设计,最让我感慨的是“草稿+验证”这个古老思想在 AI 时代的复活。CPU 里早就用了——分支预测就是猜下一条指令、猜错就回滚。操作系统里也用了——page prefetch 就是猜下一页要用。LLM 的投机解码是这个思想的 LLM 版本:用便宜的不准确猜测 + 贵的准确验证,换整体加速。
对刚哥这种自建机柜的朋友,投机解码是 2026 年最值得开启的”最后一公里”优化。PagedAttention 和连续批处理已经在 vLLM 默认开了,但投机解码还要手动配置 draft model——推荐选一个同系列的 5-10× 小的模型做 draft(比如 70B 配 7B),开 2-3× 加速是稳稳的。
七、给读者的实操建议
- 个人开发者:vLLM 0.6+ 默认支持 speculative decoding,开箱即用。试试 7B + 1B draft 的组合,单机延迟能砍 40-60%
- 小企业/团队:vLLM + 投机解码 + PagedAttention 双开,1 张 A100 就能顶过去 4 张的服务量
- 大流量生产:投机解码对单请求延迟敏感的场景(聊天、代码补全)效果最明显;批处理高并发场景收益小
- draft 模型选择:选同系列的 5-10× 小的模型。比如 Llama 70B 配 Llama 8B,Qwen 72B 配 Qwen 7B
- 注意质量检查:虽然数学证明无损,但实际工程实现可能有 bug。生产前用一批测试 prompt 验证输出分布没漂移
投机解码是 2026 年大模型推理优化工具箱里”最被低估”的一把武器——它不牺牲质量、不增加显存、只要一个 draft model 就能拿到 2-3× 加速。和 PagedAttention 配合使用,是 2026 年 LLM 服务性能优化的”标准配方”。