PagedAttention 深度解析:vLLM 连续批处理与显存分页的工程奇迹
2026 年的大模型推理服务领域,vLLM 几乎成了事实标准。它能在一张 24GB 消费级显卡上同时服务几十路并发请求,关键不是算力更快,而是它用了一个来自操作系统教科书的经典思想——分页(Paging),把 GPU 显存里那块难缠的 KV cache 从”连续大块”变成了”可分散的小块”。
这个叫 PagedAttention 的机制,加上配套的连续批处理(Continuous Batching),让 vLLM 相比传统的静态批处理实现了 2-4× 的吞吐提升。本文扒开 vLLM 官方源码和 SOSP 2023 的原始论文,把这两个核心机制讲清楚——包括它解决的具体问题、工程实现的关键 trick、以及实际生产环境的性能数据。
一、传统 KV cache 管理的痛点
要理解 PagedAttention 的价值,先看它解决的是什么问题。LLM 推理时,每生成一个 token 都要把之前所有 token 的 Key 和 Value 矩阵缓存在 GPU 显存里(即”KV cache”)。一个 13B 模型在 A100-40GB 上,33% 的显存被 KV cache 占用,剩下 65% 才是模型参数本身。
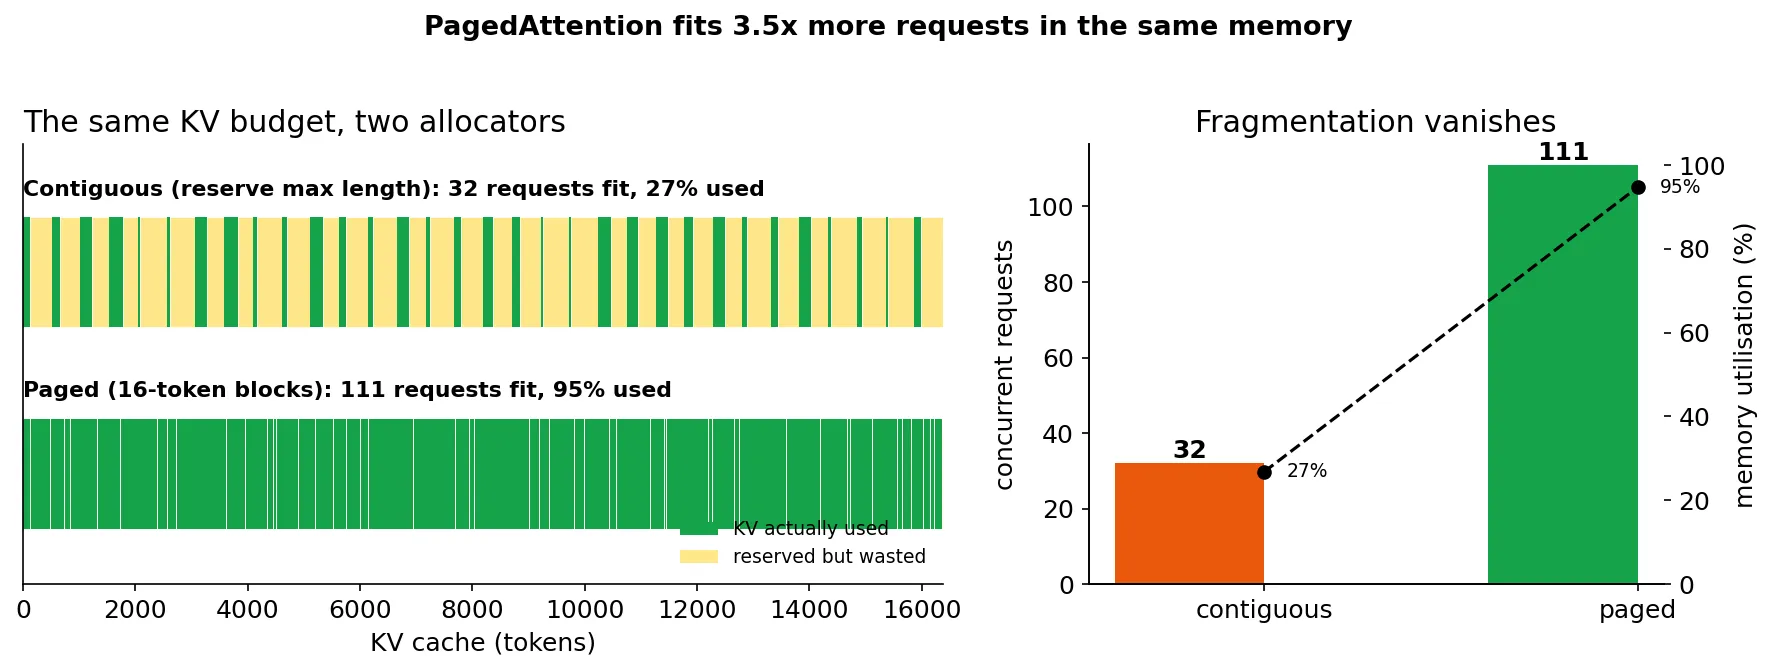
传统的服务框架(HuggingFace Transformers、原生 FasterTransformer)把每个请求的 KV cache 当作一块连续大内存预分配。这种做法有三个致命问题:
- 内部碎片——系统按”最长序列长度”预分配,但 90% 的请求实际只用了 30%,浪费严重
- 外部碎片——不同长度的请求交错分配,显存被切成不连续的零碎空间
- 无法共享——多个请求如果有相同的前缀(比如同一 system prompt),KV cache 完全无法复用,每份都独立存储
实测下来,传统框架 60-80% 的 padding 开销都来自 KV cache 管理——这意味着花大价钱买的 H100 实际有 30-40% 的时间在空转。
二、PagedAttention:把虚拟内存思想搬进 GPU
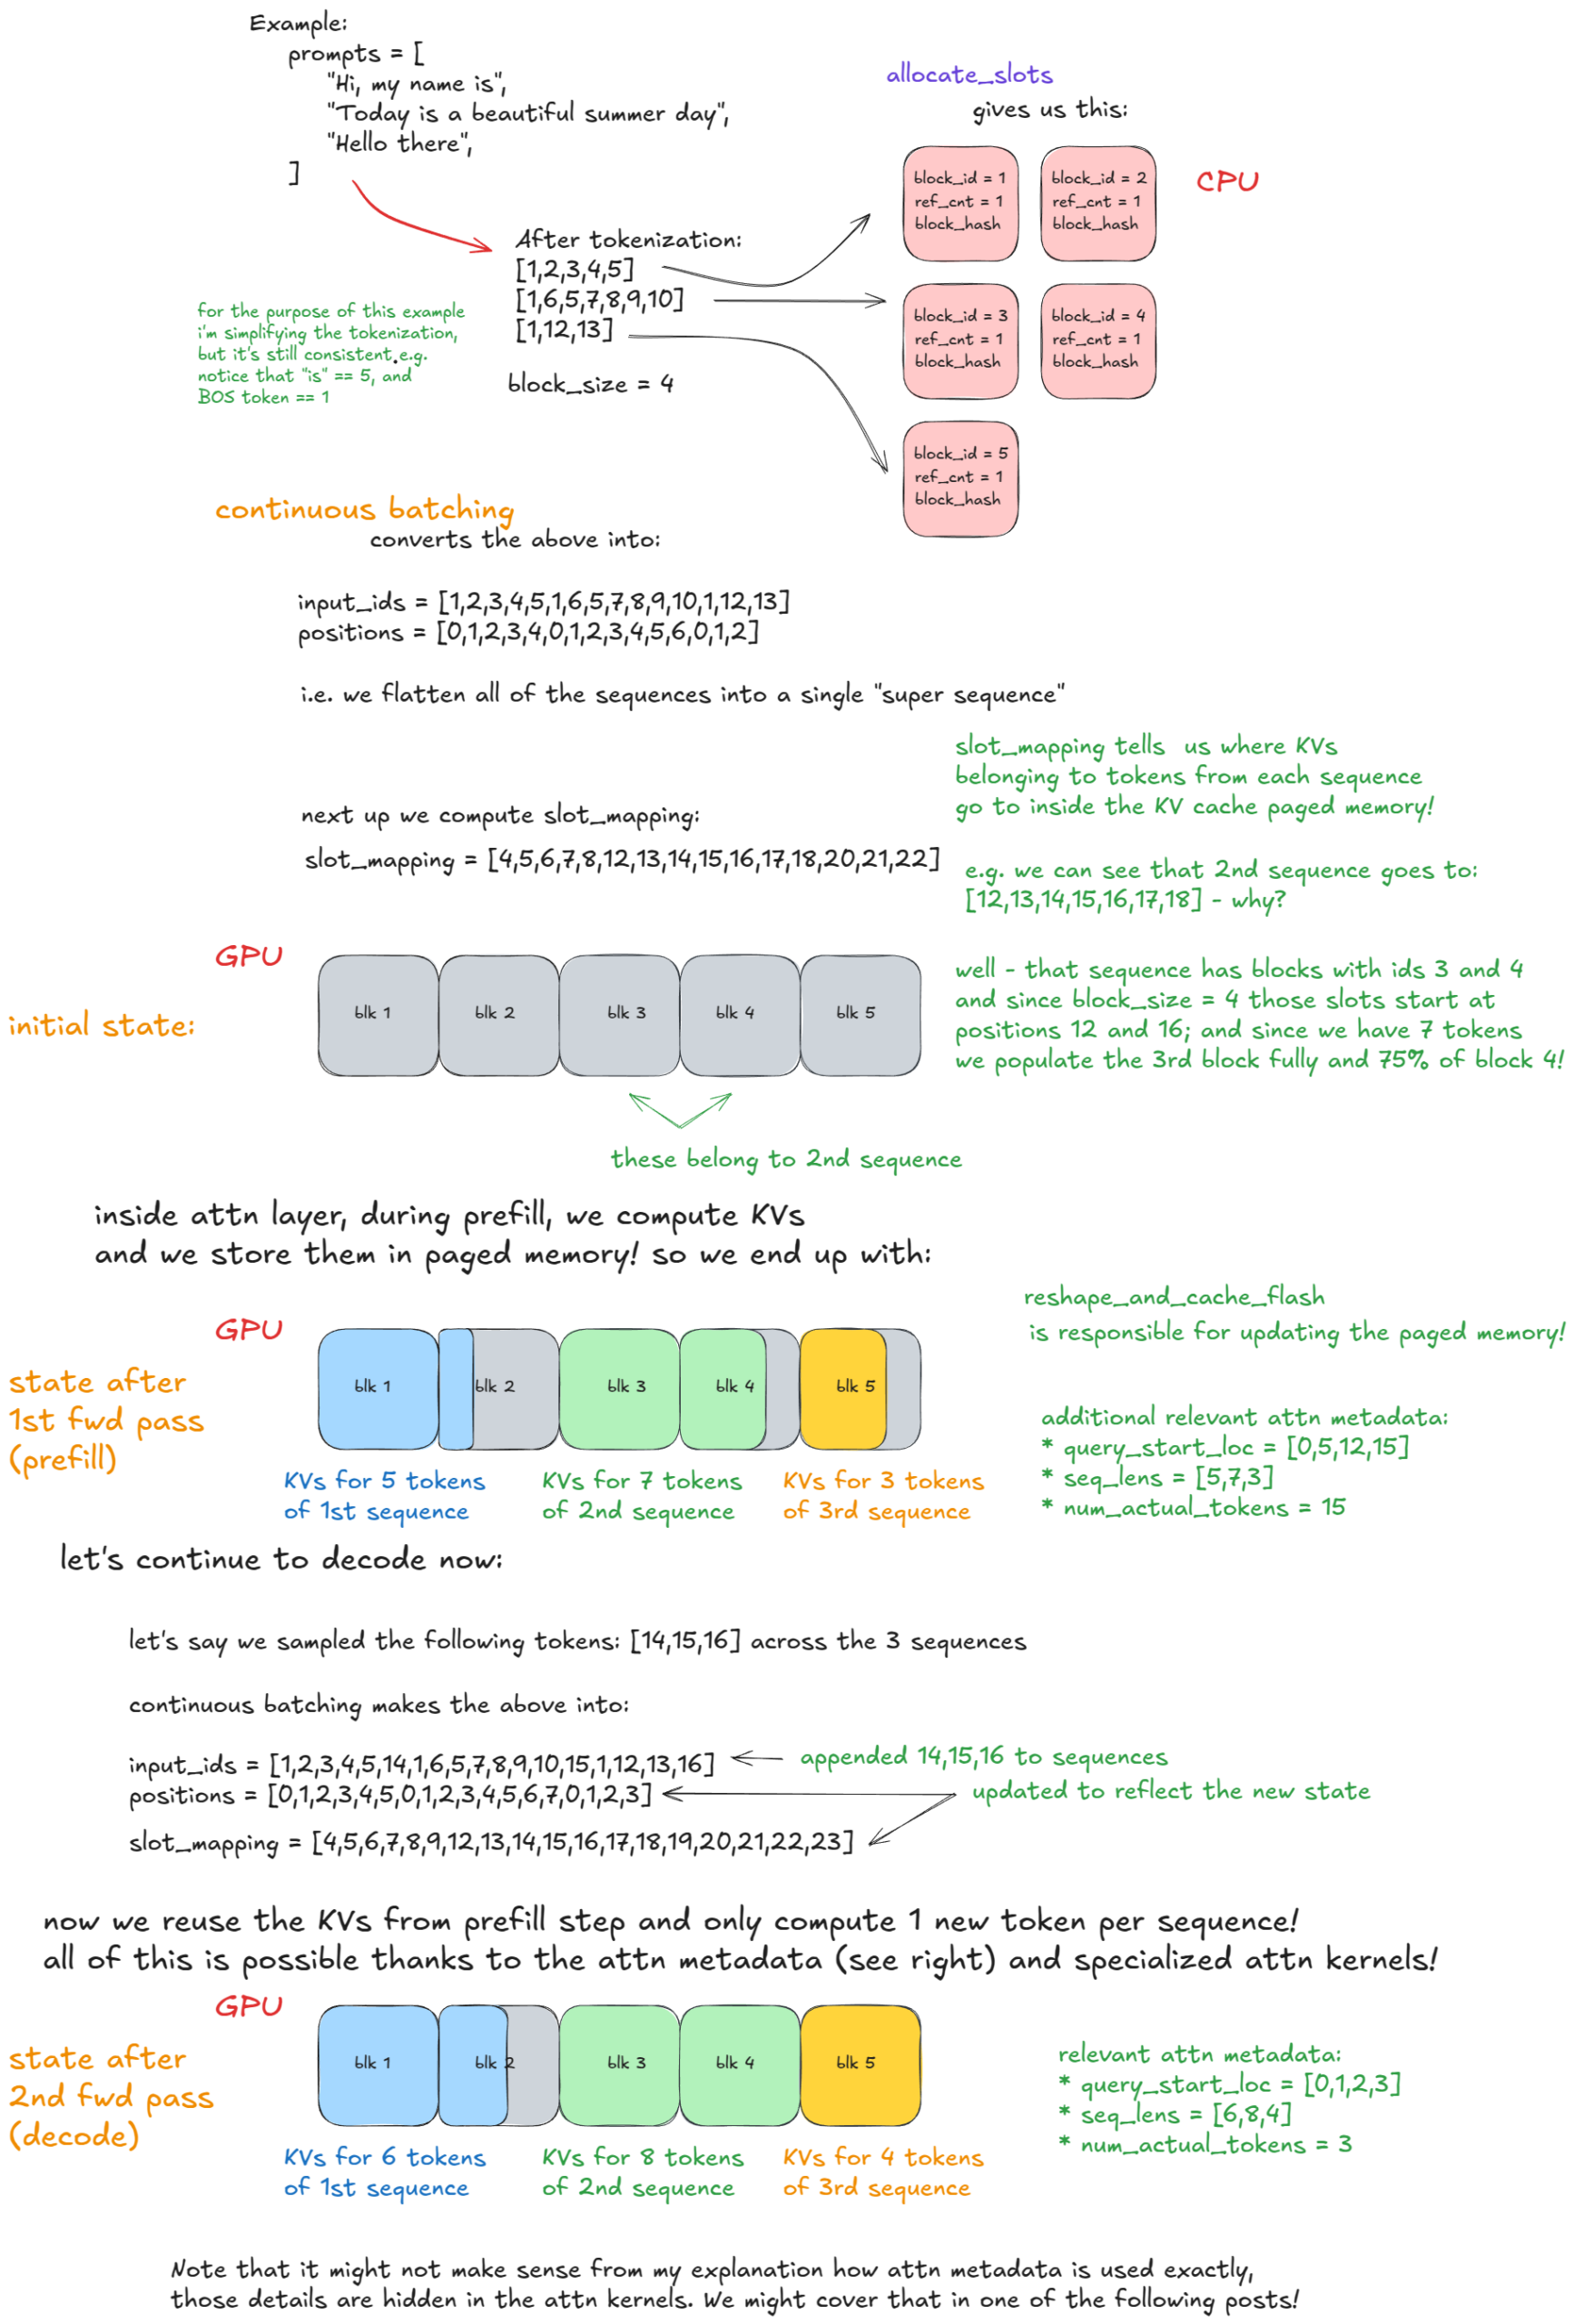
PagedAttention 的核心灵感来自操作系统的虚拟内存与分页机制——既然 OS 能让每个进程以为自己独享连续内存、而物理上其实分散在各个页面框里,那 GPU 显存也能这么干。具体做法:
1. 把 KV cache 切成固定大小的”块”(block)——通常是每个块装 16 个 token 的 K/V 数据。一个 100 token 的请求就被切成 7 个块(B0 到 B6)。
2. 给每个请求维护一张”块表”(block table)——这是逻辑块号到物理块号的映射表。比如逻辑块 0-6 可能映射到物理位置 5、2、7、0、12、3、9——逻辑连续、物理分散。
3. 块表让 AI 模型保持”连续内存”的幻觉——attention 计算时,CUDA kernel 通过块表把分散的物理块拼起来,模型不需要知道自己用的是”页式存储”。
这个设计直接消灭了外部碎片(块小且固定,哪里有空塞哪里),把内部碎片降到 16 token 级别(一个块的大小),还顺便支持了prefix sharing——多个请求共享同一前缀时,块表指向同一组物理块,零拷贝共享。
三、连续批处理:把 GPU 喂饱
PagedAttention 解决了内存问题,但 GPU 利用率还需要另一个机制——连续批处理(Continuous Batching)。
传统的静态批处理:把 N 个请求打包成一个 batch,等整个 batch 跑完(最长的请求生成完所有 token)才开始下一批。问题显而易见——batch 里的短请求早生成完了,但 GPU 还在等那个最长的请求,其他槽位全在空转。生产数据显示padding 开销 60-80%。
连续批处理把”批次”从”请求级”降到”迭代级”——每 decode 一步(一个 token)就重新组 batch:
- 每一步调度器检查哪些请求刚完成、哪些新请求在排队
- 完成的请求立即从 batch 里撤出,空出的槽位立刻塞进新请求
- GPU 几乎每个 decode 步骤都是满载的——这就是把吞吐从 ~30% 拉到 80%+ 的关键
vLLM、TGI、TensorRT-LLM 都实现了连续批处理,名字不同(vLLM 叫 continuous batching,TGI 叫 dynamic batching)但思路一致。PagedAttention + 连续批处理 = vLLM 的核心双引擎。
四、性能数据(实测)
vLLM 官方论文(SOSP 2023)和社区后续 benchmark 在不同硬件、不同模型上反复验证了 PagedAttention + 连续批处理的收益:
- 吞吐量提升:相比 HuggingFace Transformers,同等硬件、同等并发下,吞吐 提升 2-4×(典型场景 ~14× 提升出现在 LLaMA-13B + A100 极端并发场景)
- KV cache 内存效率:内部碎片从 60-80% 降到 < 4%(每块 16 token 的粒度)
- prefix sharing 收益:在多轮对话、批量提示词相似场景下,prefix 共享可省 30-50% 的 KV cache 显存
- TTFT vs TPOT:连续批处理让 TTFT(首个 token 延迟)和 TPOT(每 token 延迟)双双下降,p95 尾延迟砍掉 60%+
- 生产部署:在 1 张 24GB RTX 4090 上,vLLM 可以同时服务 7B 模型的 30-50 路并发请求,GPU 占用 90%+
五、小夏点评
看完 vLLM 的架构,最让我感慨的是计算机科学基础理论的”跨时代复用”。分页是 1960 年代 OS 教科书里的概念,CUDA kernel 是 2010 年代的硬件接口,PagedAttention 是 2023 年才发表的论文——三者拼在一起,就解决了 2026 年大模型推理服务的内存瓶颈。好的工程不是发明新东西,是把旧东西用在新场景里。
另一个观察:vLLM 之所以能快速成为事实标准,不是因为它的 attention kernel 比 FlashAttention 更快(实际上 vLLM 在底层调用 FlashAttention-2),而是因为它解决了 90% 的团队都会踩的运维问题——显存碎片和 prefix 共享。这就是”系统级优化”的力量:单点 1.5× 加速不够,把整个 pipeline 调度好才有 4× 提升。
对刚哥这种自己搭机柜的朋友,vLLM 是 2026 年最值得第一时间部署的推理框架。门槛也低——pip install vllm + 一块 24GB 显卡 + 一个 7B 模型,5 分钟就能跑起来生产级服务。
六、给读者的实操建议
- 个人开发者:用 Ollama 或 llama.cpp(CPU/GPU 通用),如果跑 7B 够用就够;如果想跑并发服务,上 vLLM
- 小企业/团队:vLLM + 一张 24GB 显卡起步,7B 模型 30-50 路并发,单卡就能顶住一个部门
- 中型公司:vLLM 多卡 + prefix caching 优化(cache-aware routing),省 30-50% 显存
- 想跑大模型(70B+):vLLM + AWQ/NVFP4 量化(参考我们之前的量化技术专题),24GB 卡也能跑 70B AWQ
- 关注 PagedAttention 之外的优化:chunked prefill、speculative decoding、prefix caching——vLLM 都已经支持,开启它们吞吐还能再涨 30-50%
PagedAttention 是大模型推理服务从”实验室玩具”变成”生产基础设施”的关键一步。理解它的原理,比单纯会用 vLLM API 重要得多——因为下一代推理框架(不管是 MLC-LLM、SGLang 还是 Modular)都站在同一块基石上。