
K8s 节点级 Swap 实战:Local SSD 换内存,Pod 密度最高提升 3 倍
背景:内存瓶颈与 Agent workloads
随着 Agentic AI 工作负载(如 autonomous agents、headless browser runtimes、sandboxed Python 解释器)在 Kubernetes 上大规模落地,内存往往成为首要瓶颈。传统上:
- 内存限值设得过高 → 大量空闲 RAM 浪费成本;
- 设得过低 → 容易触发 OOM,导致 Pod 被强制终止。
这类 burst‑idle 业务的特点是:启动时需要大量内存(加载模型、解释器),随后进入长时间 idle 等待下一次请求。保持这些 idle 页面驻留在物理内存中会显著限制集群密度,增加运维成本。
方案:Node Swap + Local NVMe SSD
Kubernetes 在 v1.34 将节点级 Swap 升级为 GA,配合 cgroup v2 的独立 swap 统计,实现:
- 独立内存 & Swap 配额:cgroup v2 把匿名内存与 swap 分别计数,可为容器分别设定
memory.limit与memory.swap.max; - 高速换出:官方博客指出,高速 NVMe Local SSD 基本消除了历史上”换页到低速机械盘”带来的延迟惩罚。
核心思路:把“不再活跃”的内存页换出到本地 SSD,把宝贵的 DRAM 留给真正需要低延迟的活跃工作集。
基准测试数据
官方博客在三类真实 workload 上进行对照实验:
| 工作负载 | 基线容量(无 Swap) | 本地 SSD Swap 容量 | 密度提升 |
|---|---|---|---|
| Linux 内核编译(CI/CD) | 600 MB RAM 限制 | 300 MB RAM + Swap | ‑50 % RAM(600 MB→300 MB) |
| Headless Chrome(Kata) | 40 并发 Pod | 50 并发 Pod | +25 % |
| Headless Chrome(gVisor) | 80 并发 Pod | 160 并发 Pod | +100 % |
| Python 沙箱(gVisor) | 80 并发 Pod | 240 并发 Pod | +200 %(3 倍) |
关键结论:gVisor 场景开启 Swap 可实现 2‑3 倍 的 Pod 密度提升;官方同时指出,在峰值密度下每 Pod 延迟的上升主要来自 CPU 争抢而非 swap I/O(只有把内存限制压到 200 MB 时才出现 +40 % 的执行时间增长)。
无沙箱基线:官方还给出无沙箱
runc对照——在 c4-standard-32(32 vCPU / 120 GB)节点上,不开 swap 时超过 512 个 Pod 即耗尽物理内存,开启 Local SSD swap 后可达 768 个 Pod。
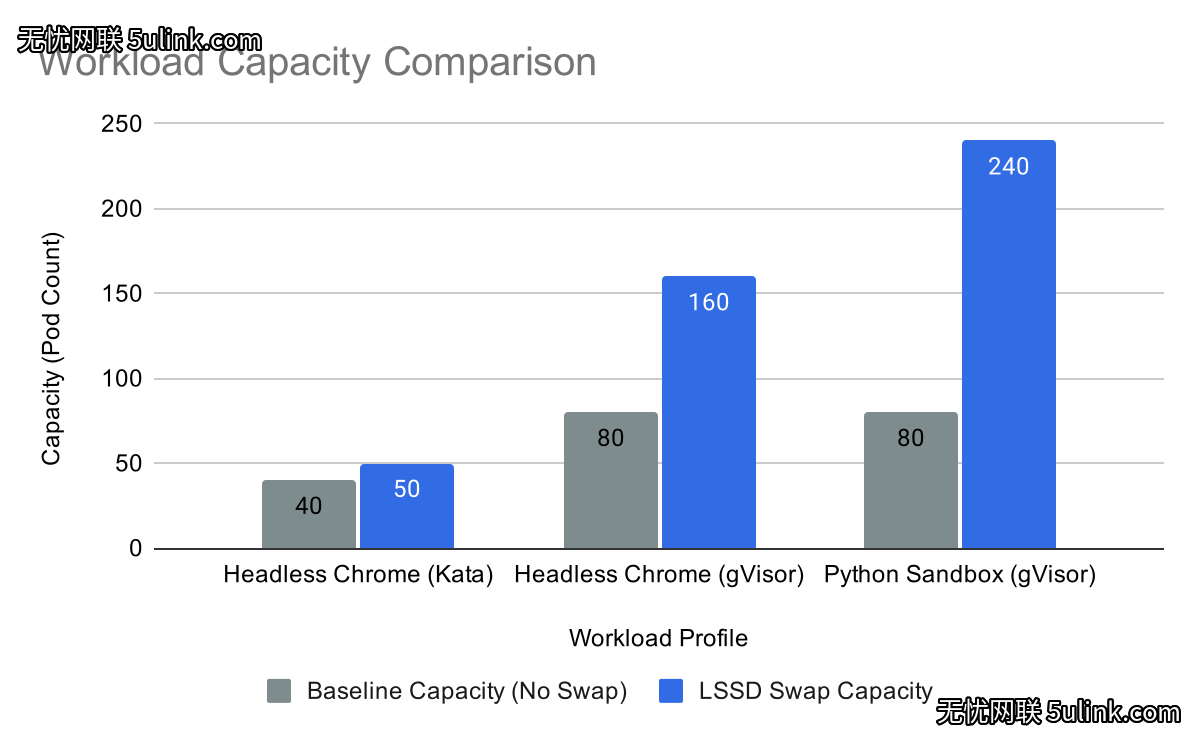
图 1 为官方博客提供的密度对比(使用 SVG 渲染),可见 gVisor 与 Python 沙箱 在开启 Swap 后的线性增长。
详细实验结果
- Linux 内核编译
- 无 Swap:最低内存限制 600 MB,否则在链接阶段触发 OOM。
- Swap 启用(300 MB + SSD):容器内存限制下降 50 %,执行时间 374 s vs 433 s(略快)。
-
进一步压缩至 200 MB:换出压力过大,I/O 等待显著,执行时间 +40 %。
-
Headless Chrome(Kata / gVisor)
- Kata:40→50 pods(+25 %)。
-
gVisor:80→160 pods(翻倍),得益于 gVisor 的轻量级容器隔离。
-
Python 沙箱(gVisor)
- 80→240 pods(3 倍),在 AI Agent 场景中极为关键——每个会话常驻内存约 375 MiB(分析 MovieLens 20M 的 500 万行数据)。
实战建议:生产环境中 内存压缩至 300 MB 是安全阈值;如需进一步提升密度,可依据业务 idle 时长做动态调节。
如何在集群中启用 Node Swap
- 节点层面
“`bash
sudo swapon -a
# 检查 swap 分区或文件
swapon -s
“`
-
Kubelet 配置(v1.34+)
yaml

   # /var/lib/kubelet/config.yaml

   kind: KubeletConfiguration

   apiVersion: kubelet.config.k8s.io/v1beta1

   failSwapOn: false

   memorySwap:

swapBehavior: LimitedSwap官方配置:
failSwapOn: false允许启用 swap 的节点加入集群;memorySwap.swapBehavior取LimitedSwap(按实际 swap 用量分配)或UnlimitedSwap,节点即会按空闲内存自动分配换出空间。 -
容器层面(使用 cgroup v2)
yaml

   resources:

     requests:

       memory: 200Mi

     limits:

       memory: 300Mi

   # limits > requests 才是 Burstable QoS,节点才会按空闲内存自动分配换出空间
注意:只兼容 cgroup v2(Kubernetes 1.22+ 默认),使用 cgroup v1 的节点仍会被调度器拒绝。
生产实践要点
| 场景 | 推荐配置 | 关键指标 |
|---|---|---|
| AI Agent(大量 idle) | memory.limit = 300Mi,开启 Swap |
Pod 密度最高 ↑200 %(3 倍) |
| CI/CD 构建 | memory.limit = 300Mi + Swap |
构建时间持平或略降(374 s vs 433 s) |
| 低延迟服务 | 关闭 Swap,或仅对 非核心 Pod 开启 | 避免换出影响 p99 延迟 |
- 监控:使用
node_exporter的node_memory_Swap*指标,结合 Prometheus Alertmanager 设定 Swap 使用率 > 80 % 告警; - 容量规划:根据业务 idle ratio(空闲占比)估算换出空间,建议 Swap 容量 ≥ 2 × Pod 空闲内存;
- 安全:cgroup v2 防止容器突破 swap 配额,避免因 swap 失控导致节点 OOM。
参考链接
- Kubernetes 官方博客 – Scaling Kubernetes Workloads with Node Swap (2026‑10‑05)
- Kubernetes v1.34 发布公告 – Pods Report DRA Resource Health
- cgroup v2 文档 – Memory controller
- Agent Sandbox 项目 – Kubernetes 上的安全沙箱实现
- Agent Sandbox – GKE Swap 示例与原始日志
落地建议:国内团队在 AI Agent 场景(如 autonomous coding assistant、dialogue agents)下,建议先在 预生产 集群进行 Swap 比例 调整(推荐 30‑50 %),观测 Swap I/O 与 Pod 延迟,确认无异常后再全量开启。