
开源模型吃掉八成流量之后:vLLM 和 SGLang 到底怎么选
先说为什么这个问题现在值得重新问
Red Hat 开篇给的数据改变了讨论的前提:在 Vercel 的 AI Gateway 上,开源权重模型在 2026 年 9 月处理了接近 80% 的生产 token,而 2025 年 12 月这个比例还不到 10%。OpenRouter 的周 token 用量曲线是同样的走向。
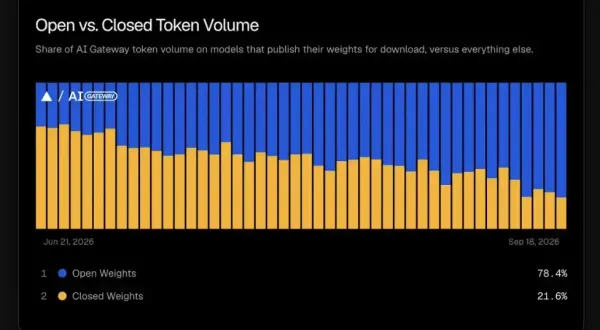
图:开源权重模型已构成 Vercel AI Gateway 上 token 用量的大头(图源:Red Hat Developer 原文图 1)
流量结构一变,”为什么不自己跑”就成了自然追问——大多数 agent、RAG 管道和 AI 应用换后端只是改一个 OpenAI 兼容 API 的 base URL。但 URL 后面的东西才是关键:推理引擎决定请求怎么调度、GPU 显存怎么用、用户是秒回还是干等。这就是为什么大规模生产部署里被问得最多的两个名字是 vLLM 和 SGLang。
两家解的是同一道题:KV 缓存
比较之前先看懂问题。LLM 请求分两个阶段:
存下来的键值就是 KV 缓存——留着它,模型就不用为每个新 token 重算一遍,但它随对话增长,能吃掉大量显存。不同负载压的阶段也不同:读长文档压 prefill,代码生成(输出量大)压 decode。
所以推理引擎的本质是KV 缓存的调度器和内存管理器:决定哪些请求一起跑、缓存状态放哪、请求进出时怎么让 GPU 保持忙碌。vLLM 和 SGLang 各自从一个不同的答案出发。
出发点不同:分页 vs 前缀树
vLLM(UC Berkeley,2023) 盯上的是一个具体问题:多数服务系统在浪费 KV 缓存内存。因为对话缓存会一直长、输出长度事先不知道,引擎只能提前预留大块连续显存。vLLM 原论文测得现有系统浪费了 60–80% 的这部分内存,直接限制了单卡能同时装下多少请求。它的解法 PagedAttention 把 KV 缓存切成固定大小的小块、可以落在显存任意位置——像操作系统给进程分页一样,显存随序列增长按需分配。
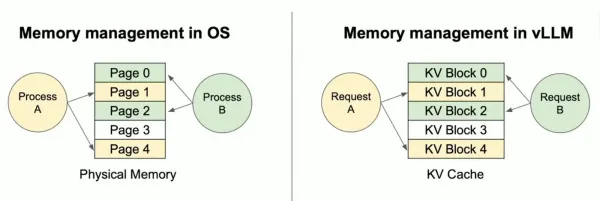
图:PagedAttention 借用操作系统分页思路,请求拿到的 KV 块不必相邻(图源:Red Hat Developer 原文图 2)
这个思路好到成为公共遗产:如今分页式 KV 缓存管理已是现代推理引擎的标配,SGLang 也在用。vLLM 随后长成”任何模型、任何加速器、任何云”的宽生态,Red Hat 是其最大的企业贡献方。
SGLang(LMSYS,2024 年 1 月) 的名字 Structured Generation Language 就说明了它的目标场景:大量相互关联的模型调用——多轮对话、信息抽取流程、会分叉和循环的 agent。这类应用大量重复:agent 每次调用都带同样的系统提示词、同样的工具定义,外加只增不减的对话历史。SGLang 的 RadixAttention 把算好的 KV 缓存放进一棵按 token 前缀索引的基数树,新请求进来先走树、命中即复用、只算新增部分,久未使用的分支优先淘汰。再配上缓存感知调度——共享前缀的请求安排在一起跑,等它们要用缓存时缓存还在。
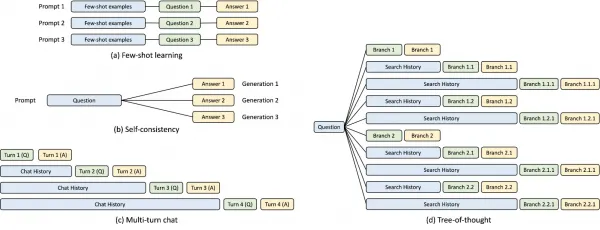
图:few-shot、自一致性、多轮对话、tree-of-thought 都是前缀共享模式,RadixAttention 复用共享部分(图源:Red Hat Developer 原文图 3)
今天已经互相抄作业
两家都早就不止于各自的原始优化,能力清单高度重合:持续批处理、前缀缓存、分块 prefill、结构化输出、投机解码、量化、分布式执行,两边都有。
| 维度 | vLLM | SGLang |
|---|---|---|
| 出身 | UC Berkeley,2023 | LMSYS,2024 年 1 月 |
| 原始核心 | PagedAttention(分页显存) | RadixAttention(前缀树复用) |
| 新模型支持 | Day-0,recipes 页给到可直接跑的命令 | Day-0,cookbook 对等 |
| 硬件 | NVIDIA/AMD 一等公民;TPU、Intel GPU、CPU、Apple 支持更早、有文档 | NVIDIA/AMD 一等公民,覆盖多种加速器 |
| 社区 | GitHub 2025 Octoverse 贡献者增速榜**第 3** | 同榜**第 7** |
| PyTorch 基金会 | Foundation-Hosted Project(相当于”毕业”) | Ecosystem Project(保持独立治理) |
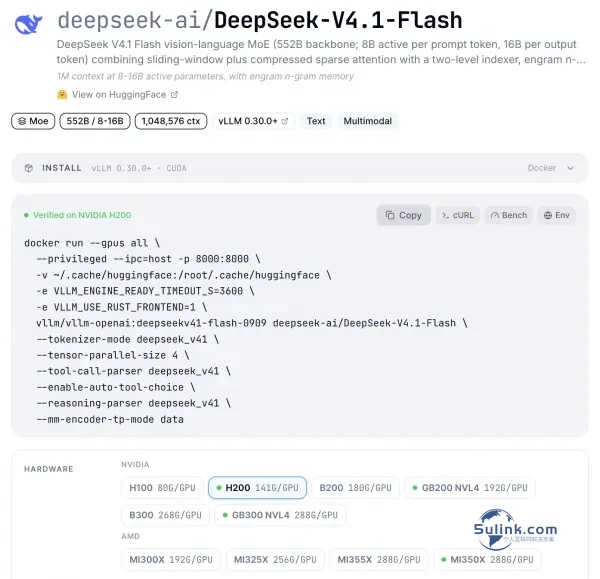
图:vLLM recipes 页给出可直接执行的 docker 命令和 NVIDIA/AMD 硬件选项(图源:Red Hat Developer 原文图 4)
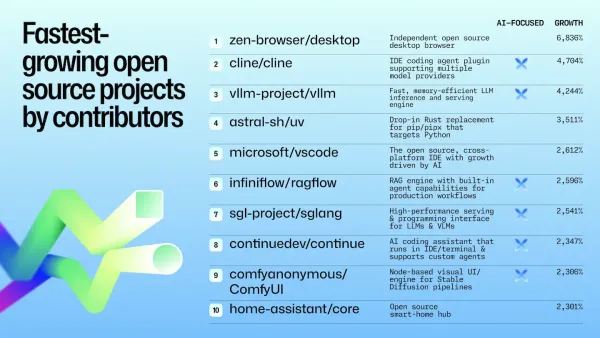
图:GitHub 2025 Octoverse 贡献者增速榜,vLLM 第 3、SGLang 第 7(图源:Red Hat Developer 原文图 5)
2025 年双双进入 PyTorch 基金会生态,这个信号值得记住:两边都不是小众赌注,选哪个都不会被生态绑死。
独立基准怎么读:注意简·奥斯汀
Modal 的 LLM Engineer’s Almanac 在 NVIDIA GPU 上、用开箱默认设置测了 vLLM、SGLang 和 TensorRT-LLM,覆盖十多个模型、10 种输入输出长度组合。结论原文:两者表现相当,选择取决于其他因素,比如谁更快交付你需要的那些功能。
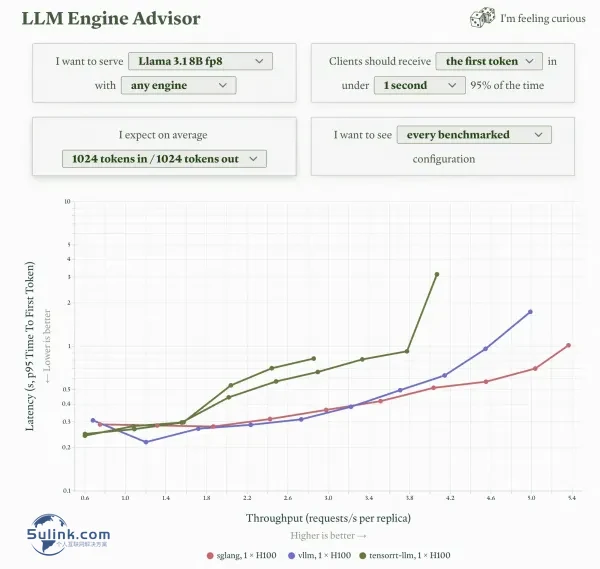
图:Modal LLM Engine Advisor 绘制的吞吐/首 token 延迟曲线(右下更优)(图源:Red Hat Developer 原文图 6)
Llama 3.1 8B 单 H100,取 p95 首 token 延迟仍低于 1 秒时的最高请求速率:
| 负载(入/出 token) | 最接近的真实场景 | vLLM 吞吐 | SGLang 吞吐 | vLLM p95 TTFT | SGLang p95 TTFT |
|---|---|---|---|---|---|
| 1024 / 128 | RAG、摘要 | **17.08 req/s** | 16.88 req/s | **0.52 s** | 0.83 s |
| 128 / 1024 | 代码生成 | 5.34 req/s | **6.50 req/s** | 0.82 s | 0.87 s |
| 2048 / 2048 | 长对话 | 1.23 req/s | **1.25 req/s** | **0.65 s** | 0.74 s |
读这张表必须带上原文自己加的注:Modal 的测试提示词是《傲慢与偏见》的随机段落——请求之间几乎没有共享前缀。这对独立请求是公平的,但恰好没测到 chat 和 agent 场景真正在乎的前缀复用,而那正是 RadixAttention(以及 vLLM 的前缀缓存)拉开差距的地方。数据也来自单副本默认配置,调一调参数画面就会变。
所以 Red Hat 给的方法论是:最好的基准是你自己的流量。 用 GuideLLM 这类工具拿真实提示词在自家硬件上跑,再下结论。
怎么选:三条判断线
把原文拆成可执行的判断:
1 条回复
[…] 这篇是三天前《开源模型吃掉八成流量之后:vLLM 和 SGLang 到底怎么选》的姊妹篇:两家的选型判断线那篇已经写完,这篇把 LMDeploy 拉进同一张基准表——三家同场跑分,重点看第三家的增量在哪。 […]