
万卡 GPU 集群怎么管:AI21 用 Kueue 把群里扯皮变成自动调度
起点:在聊天频道里”协商”GPU
共享大型 GPU 集群是 AI 训练团队的常客难题:资源稀缺,分给谁、谁优先、要不要打断正在跑的任务换人——这些问题的答案在 AI21 早期都靠一个叫 #gpu-resources 的内部消息频道:谁需要被占满的卡型,就在群里喊一声,祈祷有人腾出容量。
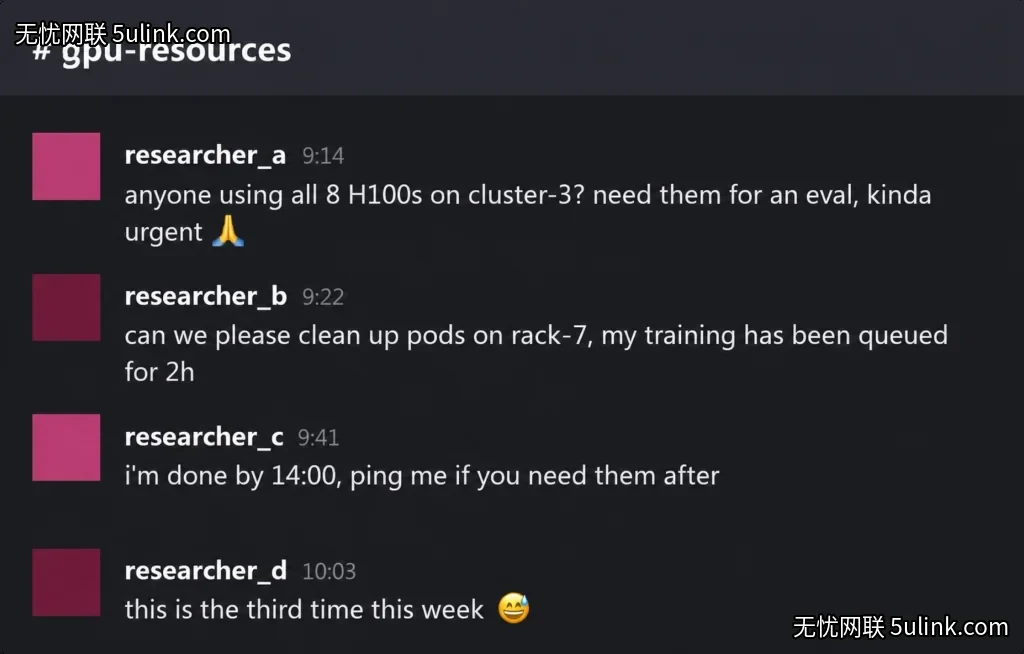
集群有余量时这套办法能用。一旦利用率贴着 100% 跑(昂贵的预留 GPU 集群的目标就是贴满),每个请求都变成零和的驱逐谈判,频道撞墙了:工程时间浪费在扯皮上、排队不公平、有的容量闲着有的团队挨饿、靠”魔法命令”临时清场。
他们先写下了理想 GPU 管理系统的四根支柱:公平(按账户用量系统决策,不是先到先得、不是嗓门大优先)、秩序(队列反映业务优先级,不只是时间戳)、效率(开发者不用手动删自己闲置的任务)、技术完整性(多 Pod 的 gang 任务凑齐资源才启动,不允许部分部署)。
集群长什么样
这个共享 GKE 集群聚合约 10,000 张 GPU,跑三种容量(预留、spot、DWS flex-start)和三种负载(debug pod、训练任务、推理部署),任务按可抢占性分两类(不可打断的红线类、可打断的轻量类)。刻意保持单一大池而不是每队一个集群:K8s 开很多集群很容易,但集群之间共享容量很难——大池是保持高利用率的前提,也正是调度压力的来源。
先检查了 K8s 原生有什么,结论是都不够:
| 原生机制 | 提供什么 | 差在哪 |
|---|---|---|
| PriorityClass | 关键 Pod 可抢占非关键 Pod | 在 Pod 级不在任务级,无 gang 感知——可能整批低优任务被抢,只为给高优任务腾 1 张卡 |
| ResourceQuota | 命名空间硬上限 | 空闲时不能跨队借用;超额任务直接被拒而不是排队 |
| LimitRange | 容器级默认/上下限 | 是护栏不是调度器 |
| Indexed Job | 任务并行度抽象 | 没有 all-or-nothing——4 个 Pod 排上 3 个,第 4 个塞不进,前 3 个照样跑、照样烧 GPU |
评估了三个批调度器:YuniKorn、Volcano、Kueue。当时 Volcano 功能更多但与他们的环境整合不顺,YuniKorn 覆盖不了全部用例。简单和整合上,Kueue 赢了。
与 Kueue 合作:从 v0.10 到 v0.15
四根支柱与 Kueue 特性一一对应(公平 = Preemption Fair Sharing + AFS;秩序 = Workload Priority Classes;效率 = ClusterQueue 细粒度抢占控制;完整性 = all-or-nothing 语义)。实现需求则与算法负责人团队逐条敲定,形成五类池:每队保底、共享保底(单节点/多节点)、机会型(best-effort,”这是保持高利用率的那根杠杆”)、按需(spot/DWS)。
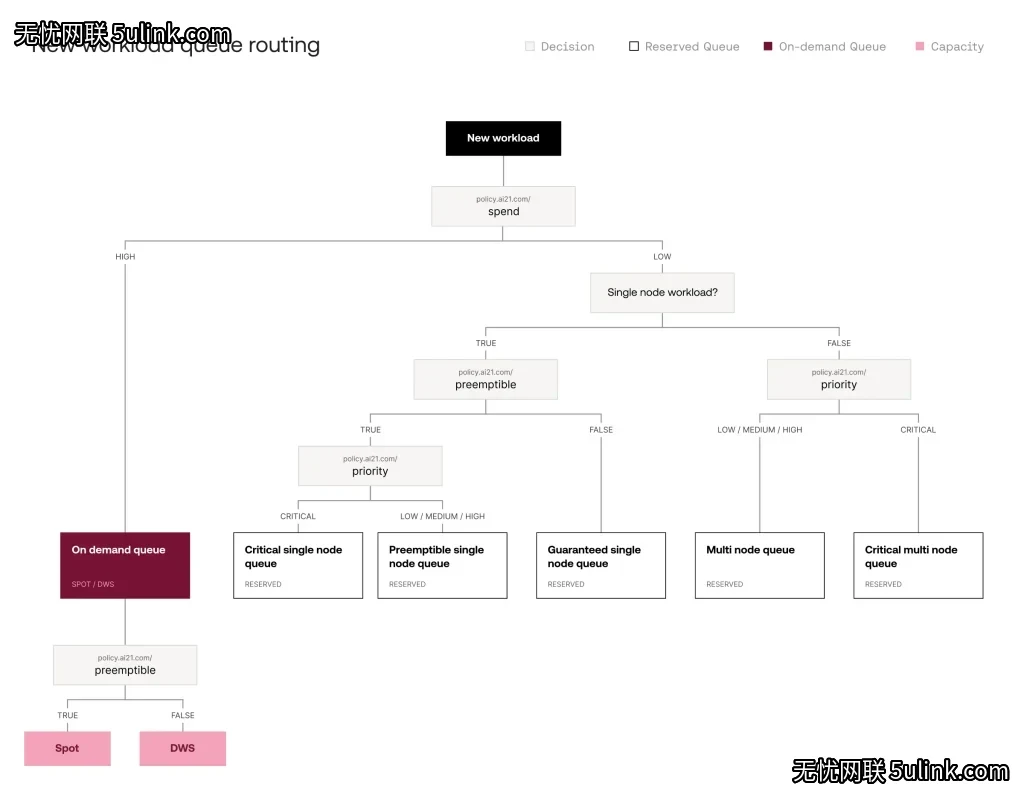
v0.10 上线后暴露两个问题:
公平缺口。 当时 AFS 还不存在,只有抢占侧 Fair Sharing,”按芯片数公平调度多节点任务”和”非 critical 不跨队抢占”两个需求无法同时满足。他们把问题直接提给 Kueue 团队,对方很快做出 Admission Fair Sharing(AFS):抢占饿死别人的队伍 + 把历史用量低的队伍排到队列前面。原文把这称为”强开源项目的最佳反馈回路”——真实使用暴露需求,需求反哺产品。
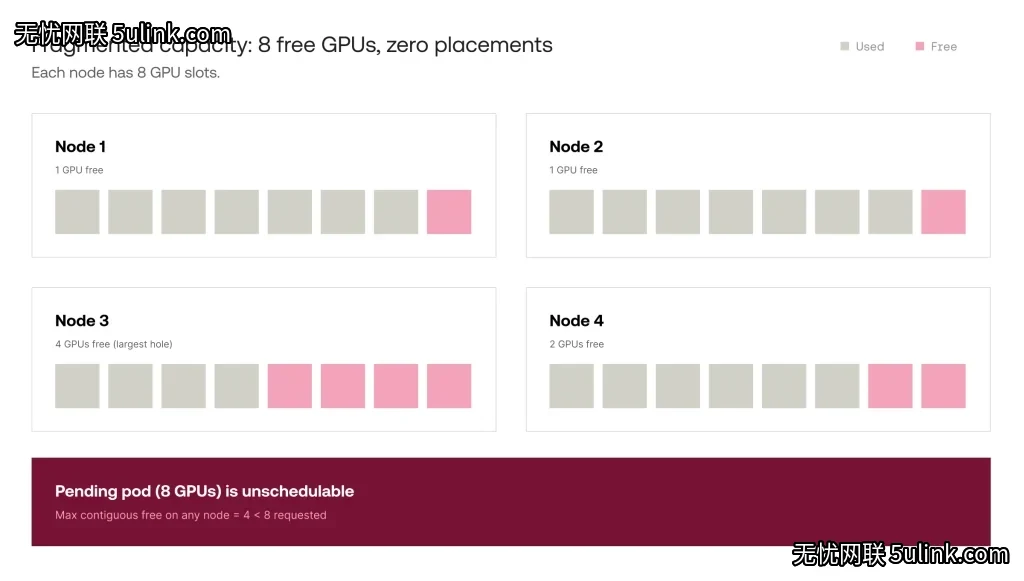
碎片问题。 配额总和等于全部 GPU,账面有 8 张空闲,但散成 1+1+4+2 分布在四个节点——一个需要整机 8 卡的任务无处可落。Kueue 不是调度器、不感知”每机 8 卡”的拓扑。解法是他们此前没用过的 Topology Aware Scheduling(TAS):配置 Topology 资源后,Kueue 会在准入时给任务钉上 nodeName,并用 LeastFreeCapacity 算法把新任务优先塞进最满的节点,减少碎片。
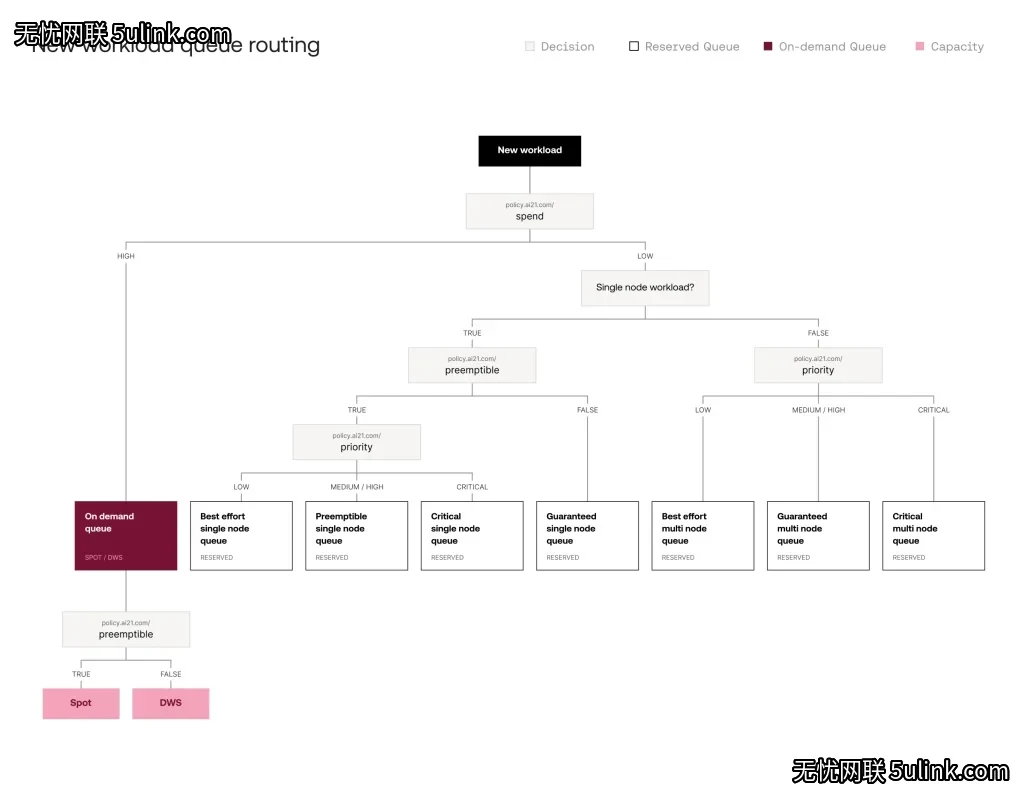
带着 AFS 和 TAS 回去开会, backlog 全解了,但会上又领回两个新需求:抢占池内按优先级分层(low 单独成道、被 medium/high 优先抢),以及多节点 best-effort 新车道。于是有了 v0.15:
结果数字
今天 #gpu-resources 频道已归档。每个任务——单节点 debug、多节点训练、推理部署——自动进正确的队列,排队、优先级、清理、跨队公平全部自动,没有手动谈判。切换 Kueue 后拿回来的:
- 每周手动干预:20 → 0
- “僵尸”/部分分配任务:清零
- GPU 碎片率:15% → 8%
- 每周花在群里谈 GPU 的时间:几小时 → 无
- hero job 平均饥饿时间:72 小时 → 12 小时
- Google Cloud 版故事里另有:高优任务 time-to-start 降 83%
三条核心经验
- 在任务级调度,不在 Pod 级。 原生 K8s 抢占会杀掉 4-Pod 训练里的 1 个 Pod,让另外 3 个继续烧卡。分布式训练需要 gang/all-or-nothing 准入。
- 队列不懂你的拓扑就不算调度器。 配额说 8 卡空闲,碎片说 8 卡没处放。TAS 让 Kueue 能拒绝装不下的任务、把落点钉在最满的节点上,队列才真正变成调度器。
- 故意让集群贴着 100% 跑。 对预留 GPU 集群,满载是目标不是警报。让它安全的是机会型车道——借走闲置、归还于需要,”满”就不会变成”堵”。
小夏点评
- 这篇文章罕见地记录了”用户给上游开源提需求”的完整闭环:AFS 这个特性就是 AI21 的真实生产需求直接催生出来的——选开源组件时,供应商能不能被你的问题改变,本身就是选型指标。
- 碎片率 15%→8% 看着不起眼,含金量最高:万卡规模下 7 个百分点的碎片回收约等于白捡 700 张卡,比任何”参数调优”都便宜。
- 给国内团队的启示:国内多卡集群普遍还停留在”排队靠人肉、抢占靠管理员”的阶段,Kueue 这套准入-优先级-抢占的分层模型可以直接抄作业——尤其是”机会型车道保利用率”这一条,对按小时计费的混合云 GPU 场景几乎是立竿见影的省钱项。
参考链接
- 原文:From manual negotiation to automated scheduling: How AI21 manages its GPU fleet with Kueue(2026-10-04,作者 Asaf Ben-Tovim)
- Google Cloud 版故事:AI21 trains its models on AI Hypercomputer
- Kueue 官方文档:kueue.sigs.k8s.io
- Kueue 仓库:github.com/kubernetes-sigs/kueue
1 条回复
[…] – 站内延伸阅读:万卡 GPU 集群怎么管:AI21 用 Kueue 把群里扯皮变成自动调度 […]