下一个跑谁,Kubernetes 自己说了不算:Kueue 实测,一个标签让死锁消失
Kubernetes 的默认调度器只做一件事:把 Pod 放到一个装得下的节点上。它不管这个任务该不该现在开始,也不管这个任务要几个 Pod 才能干活。于是当一个”要吞掉整集群 GPU 和 CPU”的批任务进来时,微服务开始挨饿,分布式任务卡在半路,调度器完全不知道该先跑谁。
Kueue 就是来管这件事的:它在准入层排队、算配额、按优先级放行,保证一个任务要么整体拿到资源,要么整体等着。这篇把 Kueue 为什么存在讲清楚,再把作者的整套演示跑一遍——这些 YAML 你今天就能照着跑。
默认调度器只会”放置”,不会”决定先后”
默认调度器的逻辑很朴素:Pod 进来 → 看哪个节点装得下 → 装得下就调度,装不下就一直 Pending。问题是队列里还有别的活儿在抢同一份资源。作者列了默认调度器搞不定的五件事:
| 缺口 | 具体场景 |
|---|---|
| 团队间的公平 | 谁也不能把公共池子占干 |
| 死锁 | 有的任务必须所有 Pod 一起跑 |
| 队列管理 | 谁先跑总得有个规则 |
| 资源配额 | 每个团队能用多少 |
| 抢占 | 能不能暂停低优任务给关键任务让路 |
场景并不陌生:集群跑微服务跑得好好的,某天有人上了一个批任务——可能是模型训练,也可能是跑当天的日志流。任务一起来就把集群里所有空闲的 GPU、CPU、内存全抓走,其他重要负载只能干等,有的还等到互相等死的死锁:任务在等资源,而资源被别的任务占着,集群没有办法决定”谁先跑”。
批任务不是微服务:”起一半”等于全废
先分清两类负载,后面所有设计都是从这个区别里长出来的。
| 微服务(你的集群现在的样子) | 批任务(把集群搞崩的那个) | |
|---|---|---|
| 生命周期 | 7×24 长跑 | 跑一段就停 |
| 资源需求 | 不大且可预测 | 很重(GPU/TPU/高 CPU) |
| 触发方式 | 响应请求 | “把这批数据全处理完” |
| 状态 | 相对独立 | 跨 Pod 的分布式状态 |
| 容错 | 少一个副本还能跑 | 8 个 Pod 起来 5 个 = 任务停摆 |
| 例子 | 对外提供 API 的 Web 服务 | 用 1TB 数据训模型、跑当晚日志、跑备份 |
作者给的三个真实量级:
| 批任务 | 需要 | 之后 |
|---|---|---|
| 机器学习训练 | 8 张 GPU + 256GB 内存,跑 4 小时 | 彻底停掉 |
| 数据管道 | 64 核 + 512GB 内存处理日志 | 停掉,等明天 |
| Spark/Hadoop 大作业 | 一次要 100 核 + 500GB 内存 | 跑完就结束 |
为什么这类任务必须”所有 Pod 一起开始”?作者用了四个人的团队作业打比方:前三个人都说”我准备好了”,第四个人在等电脑——前三个人就只能干坐着,任务不推进,资源花了但活没干。
分布式任务里 Pod 之间是有依赖的:Pod 1 要连 Pod 2,Pod 2 要从 Pod 3 收数据,Pod 3 要 Pod 4 的数据。Pod 4 卡在 Pending,整条链全停。默认调度器把 4 个 Pod 当成 4 件独立的事:3 个放得下就放上去了,第 4 个塞不进——结果是 3 个 Pod 在跑、1 个在等,这个任务 75% 的资源配额被白白浪费。
这就是 gang scheduling(成组调度):任务说”我要 4 个 Pod,要么凑齐要么别开始”,Kueue 检查能不能装下全部 4 个——能就四个一起放行,不能就四个一起排队。结果非 100% 即 0%,中间没有”空跑的 Pod”。而默认调度器不懂 gang,它不知道”这 8 个 Pod 是一个要一起拿到资源的团队”,于是部分调度,部分调度就等于死锁。
Kueue 是什么:准入层的交警
Kueue 是 Kubernetes 批任务的排队与配额管理系统(Kubernetes 原生项目,作者演示用 v0.19.4 安装)。它的流程是:任务先进队列 → 检查资源 → 按优先级和配额公平分配 → 原子化放行(分布式任务全量准入或全量不准入),也就是:
> 用户任务 → KUEUE(智能关卡)→ Kubernetes 调度器 → 创建 Pod → 没有死锁
核心原则只有一句:只有 100% 确定所有 Pod 的资源都够,Kueue 才让一个任务开始。
官方文档同时强调,Kueue 不替换任何现有 Kubernetes 组件:自动扩缩容、Pod 排布、任务生命周期仍然归 cluster-autoscaler、kube-scheduler 和 kube-controller-manager,它是加在调度之前的准入环节。官方文档写明支持并测试于 Kubernetes 1.34 及以上(GitHub README 目前推荐 1.35 及以上);除原生 Job 外,内置集成还包括 JobSet、KubeRay(RayJob/RayCluster)、Kubeflow Trainer v2 的 TrainJob(v1 系列已标记弃用)、AppWrapper、纯 Pod 与 PodGroup、LeaderWorkerSet 等。
作者的五个理由:公平(团队不互相饿死)、gang scheduling(分布式任务整队启动或整队排队)、优先级(关键任务优先于实验任务)、可见性(你能看到任务为什么在排队、什么时候能跑)、配额(每个团队有保底份额)。
理解 Kueue 只要记住六个对象:
| 对象 | 是干什么的 | 大白话 |
|---|---|---|
| Workload | Kueue 能看懂的你那个 Job 的外壳 | 你交上去的 Job 被包成 Workload,用来在队列里跟踪状态 |
| LocalQueue | 某个命名空间专属的队列 | 你们命名空间的”投递窗口”,任务先投到这里 |
| ClusterQueue | 握着真实资源预算的上层队列 | “总部”:集群层面有多少资源、哪个队列分多少,跨命名空间在这里按优先级和公平竞争 |
| ResourceFlavor | 一类资源的标签 | “我们有两种机器:贵的 GPU 和便宜的 CPU,分开标” |
| ResourceQuota | ClusterQueue 能用多少资源 | “这个队列最多 100 核、500GB 内存、16 张 GPU,不能超” |
| Admission | Kueue 说”你可以跑了” | 任务在队列里等,Kueue 核过资源后盖章放行 |
串起来是:Job → Workload → LocalQueue → ClusterQueue → 资源够不够 → 准入 → 调度器 → Pod → 运行 → 完成 → 释放资源 → 下一个任务。
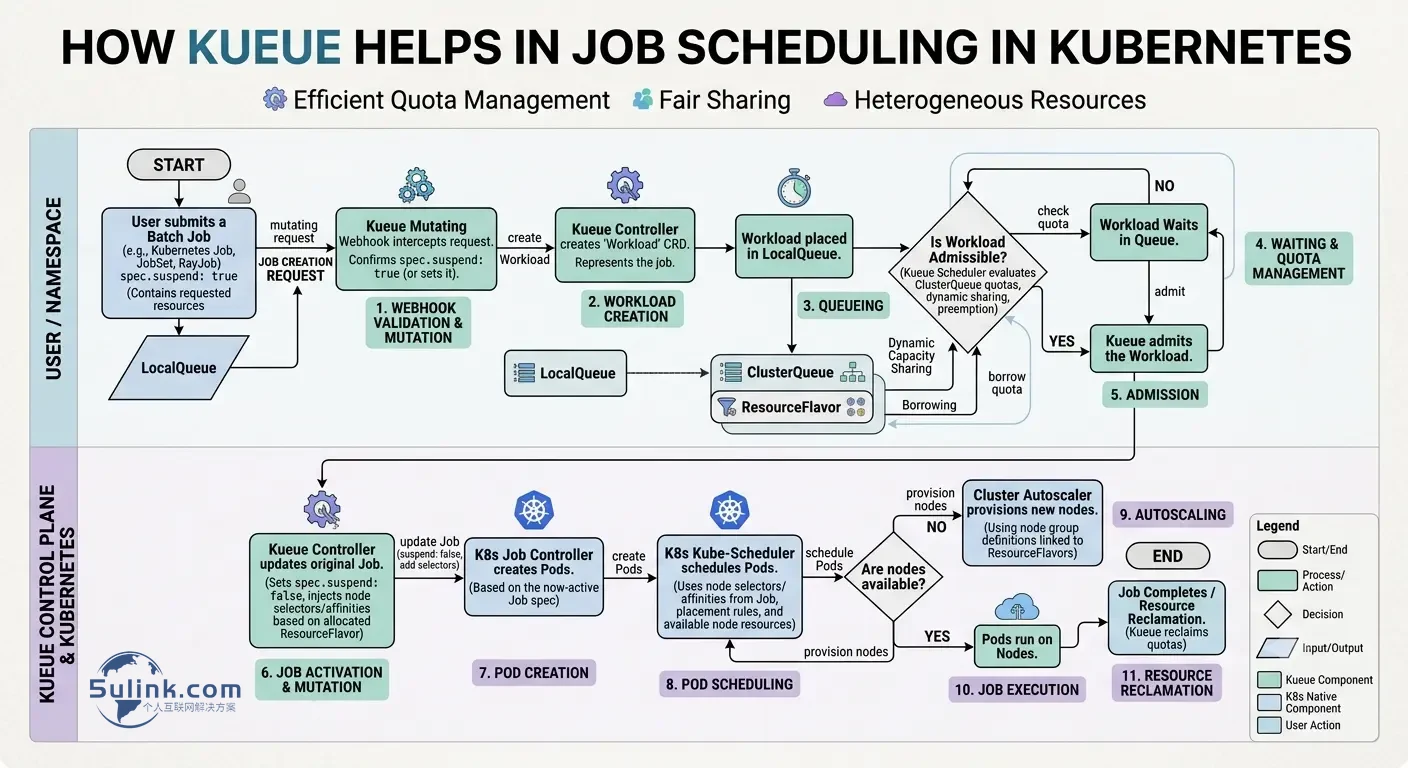
安装就是装一个 Kubernetes controller:kubectl apply --server-side 官方 v0.19.4 的 manifests.yaml,controller 跑在 kueue-system 命名空间;装完 kubectl get crds | grep kueue,能看到 admissionchecks、clusterqueues、cohorts、localqueues、multikueueclusters、multikueueconfigs、provisioningrequestconfigs、resourceflavors、topologies、workloadpriorityclasses、workloads 共 11 个 CRD——配额、公平共享、拓扑、多集群这些能力都在这些 API 里。
实测一:排队是 Kueue 做的,不是调度器做的
先给集群”划一小块地”:命名空间 kueue-demo,一个 ResourceFlavor,一个 ClusterQueue 把预算写成 10 核 / 20Gi 内存,再用一个 LocalQueue 把命名空间接到这个 ClusterQueue 上。
| 步骤 | 动作 | Kueue 的判断 |
|---|---|---|
| 1 | Job A 申请 8 核 / 12Gi | 10 核装得下 → 准入,kubectl get workloads 里 ADMITTED=True,LocalQueue 显示 0 pending / 1 admitted |
| 2 | Job B 申请 5 核 / 8Gi | 只剩 2 核 → 不准入,Workload 停在队列里,ADMITTED 那列是空的 |
| 3 | kubectl describe workload 看原因 |
couldn't assign flavors to pod set main: insufficient unused quota for cpu in flavor default, 3 more needed——直说还差 3 核 |
| 4 | 删掉 Job A 释放资源 | Kueue 立刻把 Job B 抬进队列:ADMITTED=True,Pod 这才被创建出来 |
注意顺序:Job B 从开始就一直挂在队列里,Pod 根本没创建。如果先让 Pod 创建出来再让调度器去排队,那它就是”占着位置的空跑 Pod”。Kueue 把顺序倒过来——先准入,后创建。
实测二:同一个任务,两种结局
这是这篇最有价值的部分:一个刻意造出来的死锁,以及 Kueue 怎么处理它。
场景设定:命名空间配额 1500m CPU / 2Gi 内存。两个任务——Job A 长期跑,吃 800m CPU(跑 600 秒);Job B 是 gang 任务,2 个 Pod × 400m = 800m,两个 Pod 必须一起干活。
没有 Kueue 的时候: Job A 先准入,占 800m,剩 700m。Job B 的 Pod 1 创建成功(累计 1200m),Pod 2 要再加 400m、总量变 1600m,超过 1500m 配额被直接拒绝,事件里全是 FailedCreate ... exceeded quota。于是 Job B 只有两个 Pod 中的一个:Worker 1 跑起来了,但它要同步的 Worker 2 永远不会存在——400m CPU 被扣在那儿当人质,剩下的 300m 也喂不饱另一个 400m 的 Pod,整个集群卡住,直到 Job A 十分钟后自己跑完。
换成 Kueue(配额同样 1500m): 同样的 Job A 准入运行,同样的 Job B 提交上去——
| 没有 Kueue | 有 Kueue | |
|---|---|---|
| Job B 的 Pod 数 | 1 个(第 2 个被配额拒绝,反复重试) | 0 个(整个任务挂起) |
Job B 的 Suspend |
false(Kueue 之前不归它管) | true(Kueue 自己给它写上的) |
| 无效占用 | 400m CPU 空转等伙伴 | 0,700m 是真空闲 |
| 事件 | FailedCreate ... exceeded quota,一直重试 |
CreatedWorkload → Job suspended |
| Job A 结束/删除后 | 要等十分钟才有人能动 | 立刻准入,两个 Pod 同时起(实测里 34 秒内两个 Pod 都是 Running) |
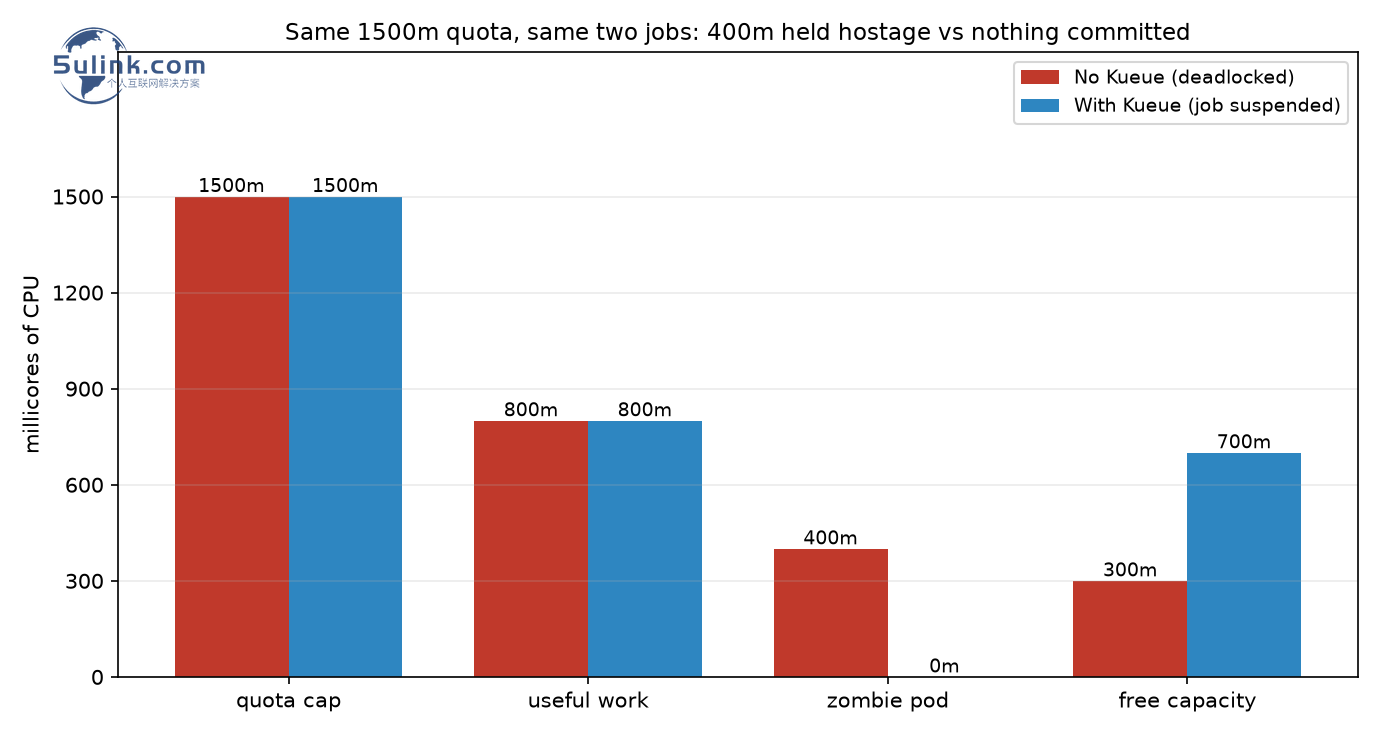
作者的结论很干脆:Kueue 自动拦截了任务创建,算出总需求(2 × 400m = 800m),发现只剩 700m,于是把整个任务挂起——没有部分准入。删掉 Job A 释放资源后,等待中的 gang 任务被立刻准入,两个 Pod 一起被创建,任务作为一个整体跑起来,而不是跟调度器打架。
真正起作用的东西:一个标签
演示里 Kueue 介入的方式朴素得有点可爱——给 Job 打一个标签:
labels:
  kueue.x-k8s.io/queue-name: default
作者特意补了一个容易踩的细节:演示里每个 Job 都显式打了标签,但如果命名空间里有一个叫 default 的 LocalQueue,Kueue 也会自动接管没打标签的 Job(LocalQueue defaulting)——这也是队列名取别的名字时必须靠标签指名的原因。多出来的开销只多了一个 controller,不用换调度器、不用改客户端、不用给任务加自定义 CRD。
小夏点评
- 1. Kueue 的价值不在”多一个调度器”,而在把准入和放置拆开。 Kubernetes 的调度回路是 Pod 级的、单点的,它天然无法回答”这 8 个 Pod 是一个团队”这类问题;Kueue 用 Workload/Queue/Quota 这套 API 把回答的权力接过去,而调度器、cluster-autoscaler 的职责一个都没被抢——这也是它能和 kube-scheduler 和平共处、还能顺手接上 JobSet、Ray、Kubeflow Trainer 的原因。国内做 AI 平台常见”再造一个大调度器”的做法,代价往往比这个高得多。
- 2. gang 任务的坑在国内集群里更贵。 我们的集群经常是”一张卡掰成三份用”,配额、超卖、抢占叠在一起,任务被部分准入的概率比原作者的演示环境更高;而这类任务一旦被部分准入,浪费的不是排队时间,是整段 GPU 时长。Kueue 的”非 100% 即 0%”加上明确写出”还差 3 核”的排队原因,对成本核算和值班排障都很实在。
- 3. 一个标签就能上,但真正的收益来自配额与公平共享的规划。 演示里最核心的动作只是给 Job 打上
kueue.x-k8s.io/queue-name,前提是你已经想清楚每个团队的保底份额、哪些队列能互相借用、哪些任务允许被抢占——这些是平台层面的决策,不是装完 controller 就自动出现的。对我们做混合云和自建 GPU 集群的运维来说,Kueue 的nominalQuota、cohorts 借用、MultiKueue 多集群分发这一套,正好补上了”K8s 原生 ResourceQuota 太粗、又没法跨命名空间共享”的短板,值得先从一个小队列的 shadow 环境开始试。
参考链接
- – 原文:Inside Kueue: How Kubernetes Decides What Runs Next(Kubesimplify,Ekamveer Walia,2026-09-16)
- – Kueue 官方文档 / Overview
- – Kueue GitHub(kubernetes-sigs/kueue,作者演示用的安装清单为 v0.19.4)
- – 站内延伸阅读:万卡 GPU 集群怎么管:AI21 用 Kueue 把群里扯皮变成自动调度