跑分表的 TFLOPS 不算数:2026 年选 AI 推理 GPU,只看 token/s 和带宽
核心论点:营销数字和 token/s 是两回事
TFLOPS、AI TOPS、加速频率这些数字不能直接换算成 LLM 推理吞吐。真正要看的指标是你实际负载下的 token/s——你的模型大小、你的量化方式、你的并发用户数。
原因在瓶颈位置:LLM 推理通常是内存带宽瓶颈,不是算力瓶颈。生成每个 token 都要做一次前向传播,都要把模型权重从显存里完整读一遍。70B 参数按 FP8 算,意味着每生成一个 token 要读约 70 GB 数据。显存读得越快,token/s 越高——这就是为什么 1.8 TB/s 带宽的 RTX PRO 6000 Blackwell 比带宽更低、TFLOPS 相近的卡跑得快;也是为什么超出模型需求的显存加再多也不涨吞吐——那时限制你的已经不是容量,是带宽。
训练、Blackwell 上的 FP4 推理、超大 batch 这类算力瓶颈型负载,TFLOPS 和 Tensor Core 代际才更重要。但实时生成、中等 batch 这个主流推理场景,带宽才是第一硬件指标。
单卡基准:30B 模型、生产口径
基准口径:vLLM + Qwen3-Coder-30B(AWQ 量化)、8K 上下文、生产式服务,数据来自 CloudRift 2026 年公布的第三方测试。
| GPU | 显存 | 带宽 | token/s | 备注 |
|---|---|---|---|---|
| RTX 4090 | 24 GB GDDR6X | ~1.0 TB/s | ~2,259 | 基准参照;装不下 70B |
| RTX 5090 | 32 GB GDDR7 | 1.79 TB/s | ~4,570 | 约 4090 的 2 倍;单卡装不下 70B |
| **RTX PRO 6000 Blackwell** | **96 GB ECC GDDR7** | 1.8 TB/s | **~8,425** | **约 5090 的 1.8 倍;单卡跑 70B FP8** |
| H100 PCIe | 80 GB HBM3 | 2.0 TB/s | 与 PRO 6000 相当 | 单卡口径下每 token 成本 PRO 6000 更优 |
| H200 | 141 GB HBM3e | 4.8 TB/s | 大模型上更高 | 70B 可跑 FP16;100B+ 推理需要它 |
| B200 | 180 GB HBM3e | ~8 TB/s | 最高可达 PRO 6000 的 4.9 倍 | 长上下文效率第一;仅限数据中心 |
注意 5090 和 PRO 6000 这一行:带宽几乎相同(1.79 vs 1.8 TB/s),吞吐却差 1.8 倍——差距来自并发架构,不是芯片。
同芯片的两种命运:RTX 5090 vs RTX PRO 6000
两张卡用同一块 GB202 Blackwell 芯片,差别在配置、显存容量和 ECC。原文按场景给了三个不同答案:
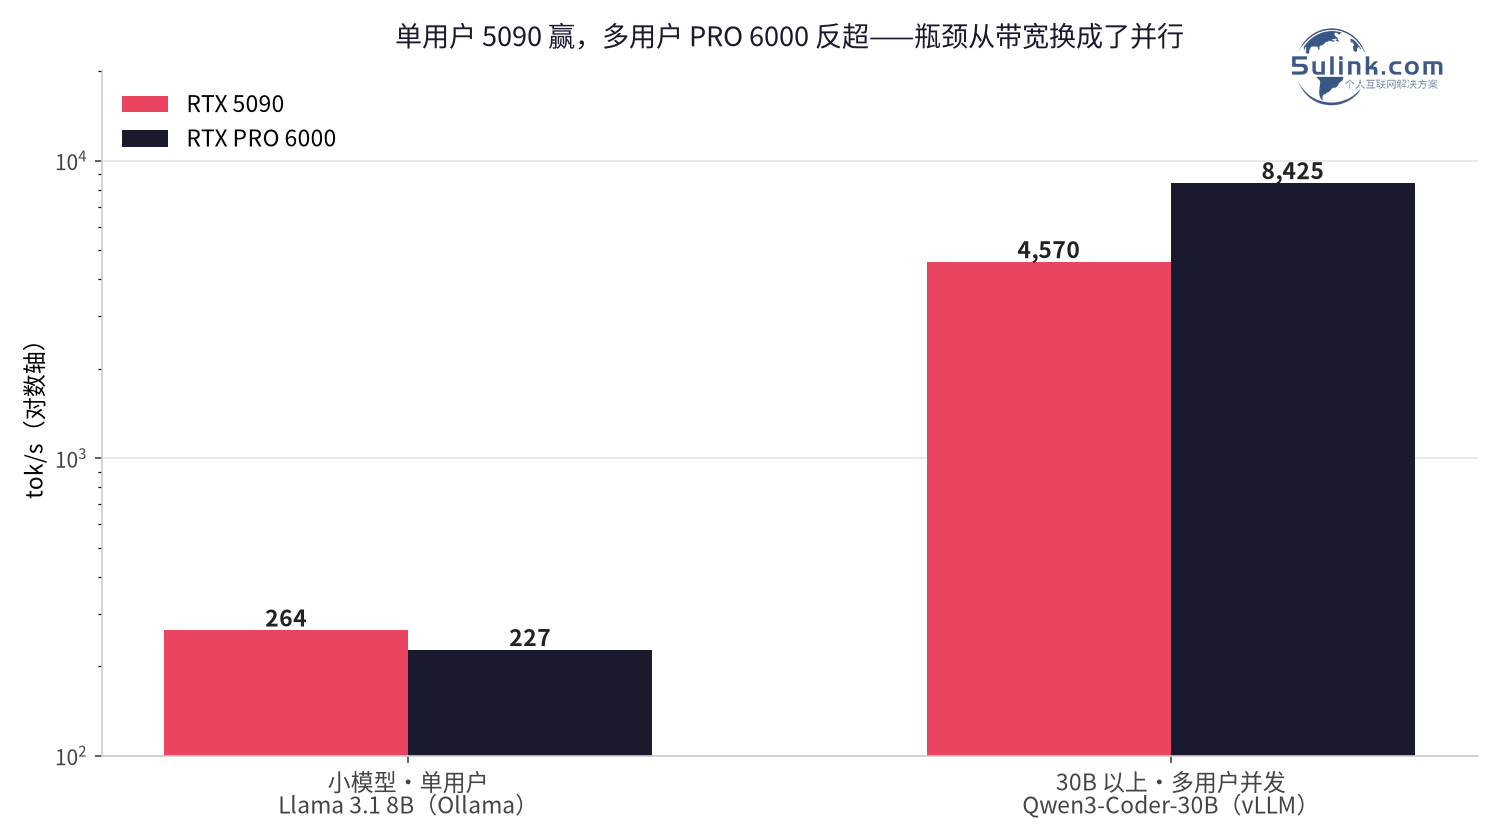
图:单用户小模型 5090 领先约 10–15%;30B+ 多用户并发服务 PRO 6000 反超 1.8 倍(数据:VRLA Tech 原文表格)
ECC 是原文单列的一条:PRO 6000 用 ECC GDDR7,5090 不支持。生产推理服务器、长周期微调、科学计算场景,ECC 防的是静默数据损坏。
PRO 6000 vs H100:单卡看成本,多卡看 NVLink
单卡口径,PRO 6000 每 token 成本比 H100 PCIe 低约 28%——H100 采购价明显更高,单卡推理吞吐却相当。H100 的优势在多卡规模才激活:NVLink 支持 8 卡张量并行、互联带宽 900 GB/s,SXM5 的 Transformer Engine 带硬件 FP8(PRO 6000 是软件 FP8)。单卡推理或 QLoRA 微调,PRO 6000 性价比更好;8 卡 NVLink 大分布式,H100 起才是主场。
多卡扩展:加卡不等于加速
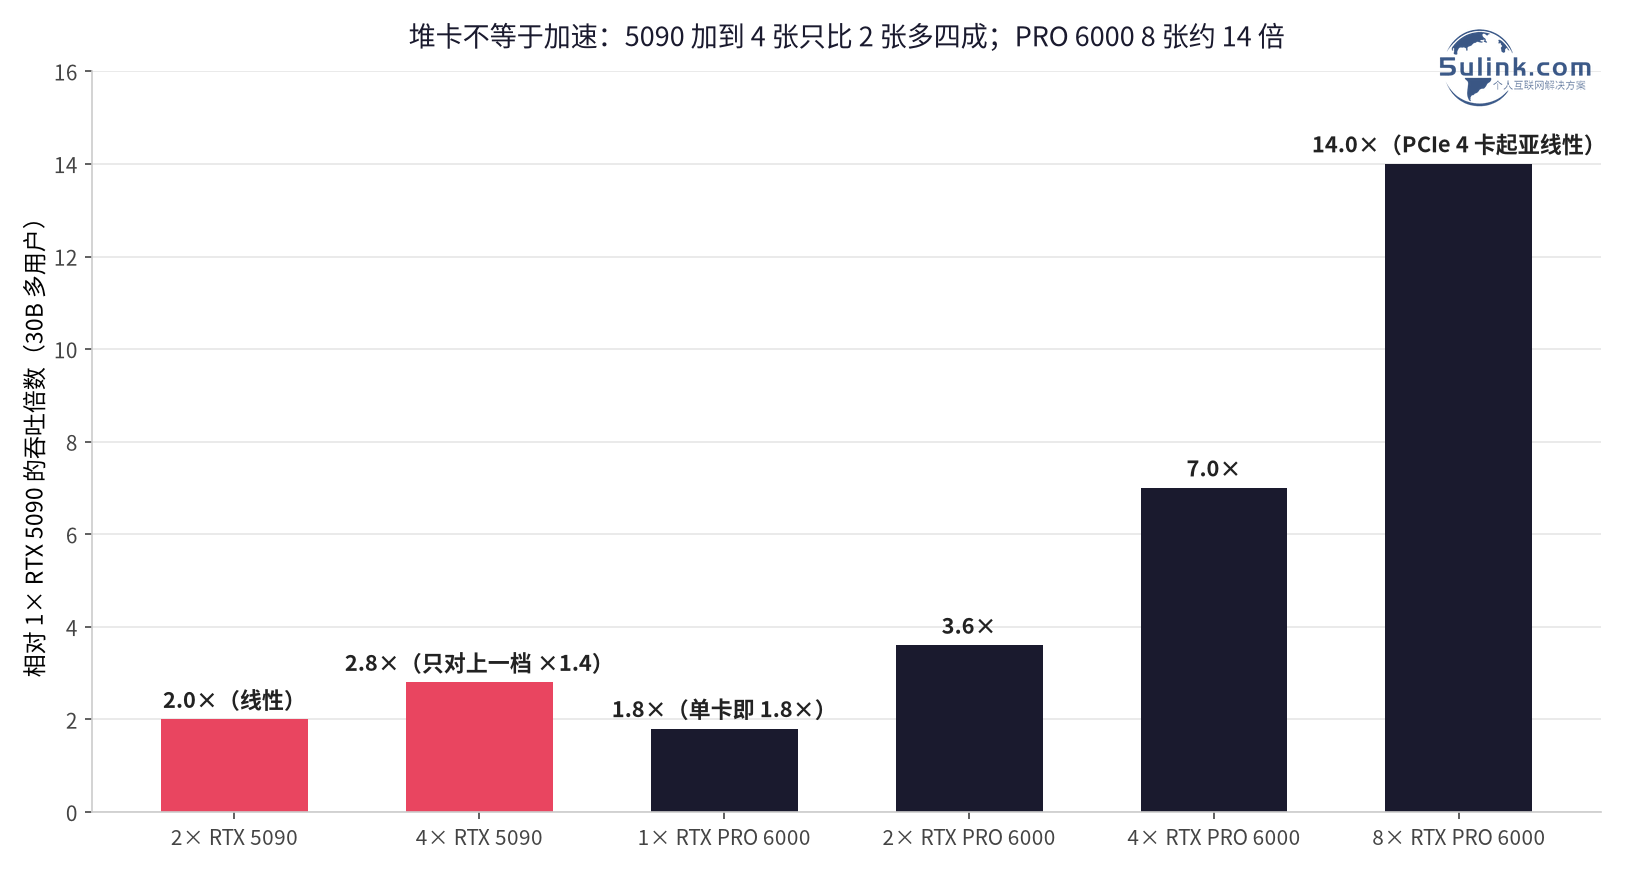
图:相对 1× RTX 5090 的吞吐——PCIe 互联开销让 4 卡以上扩展变成次线性(数据:VRLA Tech 原文表格)
| 配置 | 合计显存 | 相对吞吐 | 备注 |
|---|---|---|---|
| 1× RTX 5090 | 32 GB | 基准 | 单用户,30B 以内 Q4 |
| 2× RTX 5090 | 64 GB | ~2×(线性) | 30B 张量并行线性扩展;可装 Llama 4 Scout Q4 |
| 4× RTX 5090 | 128 GB | 仅 ~1.4×(对 2×) | **PCIe 带宽在 4 卡处封顶**,瓶颈转向 CPU/内存/负载均衡 |
| 1× PRO 6000 | 96 GB | ~1.8× | 单卡 70B FP8;生产多用户服务 |
| 2× PRO 6000 | 192 GB | ~3.6× | Qwen 3 235B-A22B Q4;70B FP16 |
| 4× PRO 6000 | 384 GB | ~7× | 405B FP8;大规模多用户 |
| 8× PRO 6000 | 768 GB | ~14× | 4U EPYC 服务器形态;企业级 LLM 服务 |
2 卡还线性,4 卡起就次线性——这是 PCIe 互联的税。想靠堆卡线性提速,要么留在 2 卡,要么上带 NVLink 的平台。
买家对照
| GPU | 适合 | 不适合 |
|---|---|---|
| RTX 5090(32GB) | 独立开发者、7B–30B 本地推理、原型验证、预算型工作站 | 70B 模型、规模化多用户、要求 ECC 的环境 |
| RTX PRO 6000(96GB ECC) | 单卡 70B 推理、多用户生产服务、QLoRA 微调、合规/ECC 环境 | 需要 NVLink 规模的多节点分布式训练 |
| H100 PCIe(80GB) | 多卡 NVLink 训练、MIG 多租户切分、大型分布式负载 | 单卡口径下和 PRO 6000 拼每 token 成本 |
| H200(141GB) | 70B FP16、100B+ 推理、长上下文大 KV 缓存 | 没有数据中心基础设施/采购渠道的团队 |
| B200(180GB) | 超大规模训练、长上下文推理、基座模型工作 | 数据中心之外(供电散热) |