Kubernetes v1.37 Garhwal 发布解读:67 项增强背后的运维逻辑变化
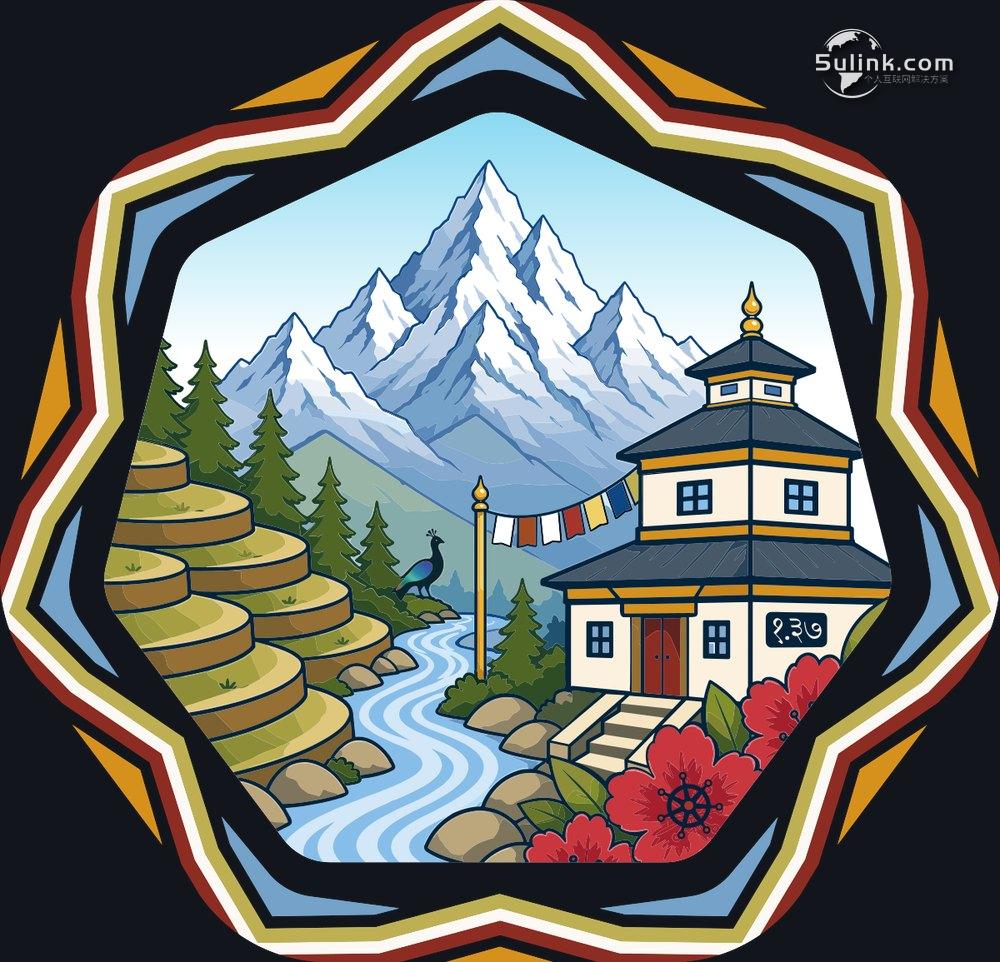
每一次 Kubernetes 大版本更新,官方都会在博客里放一张手绘风的主题徽标,然后在正文里写一段关于自然风光的题记。v1.37 的徽标主题是 Garhwal——印度北阿坎德邦的一个喜马拉雅山区,雪峰、雪松林、梯田、河流和山居构成了画面四周用 ringaal 竹篾编织的边框,屋子上的门牌是天城文数字「१.३७」。
官方给出的设计解释和发布本身其实说的是同一件事:这个版本里的每一层、每条路径、每一份贡献都是相互咬合的。但站在运维视角看,v1.37 的核心变化不在徽标,而在控制面稳定性、弹性伸缩能力边界、以及硬件资源调度模型这三块同时推进。
数字先摆出来:这一版的成分表
官方发布说明的第一段就给出了完整构成:67 项增强,其中 16 项升为 Stable、23 项转入 Beta、27 项首次进入 Alpha,另有 1 项弃用/移除。
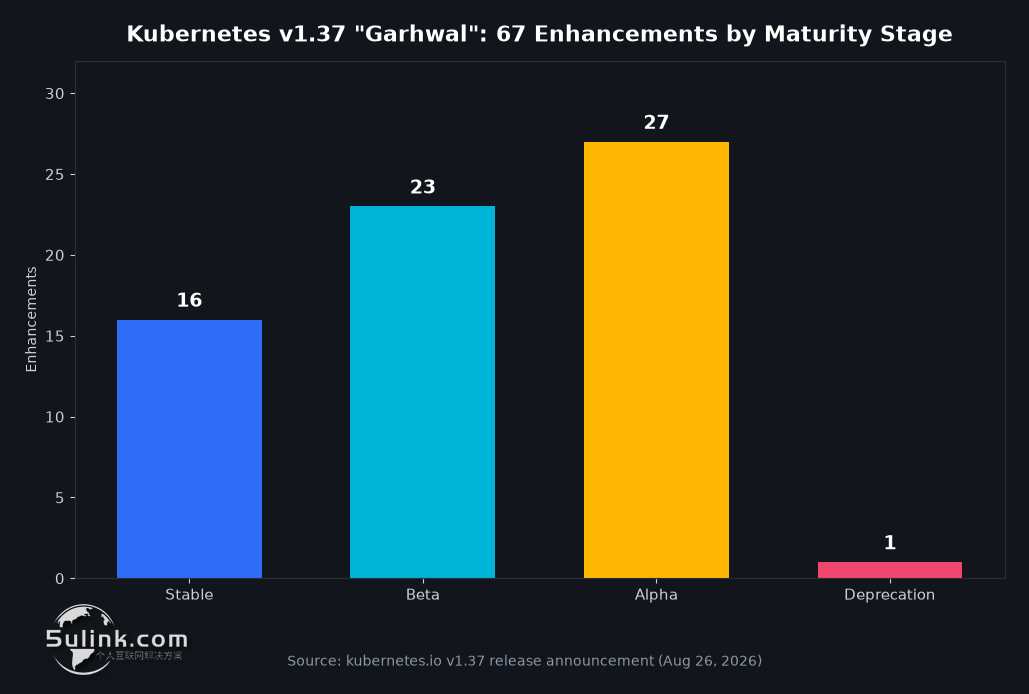
这个比例延续了 Kubernetes 近年来的节奏:新东西进得快,真正能进 Stable 的门槛依然很高。对平台团队来说,阅读 v1.37 的正确姿势不是”看哪个特性最酷”,而是”哪几项会在下一个季度影响我的控制器和客户端代码”。
四个必须知道的硬变化
一、Resilient watchcache 初始化正式 Stable(KEP-4568,SIG API Machinery)
ResilientWatchCacheInitialization 在 v1.34 就已 Stable,v1.37 把剩下的 WatchCacheInitializationPostStartHook 也推到 Stable 并锁定。
实际影响是:kube-apiserver 启动和恢复过程中,watchcache 的初始化与重建不再对 etcd 造成请求尖峰,也不会让请求堆积在缓存预热阶段。现在 API Server 会把有界的 list/watch 请求安全下放,超出容量的请求直接返回 HTTP 429,而不是无限堆积直到把 API Priority and Fairness 的配额打满。
这一条对写自定义 controller / operator 的团队是直接的代码责任:你的客户端必须能优雅处理 429、读 Retry-After 头、并做指数退避。升级前没做这件事的,大规模集群里 API 抖动一次就够你debug半天。
二、HPA 缩容到 0 进入 Beta 且默认开启(KEP-2021,SIG Autoscaling)
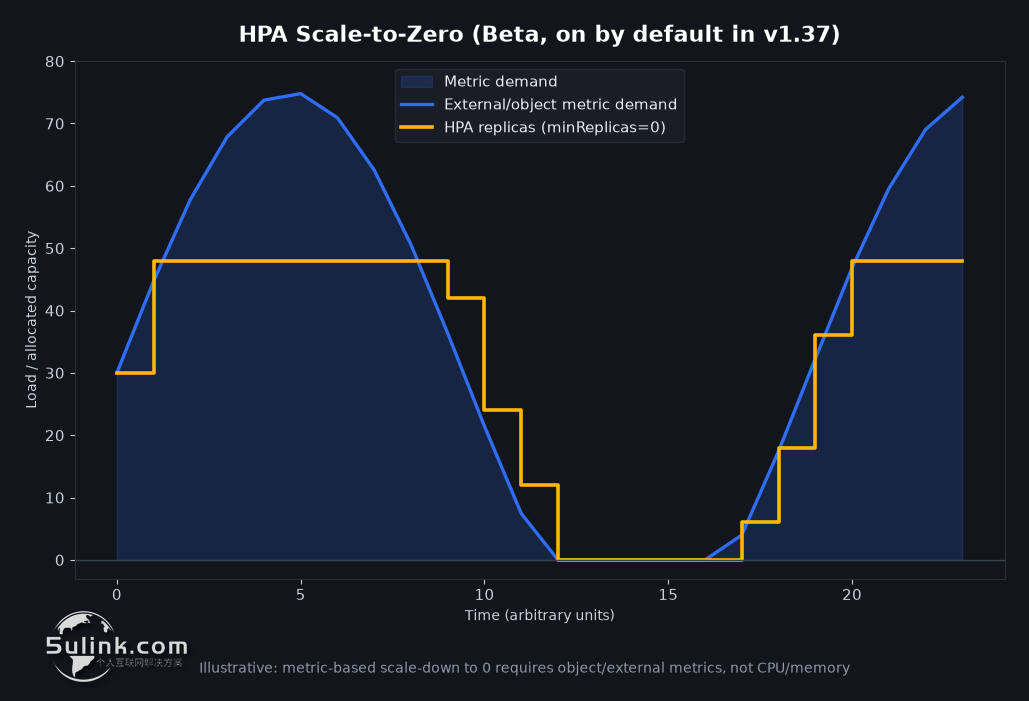
这个特性从 v1.16 引入,到 v1.37 终于毕业,并且默认启用。只要把 spec.minReplicas: 0 设上,基于对象型或外部指标的工作负载在空闲时可以缩到零副本,有需求回来再恢复——队列消费者、批处理任务、GPU 工作负载省钱效果最直接。
有一个容易被忽略的边界:基于 CPU 和内存指标缩容到 0 不支持,因为这两类指标本身就依赖活跃的 Pod 存在。它是给”有排队才干活”这类场景用的,不是给普通 Web 服务用的。
同时,HPA 在把工作负载按住零副本期间,会在 status 里记录一条 ScaledToZero=True 条件;控制器据此区分「是我缩到零、指标回来会拉起」和「你手动把副本设成了 0」,恢复后置为 False、原因为 NotScaledToZero。
三、Pod 级 checkpoint/restore 进入 Alpha(KEP-5823,SIG Node)
CRI 扩展了 CheckpointPod 和 RestorePod 两个 RPC,允许 kubelet 与兼容的容器运行时为整个 Pod 创建检查点并从检查点恢复。
注意两个限制:这是 Alpha;而且你的容器运行时必须自己实现这两个新 RPC,否则功能不生效。目前这条更像”接口先立好、生态慢慢追”的信号,对有状态工作负载的备份方案设计是个提前量。
四、DRA 一批特性集体 GA
v1.37 里 DRA 有四项升 Stable:
DeviceTaintRule 按选择条件批量污点化设备(比如某个驱动管理的全部设备)。这是把”哪块卡归哪台机器用”这件事从运维脚本搬进调度器的关键一步。resource.kubernetes.io/numaNode 标准化(KEP-6072):定义统一的 NUMA 节点设备属性名,不同 DRA 驱动不再各定义各的,才能跨驱动比较同一 NUMA 归属。因为只是命名与注册类 KEP,直接以 Stable 落地,无 feature gate、无 in-tree 行为变更。abc.example/gpu: 3 这种传统 extended resource 请求,不再必须依赖独立的 device plugin,可以直接分配给 DeviceClass 并由 DRA 分配设备。ResourceClaim 的 .status.devices(KEP-4817):驱动可以回报每个已分配设备的标准化状态数据——对网络设备来说,此前 Pod 通过 DRA 申请网络设备后,系统里没有任何组件能拿到分配到的 IP 地址,这个字段补上了这块拼图。官方 Release Team 点名的另外几项
| 特性 | 阶段 | KEP / SIG | 实际含义 |
|---|---|---|---|
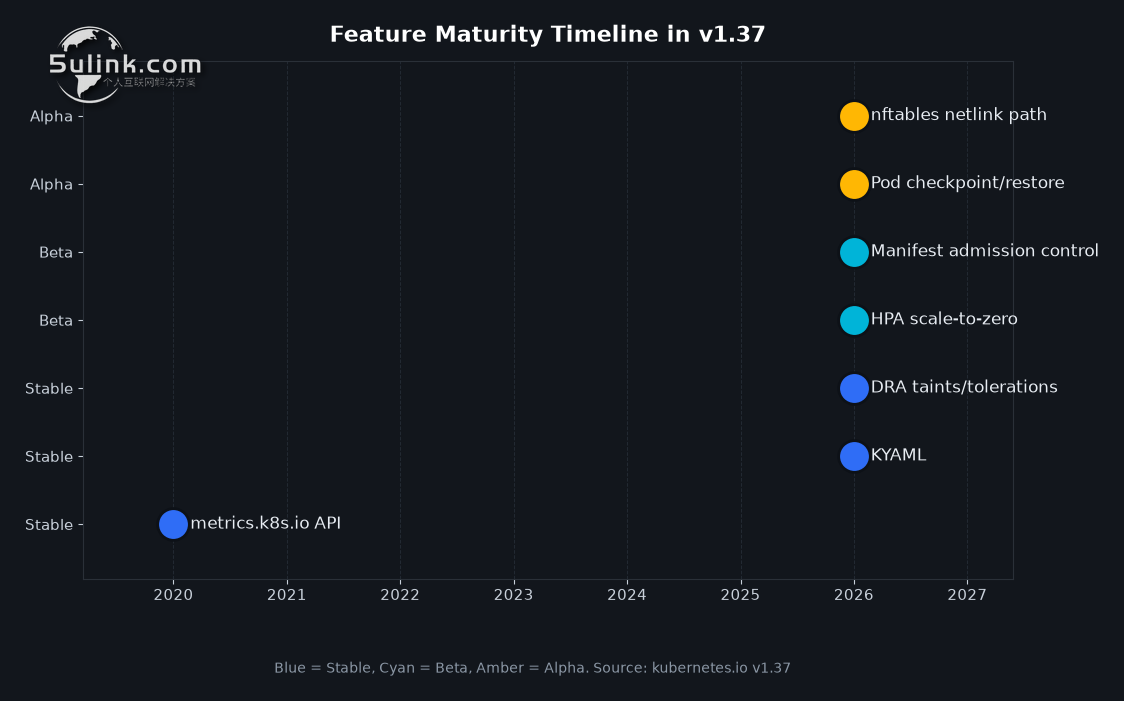
| Manifest 准入控制配置 | Beta | KEP-5793 / API Machinery | 准入 webhook 与 CEL 策略可从磁盘 manifest 加载,不必只存在 API 里;API Server 启动即生效,etcd 挂了也能继续执行,还能反过来保护 API 里的准入资源不被篡改 |
metrics.k8s.io API |
Stable | KEP-5207 / Instrumentation | 在 Beta 待了**近九年**后终于 GA,kubectl top 和 HPA 的底层数据接口有了稳定版本 |
| KYAML | Stable | KEP-5295 / CLI | 面向 Kubernetes 的 YAML 子集,kubectl get -o kyaml 转正;它是 YAML 的合法子集,不是替代品,现有 manifest 和流水线不用改 |
| SELinuxMount / SELinuxChangePolicy | Stable | KEP-1710 / Storage | 卷挂载改用 -o context= 而非递归重打标,**但前提是 CSI 驱动在 CSIDriver 上显式 seLinuxMount: true** |
| Node declared features | Stable | KEP-5328 / Node | 节点通过 .status.declaredFeatures 声明自己支持哪些已毕业特性,控制面据此处理版本偏斜;kubelet 启动时确定,改动需重启 kubelet |
| StorageVersionMigration API | Stable | KEP-4192 / API Machinery | storagemigration.k8s.io/v1 内置进控制面,API 升级后可声明式迁移存量资源存储版本 |
| Pod certificates / ClusterTrustBundles | Stable | KEP-4317 / KEP-3257 / Auth | Pod 可通过 podCertificate 投影卷拿到私钥与 X.509 证书,并挂载信任锚 |
nftables 本地 NodePort 用户态代理 |
Alpha | KEP-6032 / Network | 补齐 nftables 后端相对 iptables 的缺口,NodePort 可经 localhost 访问(IPv4/IPv6) |
三个容易被跳过的破坏性细节
SELinux 卷标签行为变更是真陷阱。 v1.37 之后卷默认不再递归重打标,改为挂载时指定单一 context。问题是一个挂载点只能带一个 SELinux context:此前在同一节点上共享同一卷、但 SELinux 标签不同的 Pod,可以在递归重打标模式下共存,现在可能直接启动失败。如果你的工作负载属于这一类,需要显式把 Pod 的 .spec.seLinuxChangePolicy 设回 Recursive。另外该行为要到 v1.38 才彻底锁定,集群级关闭还留有一个版本的窗口。
kube-dns 正式弃用。 CoreDNS 从 v1.13 起就是默认 DNS 插件,kube-dns 早已跟不上 EndpointSlice 和双栈 Service 的进度。官方已把 node-local-dns 拆到独立仓库继续维护,并预计 v1.40 之后不再为 kube-dns 构建新包。还在跑 kube-dns 的集群,迁移计划该提上日程了。
kube-proxy 的 ipvs 模式进入弃用倒计时。 原因很直白:ipvs 模式下底层仍在用 iptables(KEP-3866 的结论就是”ipvs 模式救不了 kube-proxy”)。时间表是:v1.40 默认禁用(仍可通过 feature gate 选择),v1.43 彻底移除。现在启动会打弃用警告。
其他值得记一笔的改动
nftables 后端性能优化:kube-proxy 改走内核 netlink 接口操作 nftables 规则,绕过 nft 命令行工具,规则管理更高效。这与 ipvs 弃用、localhost NodePort 补齐一起看,是 nftables 取代 iptables 路线图上的三块拼图。maxUnavailable 重新默认开启。v1.36 曾因缺陷(初始修订有问题的 StatefulSet 创建出永远不 ready 的 Pod,MaxUnavailableStatefulSet 开启时控制器无法把它更新到新的正确修订,导致 Pod 无限 CrashLoopBackOff,kubernetes#137409)被关闭,v1.37 修好后恢复默认。小夏点评
一、v1.37 的真正主题是”控制面别被自己打死”。 watchcache 弹性初始化、ScaledToZero 条件、manifest 准入控制,三件事指向同一个方向:把 API Server 从”请求洪水来了就硬扛”改成”有界、有序、有条件地放行”。Kubernetes 的规模已经大到用户自己写的 controller 就足以把控制面打挂,这是个必然的历史阶段。
二、Alpha 特性占比接近四成,提醒我们别急着追新。 27 项 Alpha 里绝大多数离生产还远,Pod 级 checkpoint/restore 还要等运行时跟上,DRA 的污点机制虽然 GA 但需要驱动侧配合。真正该在这个版本投入精力的,是已经 Stable 且改变了客户端契约的那几项——尤其是 429 退避。
三、给国内 IT 运维和开发者的实际启示:把 v1.37 当作一次”契约审计”的机会,而不是一次”功能尝鲜”的机会。 具体三步:其一,把所有自研 controller 的 429 + 指数退避路径写进代码并做故障演练,这是升级前必须完成的硬性检查;其二,把 ipvs 弃用和 kube-dns 迁移排进未来两个版本的时间表,尤其是还在用 ipvs 模式扛高 Service 数量集群的团队,越早评估 nftables 越省事;其三,如果你正在做 GPU 池化或异构算力调度,DRA 的设备污点、numaNode 标准化和扩展资源直连是这一版最值得押注的能力——它意味着”把某类卡绑定给某类任务”终于可以用原生声明式的方式表达,而不必再自己造一层 device plugin 或改调度器逻辑。国内大量智算中心正处在”卡多、机型杂、调度需求强”的阶段,这三项能力落地后,此前靠外部编排器做的那层调度定制有机会被标准 API 收编。