Google 开源 XLA Serving Engine:内部生产跑到 600 万 QPS,为什么它不是 vLLM 的替代品
2026 年 11 月 5 日,Google 在 Open Source Blog 上把一个已经在内部跑了数年的推理引擎开源了:XLA Serving Engine(XSE)。开源公告里的数字很炸——Google 内部生产环境超过 600 万 QPS,跑的是 YouTube Shorts、Google Ads、Search 以及部分 Gemini Omni 的模型端;客户案例里 Moloco 每天处理 650 亿次推理,峰值 1050 万 QPS。
但公告里还有一句更该被先读到的话:官方把 XSE 定位为 “a lightweight, one-shot inference engine”——轻量级的一次性推理引擎,并且明确说长上下文 LLM 场景仍然应该用 vLLM 或 SGLang。
这两句话放在一起,才是这个项目的正确打开方式。它不是”又一个 vLLM 替代品”,而是 Google 把 JAX 训练栈在在线推理上的最后一块拼图补齐之后,顺手把内部那套无 Python 请求路径的开销还给了社区。对国内团队来说,它的意义也不在于”能不能打败 vLLM”,而在于当你的模型是 JAX 训练出来、跑在 TPU 或要跨 TPU/CPU/GPU 复用时,你有没有一条不经过 Python 的服务链路。
一、XSE 是什么:一条没有 Python 的请求路径
XSE 的技术路线不复杂,但非常”谷歌”:模型侧用 jax.export 把 JAX 模型导出成自包含的 XLA SavedModel(计算部分用 StableHLO,权重交给 Orbax 管理),服务侧用一个 C++ 运行时(PJRT / IFRT)通过 gRPC 对外提供服务。
关键点在于:请求路径上没有 Python,也没有 GIL。这意味着它不受 CPython 全局解释器锁的约束,不需要靠”多进程复制模型”来吃满 CPU,也不需要在请求路径上反复穿越 Python ↔ C++ 的边界。
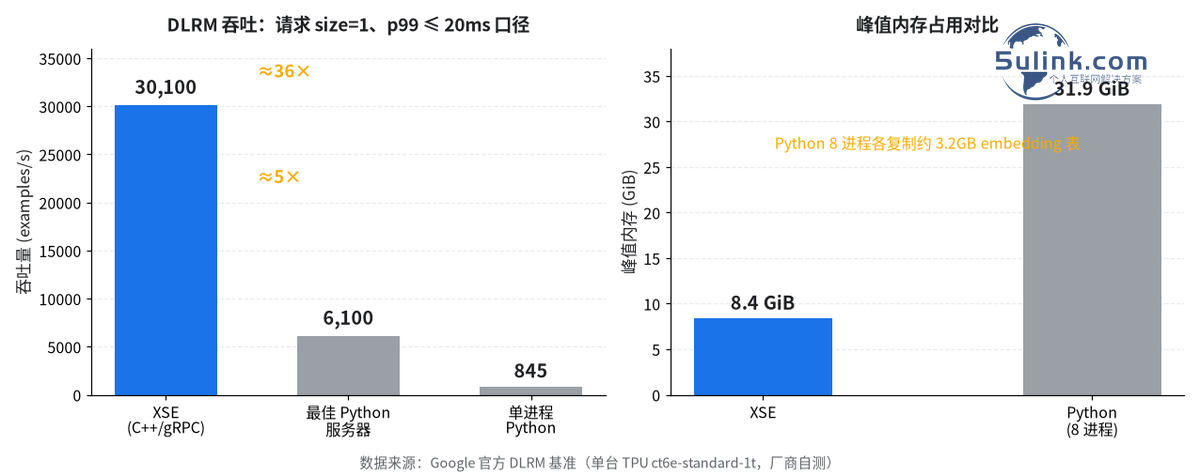
图:XSE 与 Python 服务的吞吐、峰值内存对比(数据均取自 Google 官方 DLRM 基准页,本文整理绘制)
官方给出的支持矩阵覆盖面也不窄:CPU、NVIDIA GPU、Cloud TPU 三类硬件,单机与多机部署,支持动态批处理,并提供官方 Docker 镜像直接可用。官方还特别强调了一个跨硬件复用的卖点:同一个模型因为是 XLA 计算图,可以在 TPU 上训练完、再跑到 CPU 或 GPU 上推理,靠的是 XLA 的可移植性。
另一条被反复提及的工程收益是资源占用:官方称相比 Python 服务,CPU 时间降低 30–70%,内存降到约 1/4。
二、仓库现状:v0.0.13,不是 1.0
先泼一盆必要的冷水——这个项目非常早期。
| 项目 | 现状 |
|---|---|
| 仓库 | openxla/xla-serving(Apache-2.0 许可) |
| 仓库创建时间 | 2026-02-12(不到一年) |
| 最新 tag | v0.0.13(2026-11-03) |
| 社区热度快照 | 22 stars / 51 issues(issue 多于 star) |
| 文档 | readthedocs 官方文档站,含入门指南与 DLRM 基准页 |
22 个 star、51 个 issue 这个组合本身就是信号:star 少说明关注度还没起来,issue 多说明坑还很多。用行业通行的话说,这是 pre-1.0 的早期阶段,谈”生产就绪””正式发布”都为时过早。
Apache-2.0 是个加分项——商用友好、无 copyleft 传染。国内想改就改的团队不会在许可证上被卡住。
三、生产数据:600 万 QPS 与 Moloco 的 650 亿次/日
先看最容易被拿来当标题的数字。Google 官方博客披露,XSE 在其内部生产环境中支撑 超过 600 万 QPS,服务对象包括 YouTube Shorts、Google Ads、Search,以及部分 Gemini Omni 的模型端(注意:是模型端推理,不是 Gemini 文本生成服务本身)。
客户案例方面,Moloco 称自己通过 XSE 每天处理 650 亿次推理,峰值达到 1050 万 QPS。
这些数字必须打上”厂商披露“的标签。600 万 QPS 是 Google 自家生产环境的口径,读者无法审计其请求定义、batch 策略和硬件构成;Moloco 的 650 亿次/日与 1050 万 QPS 同样来自厂商材料,尚无第三方复现。
即便如此,这组数字仍然有意义:它至少说明 XSE 不是玩具。一个刚开源半年、v0.0.13 的项目,能被推到 Google 核心广告与搜索链路的模型端生产流量上,说明它在稳定性、运维工具和故障恢复上的成熟度已经过了”实验项目”这道门槛。这跟”开源仓库 star 数少”并不矛盾——Google 内部先跑通了,开源是后来才发生的事。
四、DLRM 基准:把数字摊开看
官方唯一公开的基准是 DLRM(Deep Learning Recommendation Model,DeepFM 系推荐模型),这也是目前 XSE 公开数据的全部。基准环境是单台 TPU ct6e-standard-1t:44 vCPU EPYC / 173 GiB 内存 / 1× TPU v6e。
4.1 短请求吞吐:5× 和 36×
在 request size = 1、p99 ≤ 20ms 这个口径下:
| 实现 | 吞吐(examples/s) | 相对 XSE |
|---|---|---|
| XSE | 30,100 | 1×(基准) |
| 最佳 Python 服务器 | 6,100 | 约 1/5 |
| 单进程 Python | 845 | 约 1/36 |
也就是官方博客里的两句话:短请求吞吐为最佳 Python 服务器的 2–5×,为直白 Python 实现的 8–36×。
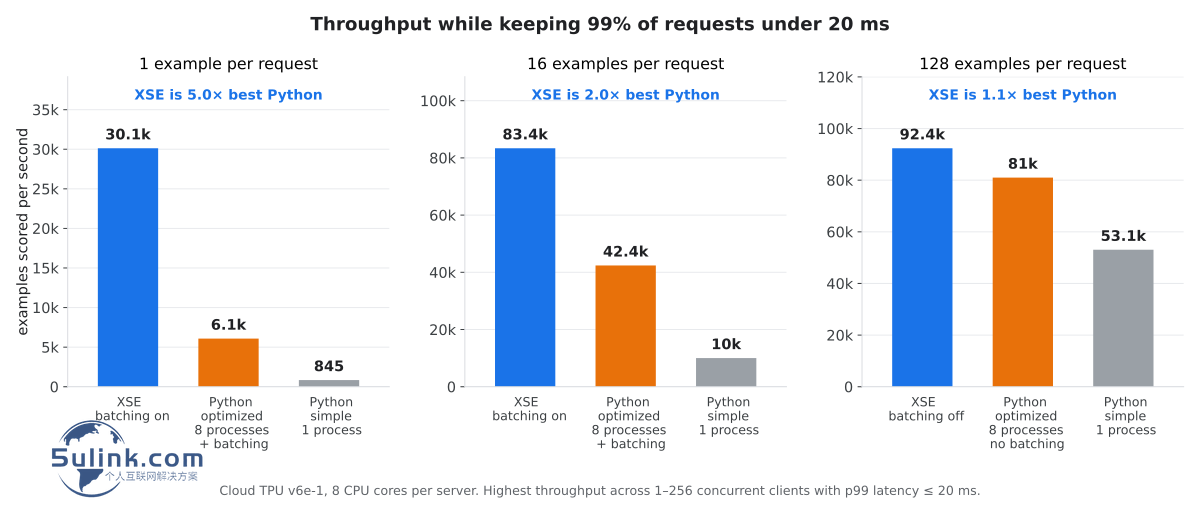
图:官方 DLRM 基准吞吐图(图片来源:XLA Serving Engine 官方文档 benchmarks 章节)
峰值数据:30,126 req/s @ p99 = 16.4 ms,而且此时 8 个 vCPU 核心只用了 6.75 核——说明瓶颈已经在 TPU 侧而不是主机 CPU 侧,CPU 还有余量。
4.2 请求变大之后,差距迅速收窄
| request size | XSE(examples/s) | 最佳 Python(examples/s) | 倍数 |
|---|---|---|---|
| 1 | 30,100 | 6,100 | ≈ 5× |
| 16 | 83,400 | 42,400 | ≈ 2× |
| 128 | 92,400 | 81,000 | ≈ 1.14× |
这张表是全篇最重要的一张表。原因很简单:XSE 的优势来自”没有 GIL、没有进程间模型复制”。请求越大,一次请求里能摊到的 Python 侧开销占比越低,动态批处理的收益也越容易被硬件本身吃满。size=128 时 XSE 只快 14%——这恰恰说明,如果你要做的是长 prompt 的 LLM 推理,XSE 那个”5×”完全用不上。
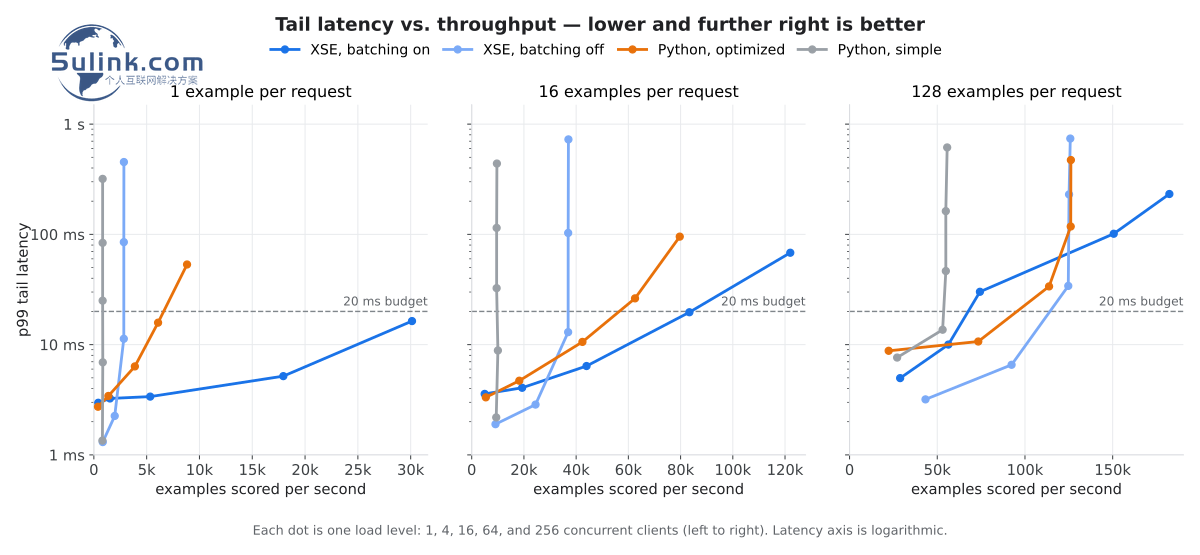
图:官方 DLRM 延迟与吞吐关系曲线(图片来源:XLA Serving Engine 官方文档)
4.3 CPU 与内存:3.4× 和 1/4
| 指标 | XSE | Python | 对比 |
|---|---|---|---|
| 主机 CPU 时间 / 1000 examples | 0.224 | 0.770 | 约 3.4× 优势 |
| 峰值内存 | 8.4 GiB | 31.9 GiB | 约 1/4 |
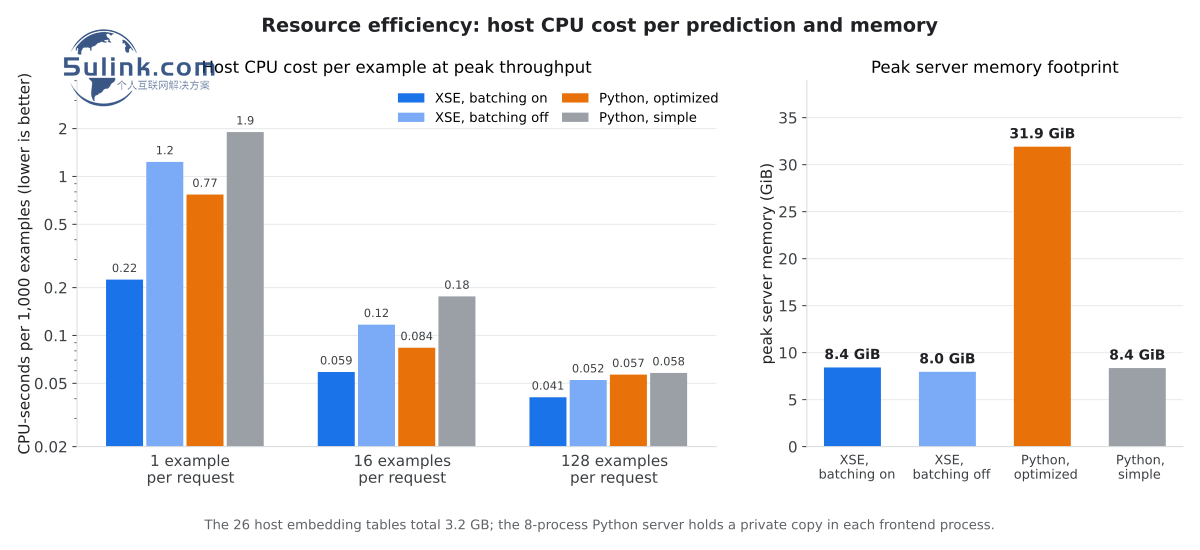
图:官方 DLRM 基准中的 CPU 与内存占用(图片来源:XLA Serving Engine 官方文档)
内存那一栏背后的机制值得展开:Python 方案为了突破 GIL 限制跑了 8 个进程,每个进程各自复制约 3.2GB 的 embedding 表,于是 31.9 GiB 里绝大部分是重复的权重副本。XSE 用一份权重 + C++ 并发,把这个问题直接消掉了。这也是官方给出”内存降到约 1/4″这个说法时,指的正是这类多进程权重复制场景。
另外两个细节:单 Python 进程在 8 核机器上只用到 1.6–1.8 核;不做批处理时,Python 路径被卡在约 2,000–2,800 calls/s。而 XSE 的 C++ embedding kernel 在 size=128 下达到 24,500 examples/core-s。
4.4 尾延迟:数量级的差异
在 80% 负载下:
| 场景 | XSE p99 | Python p99 |
|---|---|---|
| 场景 A | 9.6 ms | 583 ms |
| 场景 B | 9.5 ms | 112 ms |
| 场景 C | 9.5 ms | 106 ms |
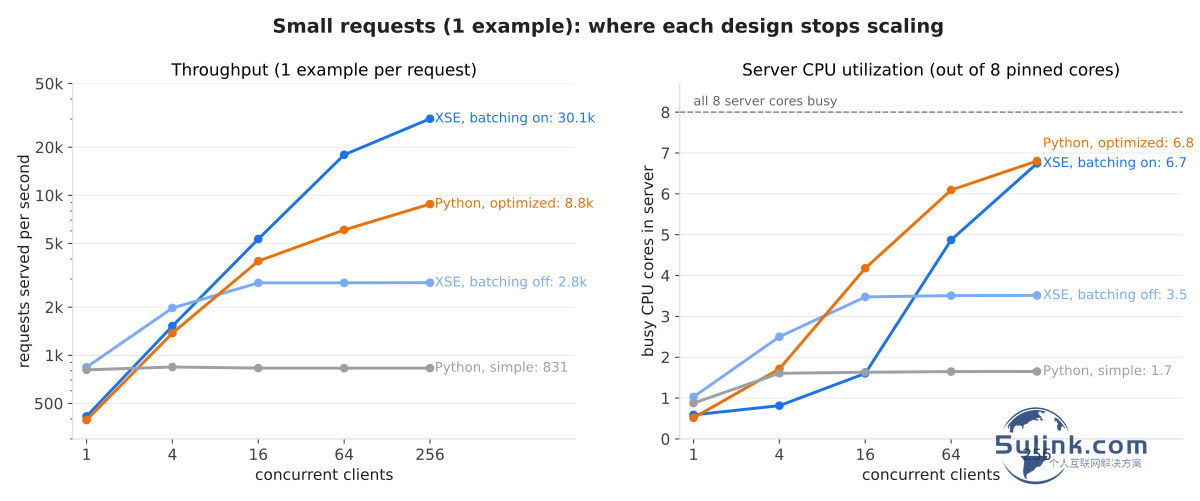
图:官方 DLRM 基准的扩容表现,小请求规模(图片来源:XLA Serving Engine 官方文档)
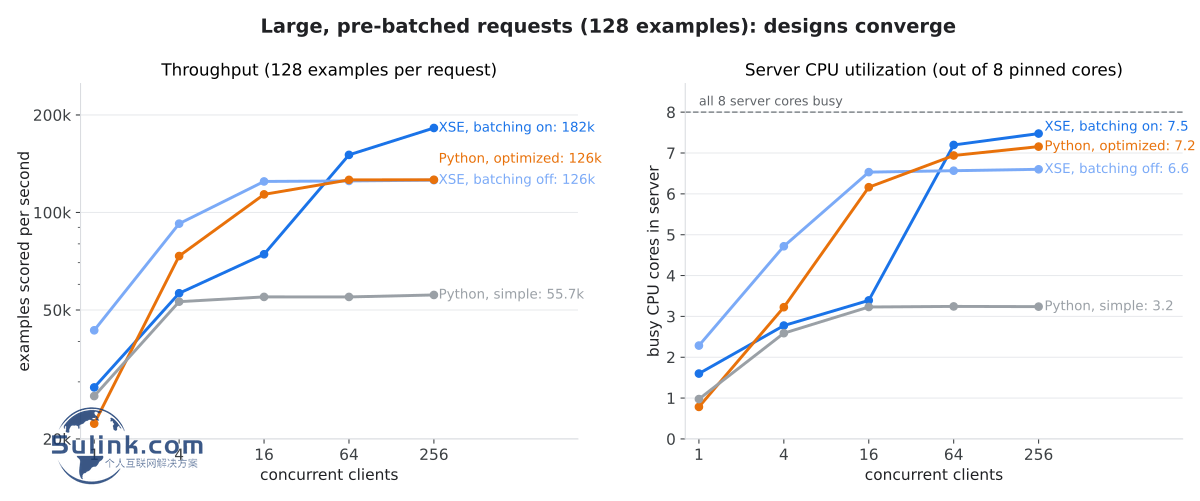
图:官方 DLRM 基准的扩容表现,大规模场景(图片来源:XLA Serving Engine 官方文档)
Python 侧 p99 冲到 583 ms 的原因,通常是 GIL 排队加上多进程负载不均导致的排队抖动;XSE 侧的尾延迟基本被压平在 10ms 上下。对推荐/广告类链路而言,这种尾延迟的稳定性比平均吞吐更重要——点击率、转化率对 p99 抖动远比对均值敏感。
五、关键边界:它不是长上下文 LLM 引擎
这是全篇最容易被误读、也最需要划清楚的一条线。
官方在文档与博客里给出了明确边界,XSE 是 “lightweight, one-shot inference engine“(轻量、一次性推理引擎):
- 1. 官方明确说它不是长上下文 LLM 引擎。文档直言:长上下文 LLM 推理场景仍然推荐 vLLM / SGLang。
- 2. 官方基准用的 DLRM 是推荐系统模型,不是任何 Transformer LLM。所有那些 5×、36×、30,126 req/s 的数字,都是在 embedding + MLP 结构的推荐模型上跑出来的。
- 3. “one-shot”是关键词:它假设的是”输入进来、算一次、输出”,没有 KV cache、没有 prefill/decode 分离、没有连续批处理调度(continuous batching)这些 LLM 引擎的核心机制。
- 4. 没有 Python 请求路径 ≠ 没有 Python 生态依赖。它要求你的模型能被
jax.export导出成干净的 StableHLO 计算图——PyTorch 训练、导出、再服务的路径,以及它和 vLLM 之间在模型覆盖面上的差距,官方没有给出对等方案。
所以正确的说法是:XSE 是 vLLM/SGLang 的”补充品”而不是”替代品”。它覆盖的是 LLM 引擎基本不碰、但规模极其庞大的那类负载——推荐、召回、嵌入、小模型打分。这部分负载在国内外大厂的推理流量里占比极大,只是从来没人把它当成一个独立的”引擎品类”来命名。
六、方法学要打折看
官方数据质量高,但方法学必须打折看。至少四个折扣项:
- – 单一硬件切片:只有 1× TPU v6e(ct6e-standard-1t)一个配置,没有 GPU、没有多机、没有 CPU-only 的对照数据。跨硬件迁移是否真如官方所说”可复用”,没有公开数据支撑。
- – 环回 gRPC:客户端与服务端跑在同一台机器上,网络栈是 loopback,真实跨机网络开销(序列化、丢包、跨可用区带宽)完全没被计入。600 万 QPS 那种规模的部署形态,和单机环回测试之间隔着很远的距离。
- – CPython 3.12 标准 GIL:对照组跑的是标准带 GIL 的 CPython 3.12,并未测试 free-threaded build(3.13+ 无 GIL 版本)。如果对照组的 Python 侧用上无 GIL 版本,差距大概率会收窄——这是这份基准里最”技术性”的一个不确定项。
- – 厂商自测,无第三方复现:所有数据均来自 Google 自家测试环境,目前尚无 InfoQ、The Register、VentureBeat 等媒体的原创深度报道,也无独立第三方复现。issue 数多于 star 的早期仓库,也意味着基准脚本本身大概率还会持续变动。
有两个正面信号可以记下:官方给出的数值一致性为 max|Δ| ≤ 6.3×10⁻⁶(与参考实现基本一致),以及 378 次运行中 0 次 RPC 失败——说明在它的目标负载形态下,请求路径的稳定性是过关的。
七、什么时候该考虑它:给国内团队的实际建议
先做一张对照表,把选型边界划清楚:
| 维度 | XSE | vLLM / SGLang | 传统 Python 服务 | CPU-only 场景 |
|---|---|---|---|---|
| 目标负载 | 推荐/嵌入/小模型 | 长上下文 LLM 生成 | 轻量业务逻辑、低 QPS | 批量离线打分 |
| 请求路径 | 无 Python、无 GIL | Python + 自研调度 | Python + GIL | 无 Python |
| 模型来源 | JAX 训练并可 jax.export |
PyTorch 权重为主 | 任意 | 任意 |
| 硬件 | CPU / NVIDIA GPU / Cloud TPU | NVIDIA GPU 为主 | 任意 | CPU |
| 成熟度 | v0.0.13,早期 | 社区成熟度高 | 成熟 | 早期 |
| 公开基准 | DLRM(推荐模型) | 大量 LLM 基准 | 无 | 无 |
值得考虑它的三种典型场景:
- 1. JAX / TPU 存量用户。如果你的模型本来就是 JAX 训的、机器就是 Cloud TPU 或自建 TPU 集群,XSE 是目前唯一一条”不经过 Python”的生产路径,省下的 CPU 和内存是净收益——在 TPU 机型上 CPU 和内存往往是要单独计费的。
- 2. 推荐 / 召回 / 嵌入类小模型的规模化服务。这类负载请求小、QPS 高、对 p99 敏感,正好落在 XSE 的甜点上。官方 3.4× 的 CPU 优势和 p99 从 583ms 到 9.6ms 的尾延迟改善,对广告、搜索、推荐链路的价值远大于对 LLM 链路的价值。
- 3. CPU-only、成本敏感的自建推理。XSE 在没有 GPU 卡、没有 TPU 的场景里同样能跑,且不需要多进程复制权重表。对预算有限但流量不小的团队,用 C++ 无 GIL 路径替代”8 进程复制 embedding 表”的老写法,是一条现实的降本路径。
不建议现在迁移的场景:
- – 长上下文 LLM / Agent 生成服务。官方自己都建议用 vLLM/SGLang,XSE 缺失 KV cache 管理、连续批处理调度、投机解码这一整套 LLM 推理的关键机制。
- – 模型是 PyTorch 训练、且团队没有 JAX 存量资产。为了用 XSE 而把模型重写成 JAX,迁移成本几乎肯定超过它带来的收益。
- – 追求生产成熟度的团队。v0.0.13 + 22 stars + 51 issues 的组合,运维工具链、监控、升级路径、issue 响应速度都还没有被时间检验。可以先在非关键链路上跑一跑,但别把核心流量一次性压上去。
- – 需要跨硬件统一抽象的团队。官方主推的”同一模型跑 TPU/GPU/CPU”卖点,目前没有公开的多硬件对照数据来验证。
给国内团队的一条现实提醒:XSE 的价值高度绑定 TPU。国内自建推理的硬件主流是 NVIDIA GPU 和各类国产加速卡,XSE 的官方基准里没有任何一张 GPU 或国产卡的数据。这意味着国内团队想用 XSE,先得回答一个问题:你的模型能不能高效地跑到非 Google TPU 上,并且性能不掉? 在这个问题被回答之前,XSE 对大多数国内团队而言更像是一个值得跟踪、值得做技术预研的项目,而不是可以立刻排期的迁移目标。
小夏点评
一、这个项目最值得学的不是性能数字,而是”训练栈向推理栈收敛”这个方向。 JAX 长期以来的尴尬是:训练生态完整,部署生态残缺,团队训完模型往往要再写一套 PyTorch/TensorFlow 推理代码去服务,等于把模型翻译一遍。XSE 用 jax.export + StableHLO + Orbax 补上了这一环,让”训练完就能直接上线”成为可能。这个思路的价值远大于今天那 5 倍吞吐——对国内 JAX 用户来说,它把”要不要为了上线再维护第二份模型代码”这个长期成本给消掉了。至于 600 万 QPS,那是 Google 用几年时间砸出来的可信度,新用户不必也无法在第一天复现。
二、”600 万 QPS”和”不是 vLLM 替代品”这两件事必须一起说,单独说任何一句都是误导。 我尤其反感那种”开源即神器”的叙事——把 DLRM 推荐模型上的 5× 吞吐直接搬到 LLM 场景,是把请求 size 从 1 涨到 128 时优势从 5× 掉到 1.14× 这个最关键的趋势给抹掉了。看到基准数据先问三个问题:什么模型?什么请求规模?对照组有没有开无 GIL?这三个问题能挡掉 90% 的误导性结论。
三、给国内 IT 运维和开发者的具体建议:不要先问”要不要上 XSE”,先花两周做一次”模型资产盘点”。 三条可落地的动作:一是列出你的线上推理模型清单,按”是否 JAX 训练 / 是否 TPU / 是否推荐或嵌入类”三个维度打标——只有同时满足后两条的模型才在 XSE 的射程内,LLM 生成类直接排除;二是如果你手上有 Python 多进程复制 embedding 表的架构,优先在那一类服务上做小规模试点(比如一个召回或打分服务),因为那正是 XSE 收益最确定的场景,迁移路径短、回退成本低;三是在正式立项前先补上两个基准的空缺——你自己的负载在 free-threaded CPython 上是什么表现、同一模型在 GPU 或国产卡上的 XLA 编译效果如何,这两组数据不补齐,任何”性能对比结论”都是空中楼阁。整体建议:把 XSE 当成一条值得预留的技术路线,而不是一次马上要执行的迁移——毕竟它现在才 v0.0.13,仓库里 51 个 issue 还没消化完。
参考链接
- – 官方博客(第一方,2026-11-05,作者 Oleg Shaldybin、Monica Song):《Supercharging XLA inference with the XLA Serving Engine》 https://opensource.googleblog.com/2026/11/supercharging-xla-inference-xla-serving-engine.html
- – GitHub 仓库(Apache-2.0,仓库创建于 2026-02-12,最新 tag v0.0.13):openxla/xla-serving https://github.com/openxla/xla-serving
- – 官方文档首页:XLA Serving Engine Documentation https://xla-serving.readthedocs.io/
- – 官方基准页:DLRM Serving Benchmark(本文所有 DLRM 数字的出处) https://xla-serving.readthedocs.io/en/latest/benchmarks/dlrm_serving.html
- – 官方基准图(吞吐,p99 ≤ 20ms):dlrm_throughput_20ms.svg https://xla-serving.readthedocs.io/en/latest/_images/dlrm_throughput_20ms.svg
- – 官方基准图(延迟-吞吐曲线):dlrm_latency_vs_throughput.svg https://xla-serving.readthedocs.io/en/latest/_images/dlrm_latency_vs_throughput.svg
- – 官方基准图(CPU 与内存):dlrm_cpu_and_memory.svg https://xla-serving.readthedocs.io/en/latest/_images/dlrm_cpu_and_memory.svg
- – 官方基准图(扩容表现,小规模):dlrm_scaling_small.svg https://xla-serving.readthedocs.io/en/latest/_images/dlrm_scaling_small.svg
- – 官方基准图(扩容表现,大规模):dlrm_scaling_large.svg https://xla-serving.readthedocs.io/en/latest/_images/dlrm_scaling_large.svg
- – 官方 logo 资源:xse-logo.png https://xla-serving.readthedocs.io/en/latest/_static/xse-logo.png
- – 官方博客头图:Google Open Source Blog(2026-11-05) https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEi7bCztvKb6VV6dCcC5I9MmnOHelw_dVpUg-2KkcMPy6v7Z32vwoBV_1SxjpsPhoVQ9eNFeWiBp-yFSC4R2MdU4Vykb6rruezGnvif4ujcu5l30rpluAaWLcAPXlxI0ZTQglvxlA-2a3PGl1zhvm1UWUo7EQ8ceu1K_ZJUDJBh0XZTXft_0nECDvbZpBRA/s1600/image.png
- – Google 官方 X 帖:https://x.com/GoogleOSS/status/2118321187428172020
- – Arm 官方 X 帖(转评 XSE):https://x.com/Arm/status/2118448788645843267
- – 二级来源(TokenPost):Google 开源 XSE 以支撑高吞吐 Python 模型服务 https://www.tokenpost.com/news/technology/54872
- – 二级来源(Lavx):Google 开源用于 Python 训练模型高吞吐服务的 XSE https://news.lavx.hu/article/google-open-sources-xse-for-high-throughput-serving-of-python-trained-models
- – 二级来源(TLDR Tech):XLA Serving Engine 摘要 https://tldr.tech/story/7b60df9f-a98e-4abd-8129-73e5df698966
说明:截至本文发稿,尚未检索到 InfoQ、The Register、VentureBeat 等媒体的 XSE 原创深度报道;本文全部硬数据来自 Google 第一方博客、官方文档与官方基准页,文中均已标注为厂商披露口径。