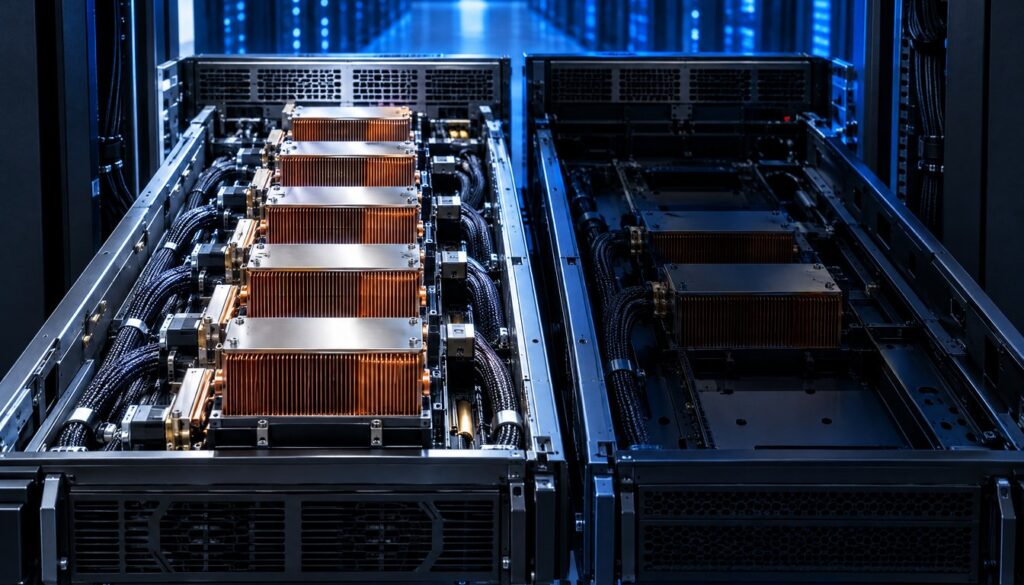
Modular MAX 推理性能超越 vLLM 5.5 倍:Kimi K2.5 基准测试深度解析
Modular 在 MLSys 2026 大会上公布其 MAX 推理栈在 Nvidia B200 GPU 上运行 Kimi-K2.5 模型时,P50 首个 token 生成时间比 vLLM 快 5.5 倍。推理成本已超越训练成本成为企业关注焦点,Modular 试图用统一编译器栈打破硬件厂商锁定。

Share Life
Modular 在 MLSys 2026 大会上公布其 MAX 推理栈在 Nvidia B200 GPU 上运行 Kimi-K2.5 模型时,P50 首个 token 生成时间比 vLLM 快 5.5 倍。推理成本已超越训练成本成为企业关注焦点,Modular 试图用统一编译器栈打破硬件厂商锁定。
狗云服务器优惠