Dynamo 1.0 正式版:把推理拆成分布式流水线,Blackwell 上吞吐最高提 7 倍
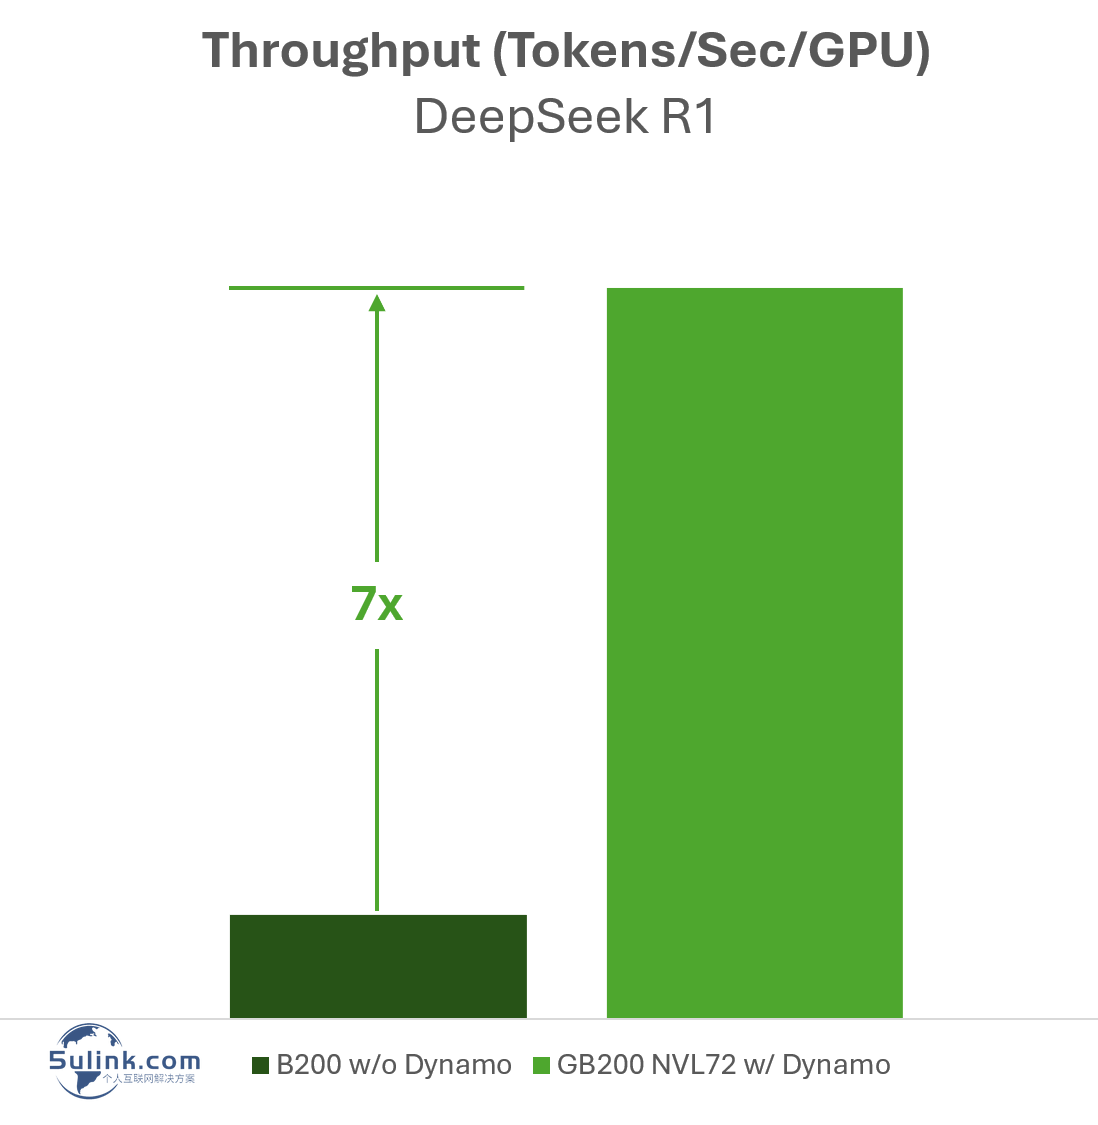
NVIDIA 在 GTC 上正式宣布 Dynamo 1.0 转正。这东西解决的是推理规模化中最脏最累的活:大 MoE 模型单卡装不下,必须拆到多个节点,而拆完之后 KV 缓存怎么搬、路由怎么排、副本怎么起,全是工程深坑。1.0 的底气来自一批已经在生产里跑的客户——字节、CoreWeave、DigitalOcean、Meituan、Tencent Cloud、Together AI 都上了生产。
| 能力 | 数据 | 条件 |
|---|---|---|
| 请求吞吐 | **最高 7x** | GB200 NVL72,分离式服务+宽 EP,DeepSeek R1(FP4,1k/1k),SemiAnalysis InferenceX |
| 首字延迟 TTFT | **降至 1/4** | Llama 3.1 + Hopper,配合 NeMo Agent Toolkit |
| 吞吐(智能体负载) | **1.5x** | 同上 |
| MoE 冷启动 | **快 7x** | DeepSeek v3,H200,ModelExpress |
| 图像请求 | TTFT **-30%**、吞吐 **+25%** | Qwen3-VL-30B,GB200,嵌入缓存 |
智能体提示:KV 缓存终于有了”优先级”
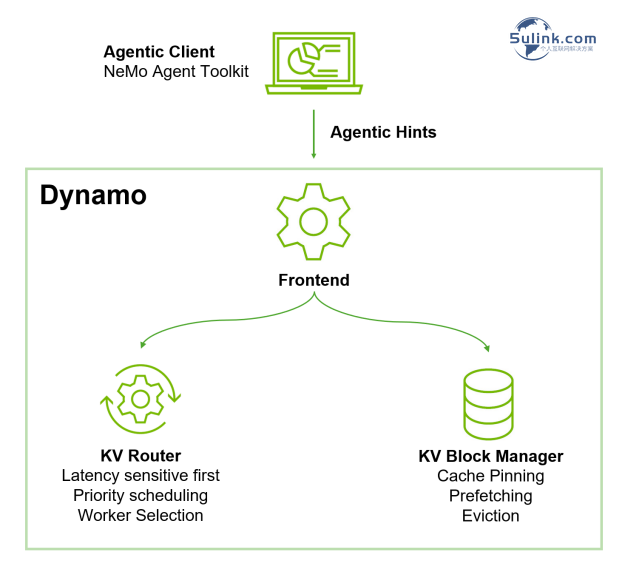
推理引擎过去把所有请求一视同仁:多轮智能体反复复用的系统提示,和一次性的思维链,共享同一条淘汰队列。Dynamo 1.0 把这件事翻了过来——前端 API 接收智能体提示(延迟敏感度、预期输出长度、缓存控制),KV 感知路由器按提示排队列,缓存管理器支持实验性”钉住”:被钉住的节点在指定时长内抗淘汰,顶多挪到主机内存,不直接删。
跑 Llama 3.1 时(Hopper 上,配合 NeMo Agent Toolkit),TTFT 降到 1/4、吞吐 1.5 倍。对做智能体产品的人来说,这比任何单模型跑分都实在。
多模态与视频:拆阶段,加 CPU 缓存
图像密集负载里编码经常是瓶颈,Dynamo 1.0 直接把编码也拆成可独立扩缩的阶段(E/P/D),再用 CPU 侧 LRU 缓存把算过的图像嵌入存下来——重复图像整段跳过 GPU 编码。路由器同步升级”多模态 KV 路由”:先下载图像,再挑缓存重叠度最高的后端。Qwen3-VL 在 GB200 上首字延迟 -30%、吞吐 +25%。
视频生成也被纳入原生支持:FastVideo、SGLang Diffusion、TensorRT LLM Diffusion、vLLM-Omni 全都接了。官方演示里,单张 Hopper 用 Wan2.1 生成 5 秒视频只要 约 40 秒。
ModelExpress:副本冷启动从分钟级压到秒级
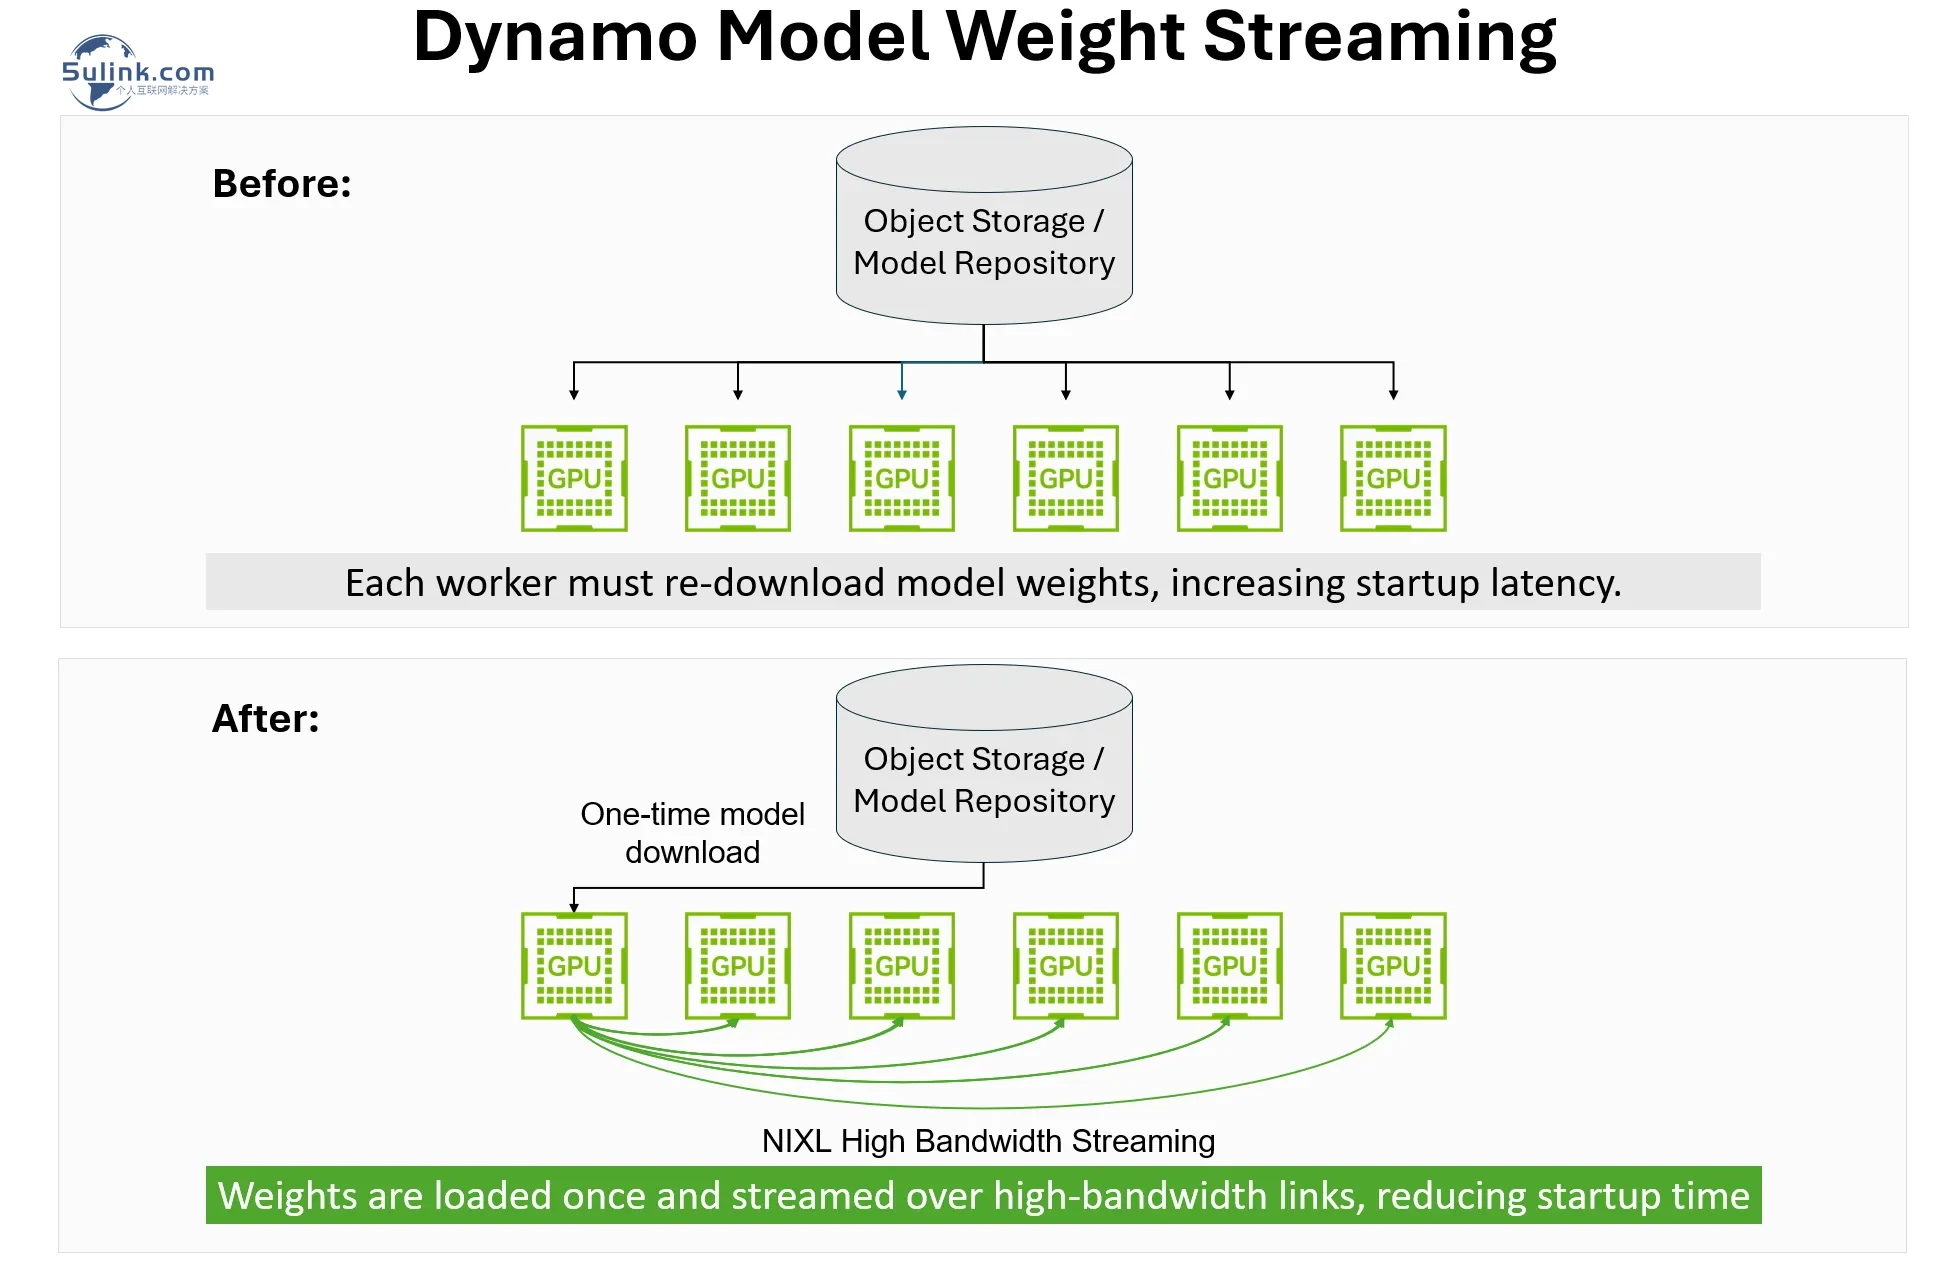
弹性集群每个新副本都要重走一遍”下载权重→加载→编译 kernel→建 CUDA graph”。ModelExpress 两招拆掉这条链路:checkpoint restore 把完整初始化只做一次,新副本从”即服务态”恢复;权重流式传输让第一个 worker 下载一次,其余副本经 NIXL+NVLink 直接收流,不再挤存储带宽。DeepSeek v3 这类大 MoE 的模型装载最快提速 7x。
Grove:机柜级调度的拓扑感知
Dynamo 里的 Grove 负责把 gang 调度、拓扑感知的 AI 负载安放到 Kubernetes 上,1.0 新增了 GB300 NVL72 的 NVLink fabric 自动化:从云区域、可用区一路到机架、主机、NUMA 节点,都能定义放置策略——prefill 和 decode 可以钉在同一 NVL72 机架上优化 KV 传输。AWS、Azure、GCP、阿里云、OCI 的托管 K8s 都已做官方集成。