NVIDIA 在 OCP 2026 交出的三份开放标准:MGX 1.2、800VDC 与 2 秒内恢复的电网韧性
过去几年 AI 数据中心的建设逻辑,是”先选卡,再选服务器,再挤进机架”——机架和供电是被动适应的角色。2026 年 10 月 12 日在圣何塞 McEnery 会议中心举行的 OCP Global Summit 上,NVIDIA 做的事情是把顺序倒过来:先定义机架、供电和软件栈的开放标准,再让生态把加速器填进去。
官方的表述是:”AI 工厂正从兆瓦级走向吉瓦级,而造一座 AI 工厂不只是先进计算的问题。”这句话背后,是本届峰会集中发布的一整套开放规范。
一、MGX 1.2:把机架规格写成标准
NVIDIA 通过 OCP 的 Open DC Initiative,把 Vera Rubin 机架与计算托盘设计贡献进第三代 MGX AI 数据中心参考设计,条件是配合 MQD、MQDB 等开放液冷技术。
更新后的 MGX 1.2 规范具体包含:
| 能力 | 内容 |
|---|---|
| 机架级盲插液冷 | rack-scale blind-mate liquid cooling,无需人工对接管路 |
| 机架级互连 | interoperable rack-scale interconnect infrastructure |
| 液冷 5000A 母线 | 为更高功率系统设计 |
| 原生 19 英寸设备支持 | 兼容既有机房设备 |
| 更高密度机架设计 | 面向单柜高密部署 |
| 无风扇液冷计算托盘 | fanless liquid-cooled compute trays |
| 标准化的供电与冷却接口 | 便于生态互通 |
| 单机架最高 250kW | 支持 rack 级部署 |
官方特别强调,模块化设计(可配置 I/O bay)改善了装配、测试与现场维护的时间,目标是让基础设施的建设与复用更快。
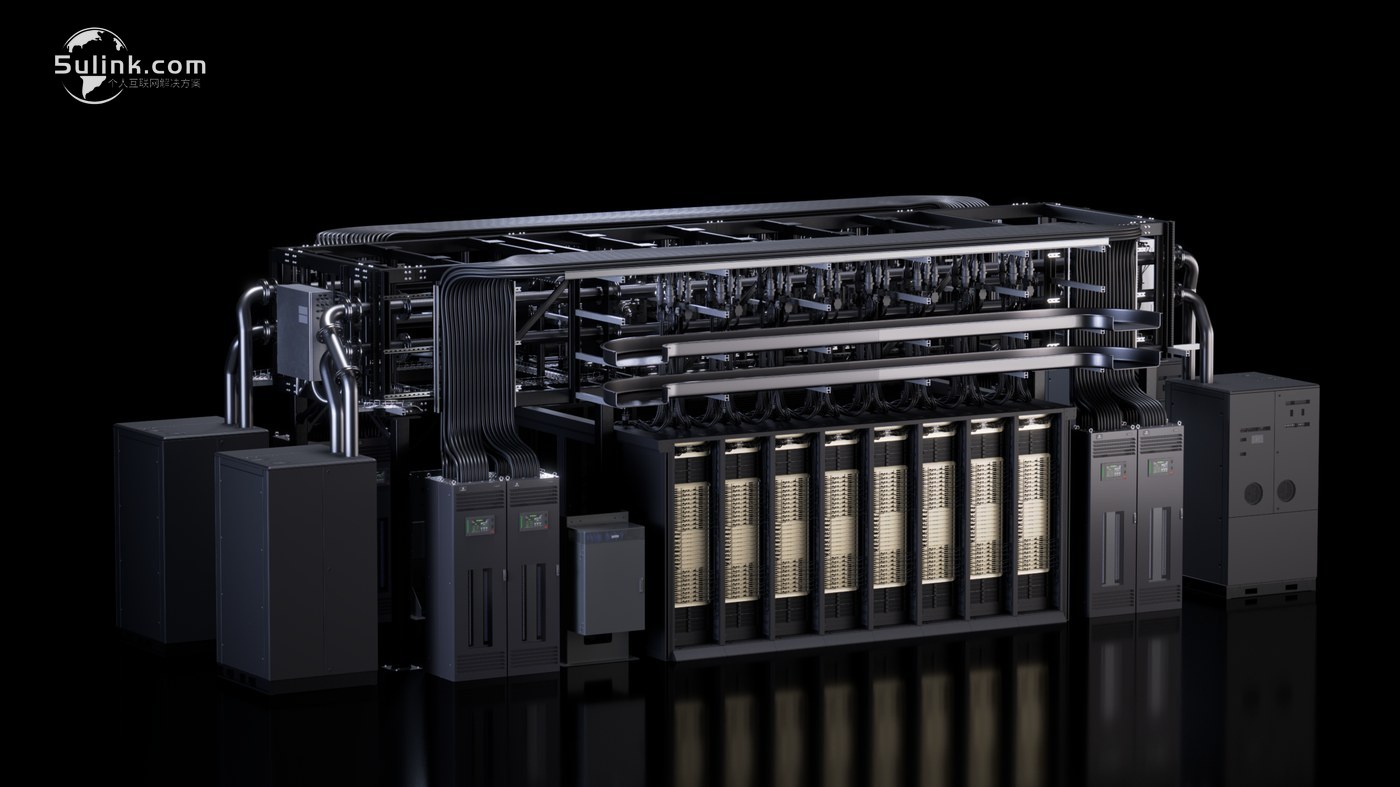
图:面向下一代加速计算的高压直流供电 AI 工厂渲染图(图片来源:NVIDIA 官方博客)
二、DSX OS:四个开源组件,把”机架”变成可编程对象
DSX AI Factory 平台的软件层叫 DSX OS,定位是”开放操作层”,把 DSX 架构变成可协调、可复制的规模化运维。本届峰会上新增四个开源组件:
| 组件 | 解决的问题 |
|---|---|
| NVIDIA Config Manager | 批量自动化交换机配置,部署、校验、维护 AI 工厂网络 fabric,人工介入趋近于零 |
| NVIDIA Cluster Readiness Engine | 用真实负载模拟对 GPU 集群做压力测试,在训练开始前确认硬件健康,减少作业崩溃 |
| NVIDIA Rack Management Service | 提供机架硬件抽象,把机架当作一等公民来管理,改进 AI 工厂规模下的固件管理 |
| Cluster API Provider for NVIDIA Infrastructure Controller | 加速裸金属部署与租户接入,把裸硬件变成生产集群从”数天”缩短到”数小时” |
这些组件源自 NVIDIA 运行 DGX Cloud 的经验,官方表示云厂商与软件伙伴可直接把它们集成进多租户平台。
图:DSX AI Factory 软件栈——从 GPU 基础设施到编排与推理服务(图片来源:NVIDIA 官方博客)
三、两份由超大规模厂商共同发布的规范
这是本届峰会真正有长期价值的部分:规范不再由 NVIDIA 单方面定义,而是由买家和运营方共同写。
Open Data Center Specification v0.7 —— 由 NVIDIA 与 AMD、Google、Meta 联合发布,定义面向下一代 AI 工厂设施设计的统一蓝图,覆盖供电架构、冷却基础设施与物理布局三个层面。
OCP Grid Resilience Specification —— 由 Google、Meta、Microsoft 与 NVIDIA 联合发布,规定大规模 AI 基础设施在电网扰动期间应当如何表现:
| 要求 | 具体表述 |
|---|---|
| 保持连接 | 在电网扰动中维持运行 |
| 自动响应 | 自动检测并响应扰动 |
| 恢复速度 | 在 2 秒内恢复到接近满载 |
这条指标的分量不亚于任何 GPU 参数。传统数据中心的 UPS 设计目标是”撑住断电、慢慢降载”,而 AI 工厂的负载特征是单机架 250kW 起步的巨量恒定负载,一旦掉电再启动,重启时间以小时计。两秒内回到接近满载,本质上是要求把储能、电网交互与调度软件做成一套可编程的系统。
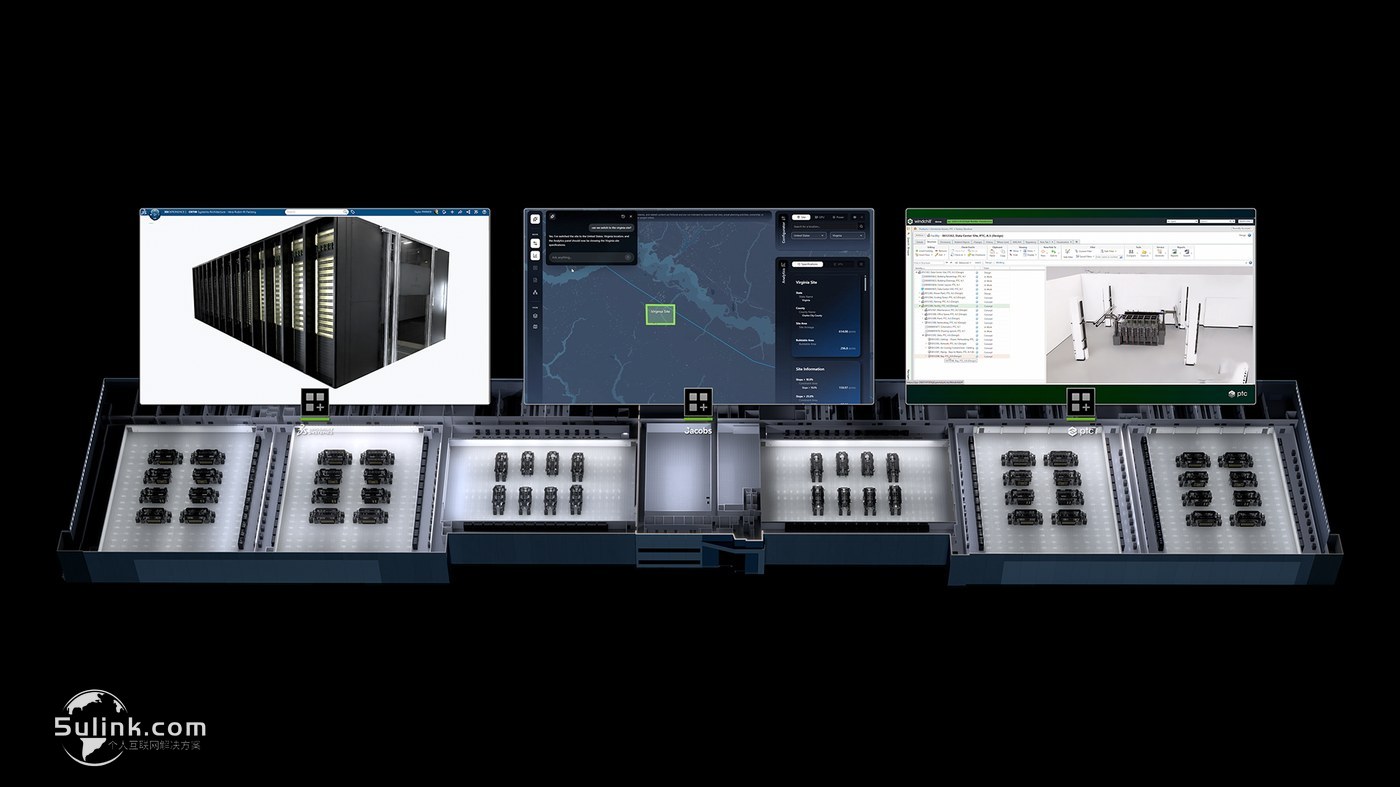
图:DSX AI Factory 平台覆盖计算、网络、供电、冷却、机房与软件(图片来源:NVIDIA 官方博客)
此外,Visionbay.ai 发布了面向 Vera Rubin 时代的 800V DC AI 工厂设计 K-1,结合 NVIDIA 的 800VDC 参考架构与 Vertiv 的供电散热技术,架构上采用集群级电力中心,把 AC-DC 集中转换后再把 800VDC 送近计算节点;并支持分阶段引入高压直流,不必一次性改造整个机房。
四、USFP:面向 400Gb/s 通道的新型可插拔光模块
NVIDIA 与 Cisco 联合宣布的 USFP(Ultra-Dense Small Form Factor Pluggable),是本届峰会唯一的硬件形态新品:
| 指标 | 数值 |
|---|---|
| 尺寸 | 与广泛采用的 200Gb/s-per-lane OSFP 大致相同 |
| 通道规划 | 16 条全双工通道,计划扩展到 32 条 |
| 通道速率 | 面向 400Gb/s-per-lane 演进路径 |
| 带宽密度 | 相对传统 200Gb/s-per-lane 可插拔光模块 4 倍 |
| 功耗效率 | 约 1.3 倍 提升 |
| 生态 | 与 TE Connectivity、Amphenol 合作 cages、连接器与模块,计划以社区多源方式推进 |
4 倍带宽密度意味着同样数量的交换机端口能接更多计算资源,而不必增加网络层级——层级增加会同时抬升延迟、功耗和运维复杂度,这正是超大规模 AI 网络最敏感的三项指标。
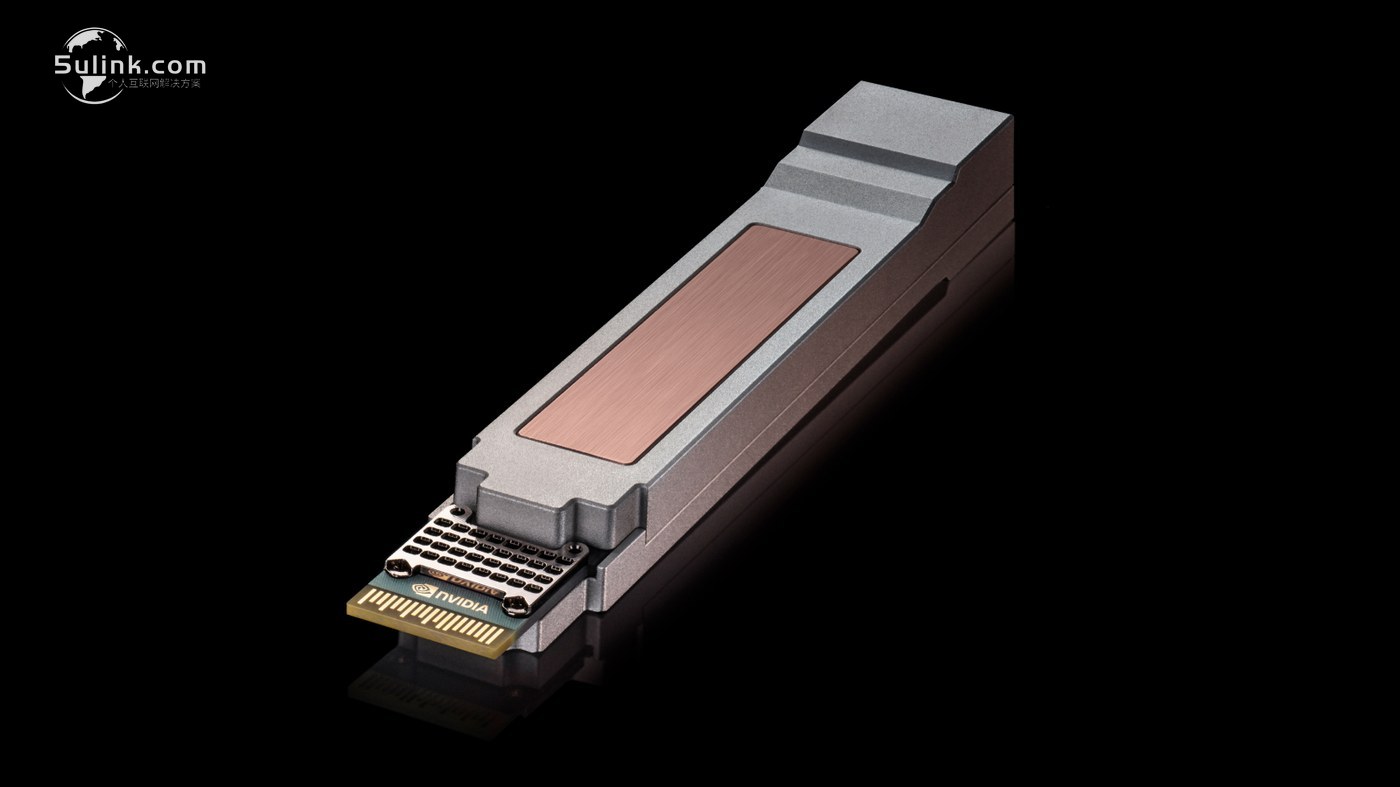
图:USFP 模块形态与同尺寸 OSFP 的对照(图片来源:NVIDIA 官方博客)
五、还有哪些值得记一笔
- – Meta 宣布采纳 NVIDIA Spectrum-6 102.4Tb/s 以太网交换机,其自研交换机 N-IceCube 插入 Meta 自有的 100T 液冷机架 IcePack,运行 Facebook 开源网络操作系统 FBOSS。属于网络侧的配套进展,本文不展开网络选型。
- – Google Falcon Transport 将支持后续的 ConnectX-10 SuperNIC 与 BlueField DPU,把”可靠以太网传输”能力带到 Google 数据中心的传输层。
- – Vera CPU 机架设计规范把 MGX 开放架构延伸到加速计算之外,面向 agentic AI 时代的工具调用、编排与沙箱化执行。
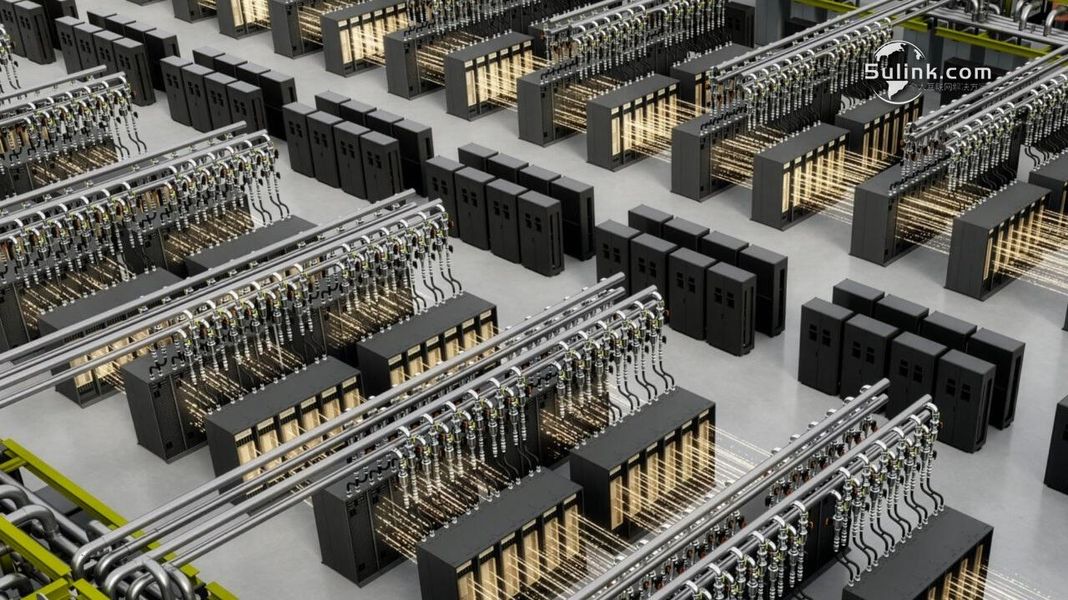
图:面向 AI 工厂的加速计算架构(图片来源:NVIDIA 官方博客)
小夏点评
一、这一届 OCP 最重要的信号不是任何一款硬件,而是”标准由谁来写”变了。 过去 GPU 集群的机架规范基本由 NVIDIA 一家输出,生态被动接受;这次 Open Data Center Specification v0.7 由 NVIDIA 与 AMD、Google、Meta 共同发布,电网韧性规范由 Google、Meta、Microsoft 与 NVIDIA 联署——买家第一次作为标准的共同作者出现。这对国内团队的实际含义是:如果你在建自己的智算中心,”直接照抄某一家参考设计”的窗口正在关闭,而”按开放规范采购、再按自己的加速卡填”正在成为更现实的路子。评估供应商时,除了看单机性能,也要问一句”你的机架设计进 OCP 了吗”——这是判断它会不会在两三年后成为孤岛的低成本信号。
二、250kW 与 2 秒这两个数字是一对,必须一起读。 单看 250kW,它是液冷和配电的工程挑战;单看”2 秒恢复到接近满载”,它是软件与调度能力;但两者叠加,含义就变了:AI 工厂的连续性目标已经从”设备不坏”转移到”不掉电”。传统 UPS 撑住的是断电窗口,AI 工厂需要的是在电网扰动时把负载平滑接住甚至主动参与调节。对国内运维的现实提示是——如果你的机房还在用”UPS 撑 10 分钟、柴发兜底”的思路去规划 AI 集群,它在电气设计这一环就已经落后了:储能容量、母线设计、变配电冗余、以及与电网侧的联动控制策略,都需要按新目标重算一遍。这也是为什么 Visionbay 那种”集群级电力中心”的设计思路值得盯——高压直流 + 集中式 AC-DC 转换,本质是在为未来的负载密度重新组织供电拓扑。
三、给国内 IT 运维和开发者的启示:USFP 和 DSX OS 这两条线,比任何单点硬件都更值得提前布子。 具体建议三条。其一,把光模块形态当成需要提前 6–12 个月规划的采购变量——USFP 的 16 通道起步、32 通道路线图,以及它与现有 OSFP “尺寸大致相同”的承诺,意味着如果你的机房预留了笼子(cage)空间规格偏紧或偏松,现在就该确认下一代模块的机械与散热边界,而不是等到装机时才发现装不下;网络侧的提前量通常比服务器更长。其二,把机架当成可编程对象来设计运维流程——DSX OS 的 Rack Management Service 把机架当一等公民管理,这个信号值得国内数据中心团队记住:未来机架级固件管理、批量配置与”配置即代码”会越来越自然,而不是靠一堆脚本和 Excel 台账。其三,DSX 的四个开源组件值得技术团队现在就评估——Config Manager 和 Cluster Readiness Engine 解决的是”集群起来之后才发现配置漂移或硬件有问题”这类最贵的故障,代码已开源在 DSX AI Factory 的 GitHub 仓库,先在测试集群跑通,能把故障发现点从”训练开始后”提前到”训练开始前”。最后提醒一句:开放标准的价值在于按规范采购,而不是按某家的路线图采购——OCP 规范的落地速度取决于有多少厂商真的按它交付,看到第二、第三个厂商跟进时再重仓,通常比首发就押注更稳妥。
参考链接
- – 主源:NVIDIA Blog《Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide》(2026-10-12,OCP Global Summit)https://blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories
- – 官方项目:NVIDIA DSX AI Factory 开源组件(GitHub)https://github.com/NVIDIA/dsx-ai-factory
- – 官方规范:OCP Open Data Center Specification v0.7 与 OCP Grid Resilience Specification https://www.opencompute.org/
- – 补充报道:Shattered《OCP 2026: Nvidia, AMD, Intel Show 3 Open AI Rack Designs》(三家开放机架方案与 MGX 1.2 要点对照)https://shattered.io/ocp-2026-nvidia-amd-intel-open-ai-racks-2026
- – 补充报道:MarketScale《AI Data Center Liquid Cooling: 4000-Watt Chips and the Road to 1MW Racks》(机架功率密度演进与 OCP 2026 现场技术观察)https://www.marketscale.com/industries/software-and-technology/ai-data-center-liquid-cooling-4000-watt-chips