零物理GPU跑通8项测试:Kamaji + HAMi多租户GPU切分实验室
CNCF 博客一篇实验室文章解决的是 GPU 团队的经典两难:给每个团队独立集群,就要养一套控制面;全员挤共享集群,隔离又太弱。而且 Kubernetes 按整卡发 GPU——用 4GB 的 Pod 照样占走整张 80GB 卡。作者的解法是两个开源项目组队:Kamaji 把租户控制面做成管理集群里的 Pod,HAMi 让 Pod 按 MB 显存 + 百分比算力申请 GPU 切片。整套环境在一台没有物理 GPU 的机器上跑通,8 项测试全部通过。
架构:一套控制面机器,两个租户
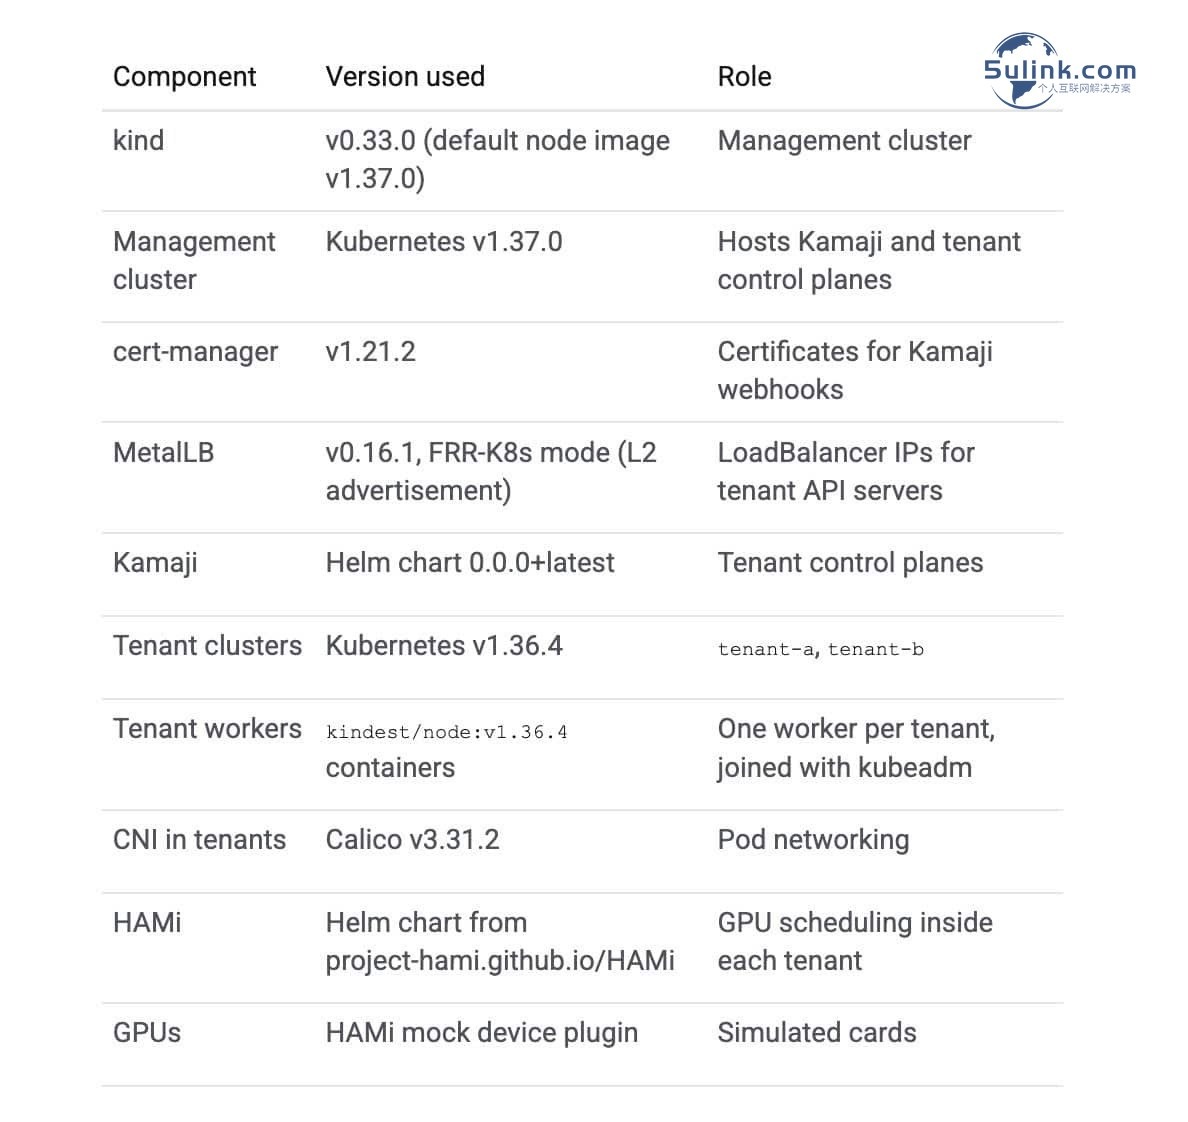
一个 kind 集群跑 Kamaji 和两个租户的控制面;每个租户的 worker 是独立容器,通过 kind 网络加入并运行 HAMi。租户之间不共享节点、不共享 API Server,唯一的共享件是管理集群和 kamaji-etcd 存储,数据按租户隔离。
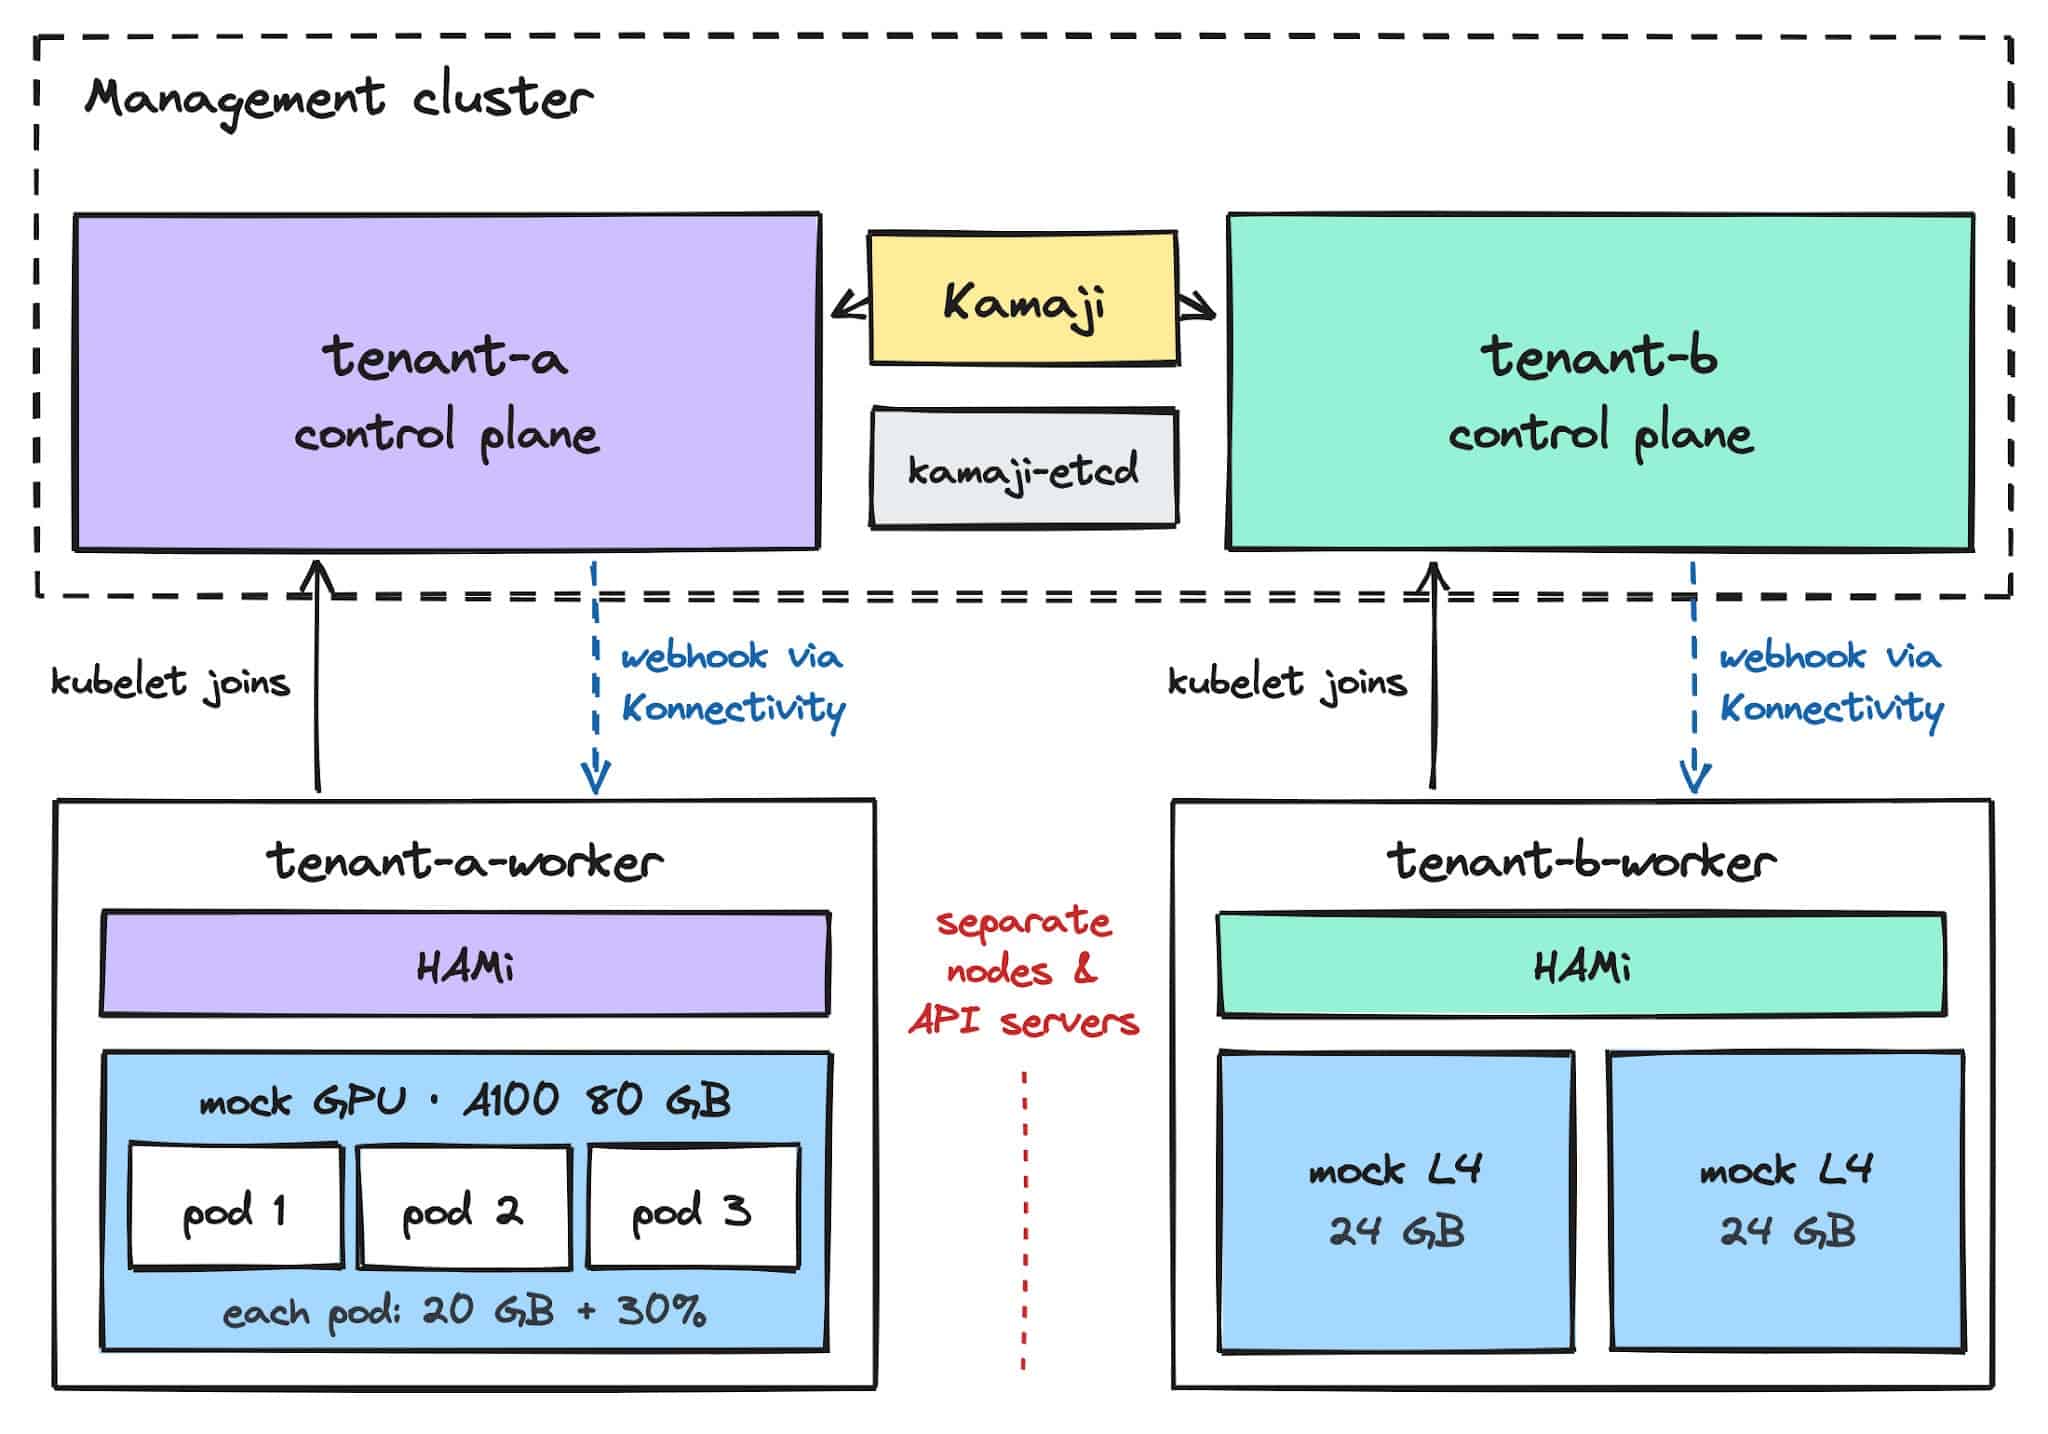
模拟卡:租户 A 一张 NVIDIA A100 80GB,租户 B 两张 NVIDIA L4 24GB,全靠 HAMi 的 mock device plugin 在节点注解里描述假卡、注册显存和算力容量,webhook、调度器、配额逻辑与真实节点完全一致地运行。
关键集成点:一个走隧道的admission调用
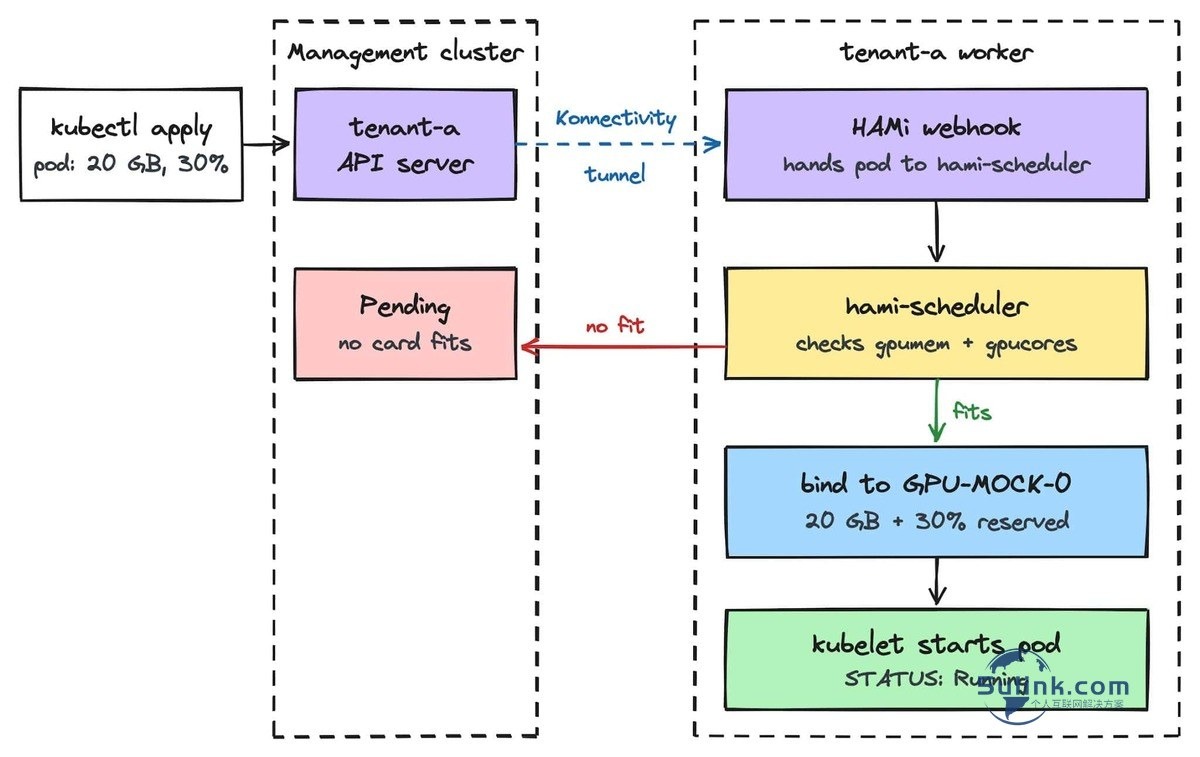
全文最值钱的是这条路径:租户 API Server 住在管理集群,HAMi 的 webhook 在租户 worker 上——每个 GPU Pod 的创建都要经过 Kamaji 的 Konnectivity 隧道回穿到租户侧,这条跳不通,GPU Pod 就会退回默认调度器、HAMi 根本看不见它们。作者明说:证明这条路走得通就是本实验室的主要目标,结果第一次就通了。
实验室成绩
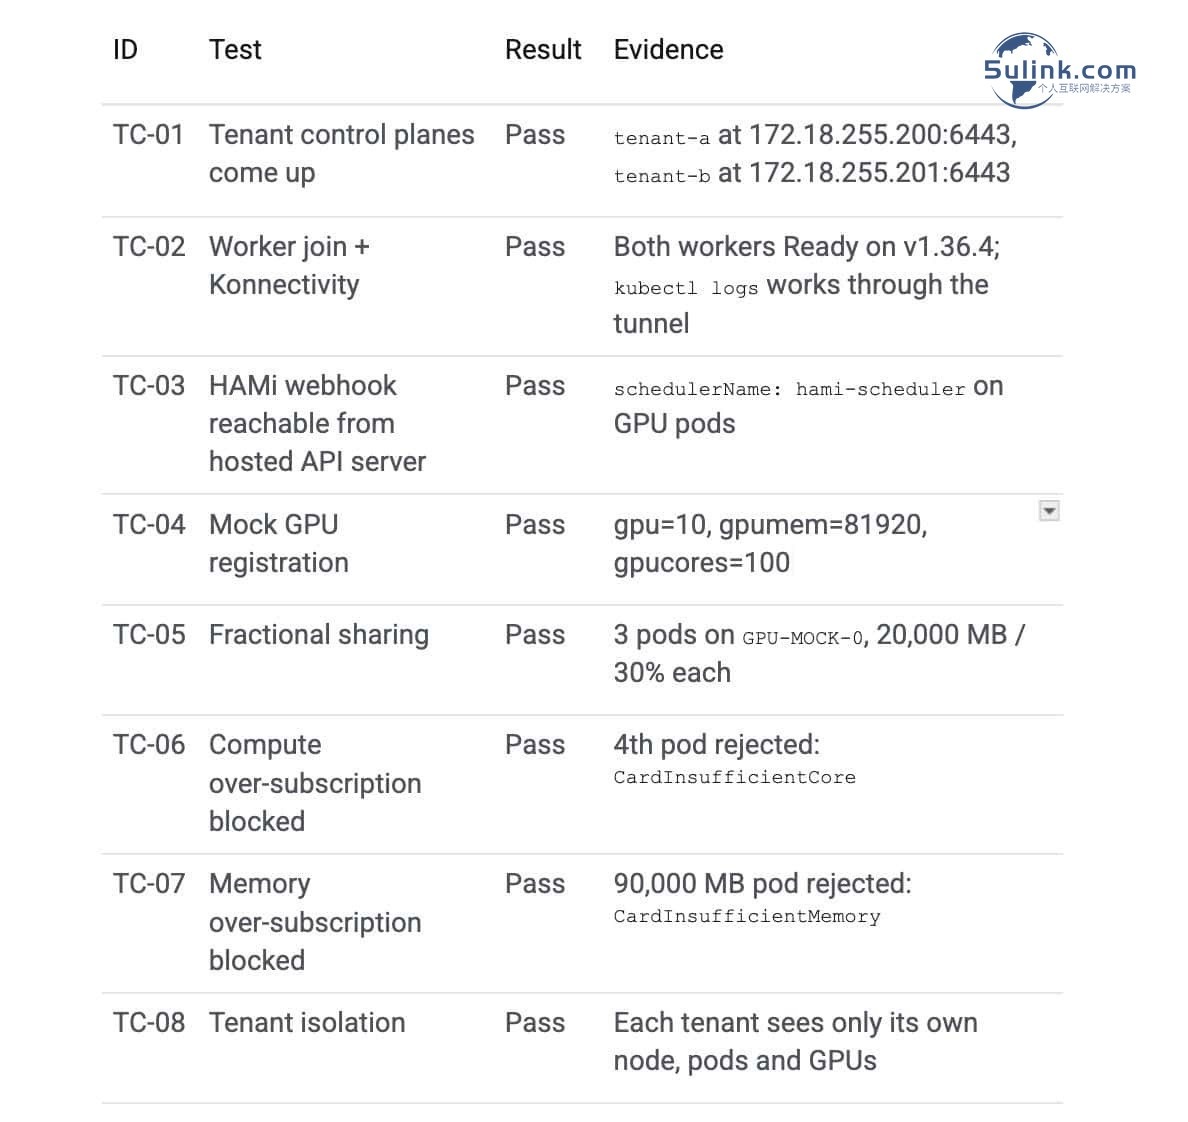
单机 Docker 容器方案,4 核、8GB 空闲内存、20GB 磁盘就够。测试结果:
| 测试 | 结果 |
|---|---|
| 总测试数 | **8/8 通过** |
| 三 Pod 共卡(TC-03/05) | 每 Pod 申请 20,000MB + 30% 算力,三个全部调度到同一张卡 |
| 超卖拦截 | 申请 90,000MB 的 Pod Pending:超过 81,920MB 卡容量 |
| 算力超限 | 第四个 30% 算力 Pod Pending:累计需要 120/100 核 |
| 租户互不可见(TC-08) | 两边 API 各自只返回自己的 worker、Pod 和 GPU 容量 |
踩过的坑与”不证明什么”
两个坑各有一行修法:kind 网络 IPv6 会让 MetalLB 地址池读到拼接地址,直接用 docker network inspect 拿 IPv4 网段写死;mock plugin 不会在绑定后释放节点锁(真实 plugin 会),锁要 5 分钟才过期——lab 里手动代劳 device plugin 的活即可,作者标注这是 mock 特有效应,不是 Kamaji 或 HAMi 的 bug。
作者同样划清了边界,这个实验室证明的是接线和调度决策,不证明运行时隔离:mock 卡没有东西可执行(HAMi-core 要靠 NVIDIA 驱动在容器内强制限额);没跑 CUDA 负载,无性能数据,噪邻未测;worker 走 kind 容器属实验路径,Kamaji 官方支持的是真实机器上的 kubeadm 或 Cluster API。
小夏点评
参考来源
https://www.cncf.io/blog/2026-10-23/multi-tenant-gpu-kubernetes-on-simulated-hardware-with-kamaji-and-hami