NVIDIA Snapshot 开源:GPU 推理副本秒级拉起,恢复 3.6–42.7 秒,最快 36 倍
> 原文:NVIDIA Developer Blog《Start and Restore GPU Workloads in Seconds with NVIDIA Snapshot》,2026-11-10 发布。本文据原文改写,数据以原文为准。
大模型推理集群里,最贵的往往不是 GPU,而是等它热起来的那几分钟。权重加载、显存分配、torch.compile 编译、CUDA Graph 捕获——一台 B200 从进程拉起到能接流量,冷启动动辄十几分钟。
NVIDIA 11 月 10 日开源的 Snapshot(DSX AI Factory Platform 新组件)想解决的正是这段空窗:把一个已经完全初始化的 GPU 工作负载(CPU 内存 + GPU 显存一起)打成可移植产物,在同型号同驱动的任何节点上直接”复活”,跳过权重加载、编译和图捕获。
一句话结论:8 到 36 倍的启动加速
官方在 NVIDIA B200 + VAST(NFS)存储、驱动 615.71.09 的同一套软硬件栈上,用 vLLM 0.31.0、SGLang 0.5.21、TensorRT-LLM 1.3.0 三个引擎、从 6 亿参数到 8 卡 MoE 的完整配置矩阵测了一遍:
| 指标 | 数值 |
|---|---|
| 恢复耗时(全部配置) | 3.6 – 42.7 秒 |
| 相对冷启动加速比 | 8× – 36× |
| 冷启动耗时(8 卡 MoE) | 6 – 19 分钟 |
| 检查点体积(8 卡 MoE) | 约 600 GB – 1 TB |
| 检查点创建耗时 | 15 秒 – 5.5 分钟(一次性成本) |
| 八卡 MoE 的 GPU 状态恢复 | 18 – 29 秒 |
| 八卡 MoE 的 CRIU CPU 进程恢复 | 4.2 – 10.8 秒 |
关键的一点:checkpoint 时间 + restore 时间,在所有测试配置下都短于一次冷启动。也就是说第一次恢复就把本钱赚回来了。
设计合作伙伴的实测更直观:Crusoe 把 GLM-5.3 的 Pod 就绪时间从约 8 分钟压到 31 秒(HGX B300);Saturn Cloud 把 vLLM 启动从 2–8.5 分钟压到 6–34 秒(HGX B300)。
冷启动那几分钟,钱花在哪了
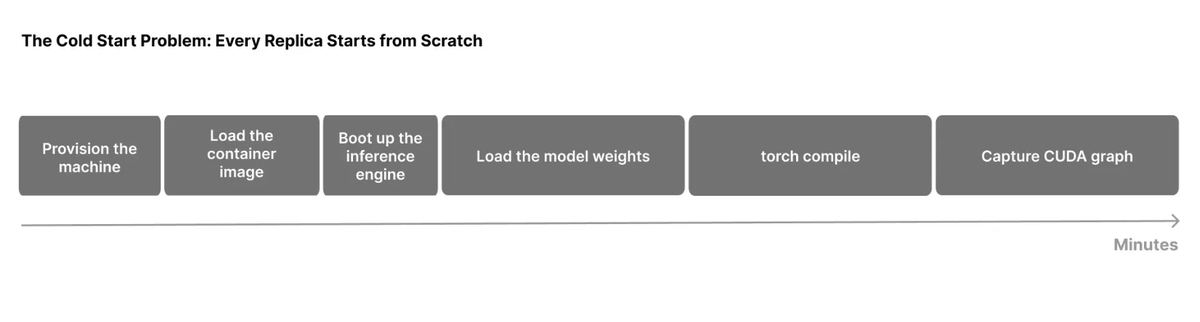
图:副本冷启动的六个阶段——准备机器、拉容器镜像、启动推理引擎、加载模型权重、torch.compile 编译、CUDA Graph 捕获(图表源:NVIDIA Developer Blog)
原文把冷启动拆成四段(Table 2),下表节选其中四个八卡 TEP8 配置,这份拆解比结论更有用:
| 模型 / 引擎 / 并行 | Startup | Model load | Initialization | 编译+调优+图捕获 | 合计 |
|---|---|---|---|---|---|
| GLM-5.3-NVFP4 / vLLM / TEP8 | 65.5s | 65.9s | 48.9s | 213.4s | 393.7s |
| GLM-5.3-NVFP4 / SGLang / TEP8 | 60.8s | 74.0s | 2.7s | 289.3s | 426.7s |
| DeepSeek-V4.1-Flash / vLLM / TEP8 | 64.0s | 184.9s | 77.3s | 784.5s | 1110.7s |
| DeepSeek-V4-Pro-NVFP4 / SGLang / TEP8 | 58.8s | 87.7s | 42.6s | 432.5s | 621.6s |
编译 + 自动调优 + CUDA Graph 捕获常常是最大的一块——DeepSeek-V4.1-Flash 在 vLLM 上光这一步就吃掉 784.5 秒,占总时间七成。Snapshot 恢复时这一整段直接被跳过,所以收益最大的恰恰是那些又大又难编译的模型。
恢复本身也不是黑盒,原文同样拆成四段(Table 3):Agent setup(定位产物、准备 Pod 和 GPU)、CRIU restore(把进程镜像从存储读回主机内存)、CUDA restore(GPU 状态回拷显存)、wake/remap(适配新节点并唤醒引擎)。八卡 MoE 场景下 GPU 状态回拷要 18–29 秒,CRIU 只要 4.2–10.8 秒——瓶颈已经从 CPU 侧转移到显存搬运侧。
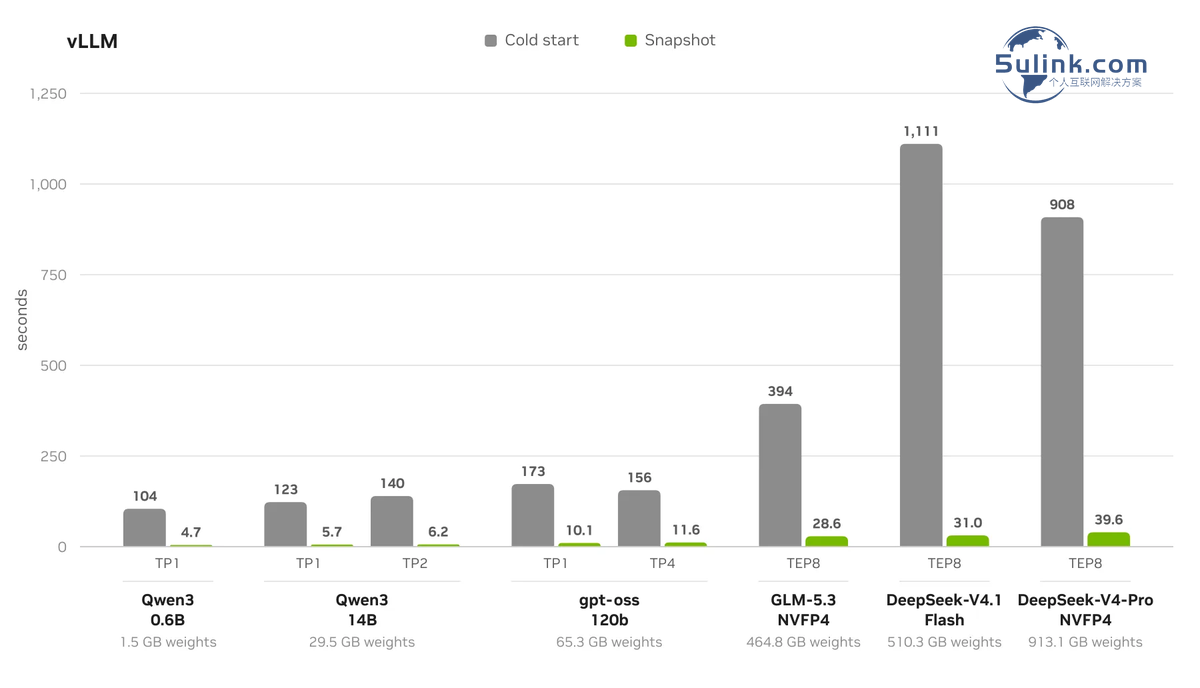
图:vLLM 上各模型与并行配置的冷启动 vs Snapshot 恢复对比(图表源:NVIDIA Developer Blog)
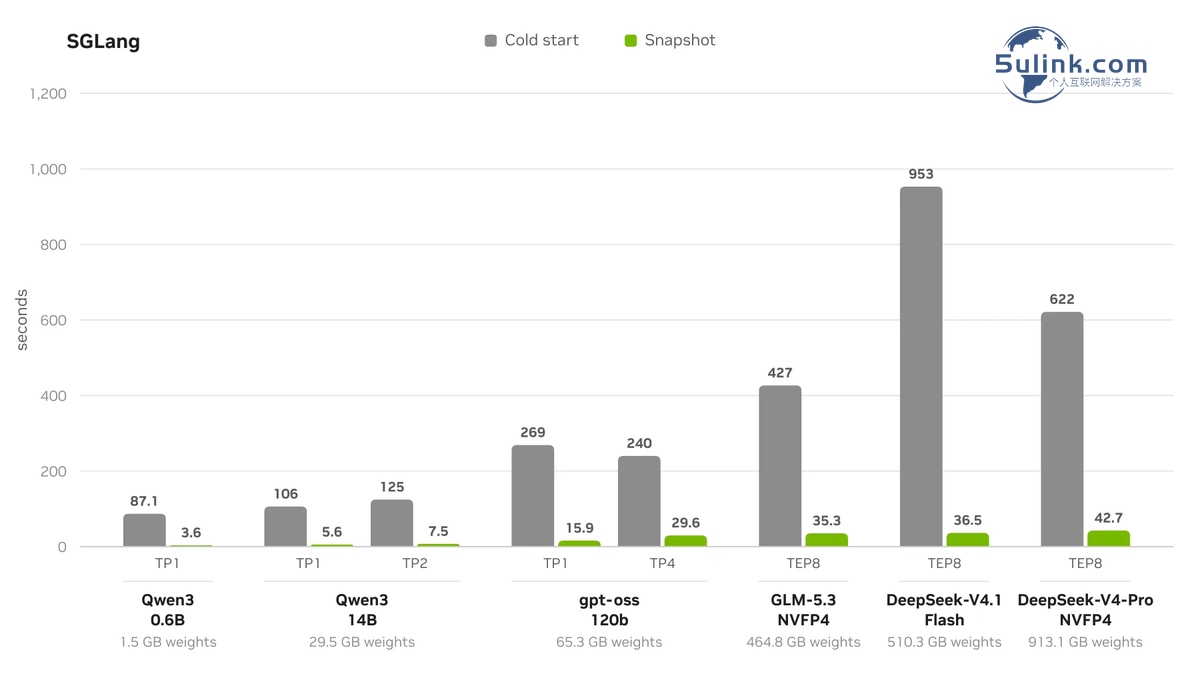
图:SGLang 上各模型与并行配置的冷启动 vs Snapshot 恢复对比(图表源:NVIDIA Developer Blog)
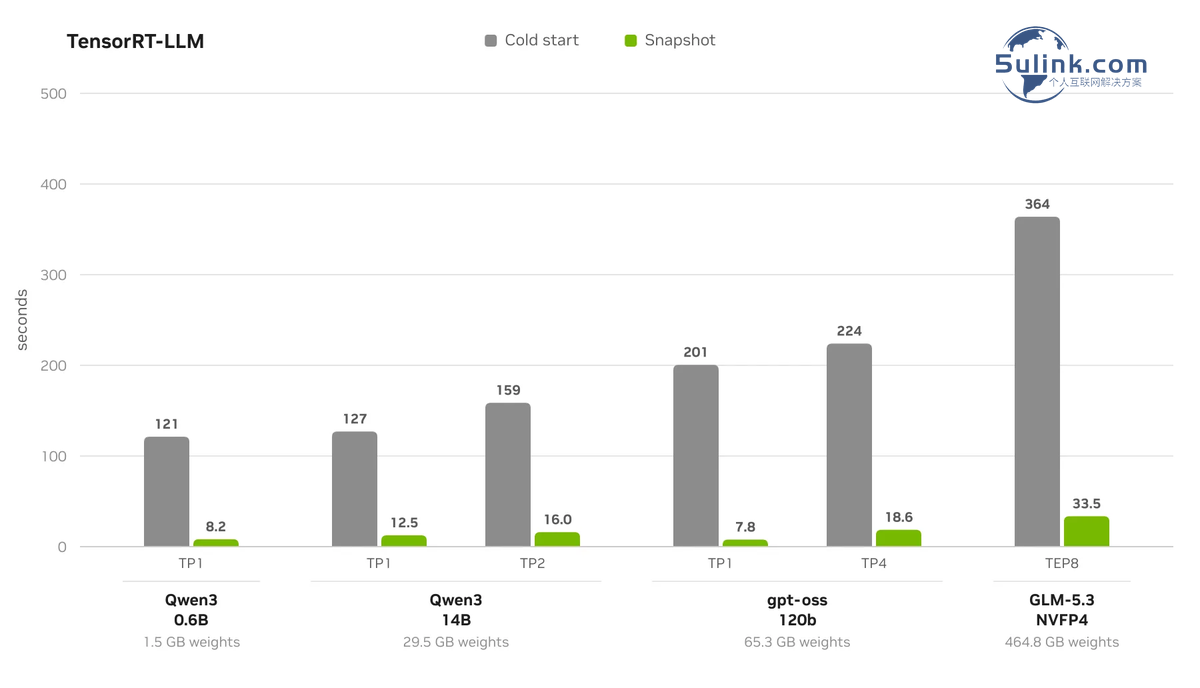
图:TensorRT-LLM 上各模型与并行配置的冷启动 vs Snapshot 恢复对比(图表源:NVIDIA Developer Blog)
用起来有多复杂:两个 CR,一个注解
Snapshot 的操作模型相当克制,全程走 Kubernetes 自定义资源:
- – Checkpoint:为一个已在运行的 Pod 建一个
PodSnapshot;或者建SnapshotJob,让 Pod 从模板起来后就绪即打快照。 - – Restore:给新 Pod 加一个注解
nvidia.com/restore-from,指名从哪个PodSnapshot恢复。 - – 工作负载侧只需一次”握手”:快照前暂停、恢复后继续。
官方仓库直接给了 vLLM、SGLang、TensorRT-LLM 的现成示例。
两个工程细节值得注意:
- 1. KV cache 在打快照前会被释放,因此它不在产物里——快照更小、恢复更快,但首次请求仍要重建 KV。
- 2. 多卡是一个整体产物。跨多 GPU 的 TP、DP、EP、DCP 并行配置可以按 rank 打成单个快照,大 MoE 模型不用拆成多个碎片。
还有一个容易被忽略的边界:测量口径不包含拉镜像和容器运行时准备。所以”3.6 秒恢复”指的是从 Snapshot 被调用恢复、到引擎重新可服务的时间,不是 Pod Ready——真做容量规划时要把镜像分发的时间另算。
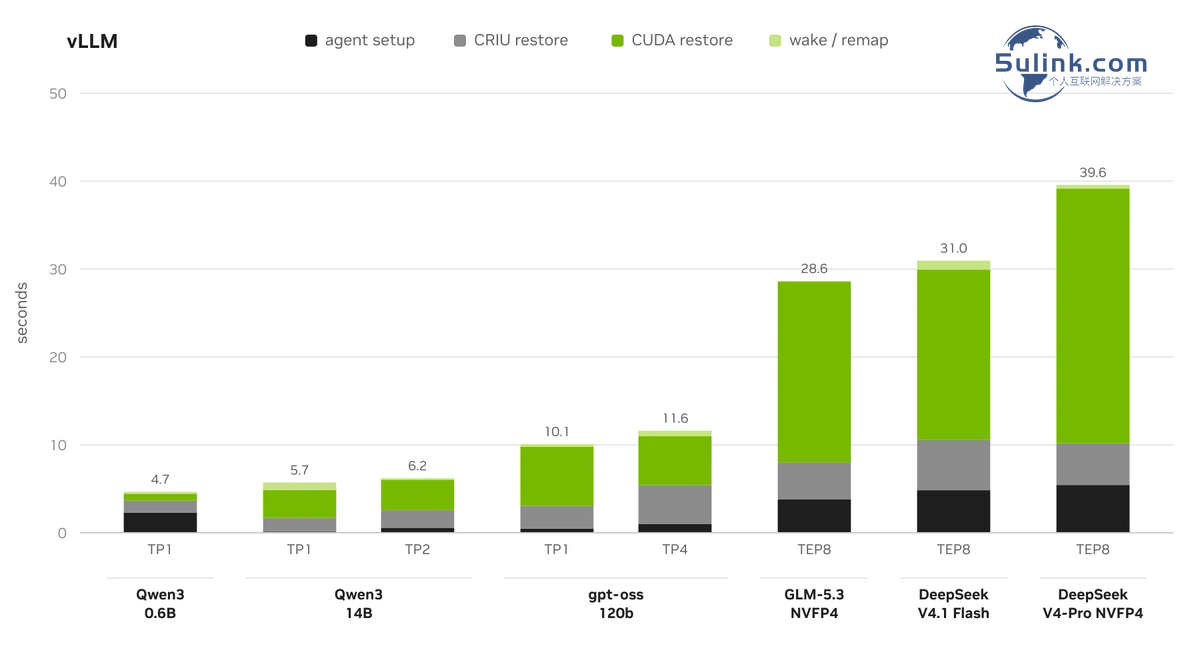
图:vLLM 恢复耗时的四阶段拆分,柱顶数字为该配置总恢复时间(图表源:NVIDIA Developer Blog)
小夏点评
- 1. 这份数据的价值在于它拆了冷启动的四段,而不是只报一个总数。真正被跳过的是”编译 + 自动调优 + 图捕获”这一段,占大模型冷启动的 50%–70%。任何做推理成本核算的人,都该拿这张表重新算一遍自己的启动预算。
- 2. 恢复 3.6 秒 vs 42.7 秒的跨度,比均值更有信息量。小模型(Qwen3-0.6B)恢复到个位数秒,大 MoE 卡在 GPU 状态回拷的 18–29 秒——瓶颈清晰地从 CPU 进程侧转移到了显存带宽侧,这也是为什么下一步要盯 GPU-to-GPU 内存搬运。
- 3. 国内运维团队落地时的三个坎:一是检查点产物 600GB–1TB 的存储与分发成本(走 NFS 的话,恢复速度直接被存储后端拖住,CRIU 恢复速度”主要由存储后端决定”);二是快 8–36 倍的启动加速会把流量洪峰瞬间放大,HPA 阈值要跟着重调;三是 KV cache 不在快照里,突发流量下第一批请求仍然要吃满延迟。建议先在单一推理服务上做灰度,把镜像分发时间也纳进端到端测量,再谈规模化。
原文链接
- – NVIDIA Developer Blog:Start and Restore GPU Workloads in Seconds with NVIDIA Snapshot(2026-11-10)
Start and Restore GPU Workloads in Seconds with NVIDIA Snapshot
- – NVIDIA Snapshot 开源仓库(安装与使用指南)
https://github.com/ai-dynamo/snapshot
- – NVIDIA Dynamo 用户指南(用 Snapshot 恢复 worker)
https://docs.nvidia.com/dynamo/latest/kubernetes/model-deployment/model-loading/dynamo-snapshot-experimental