分片 Postgres 怎么实现序列:Neki 查询计划器拆解
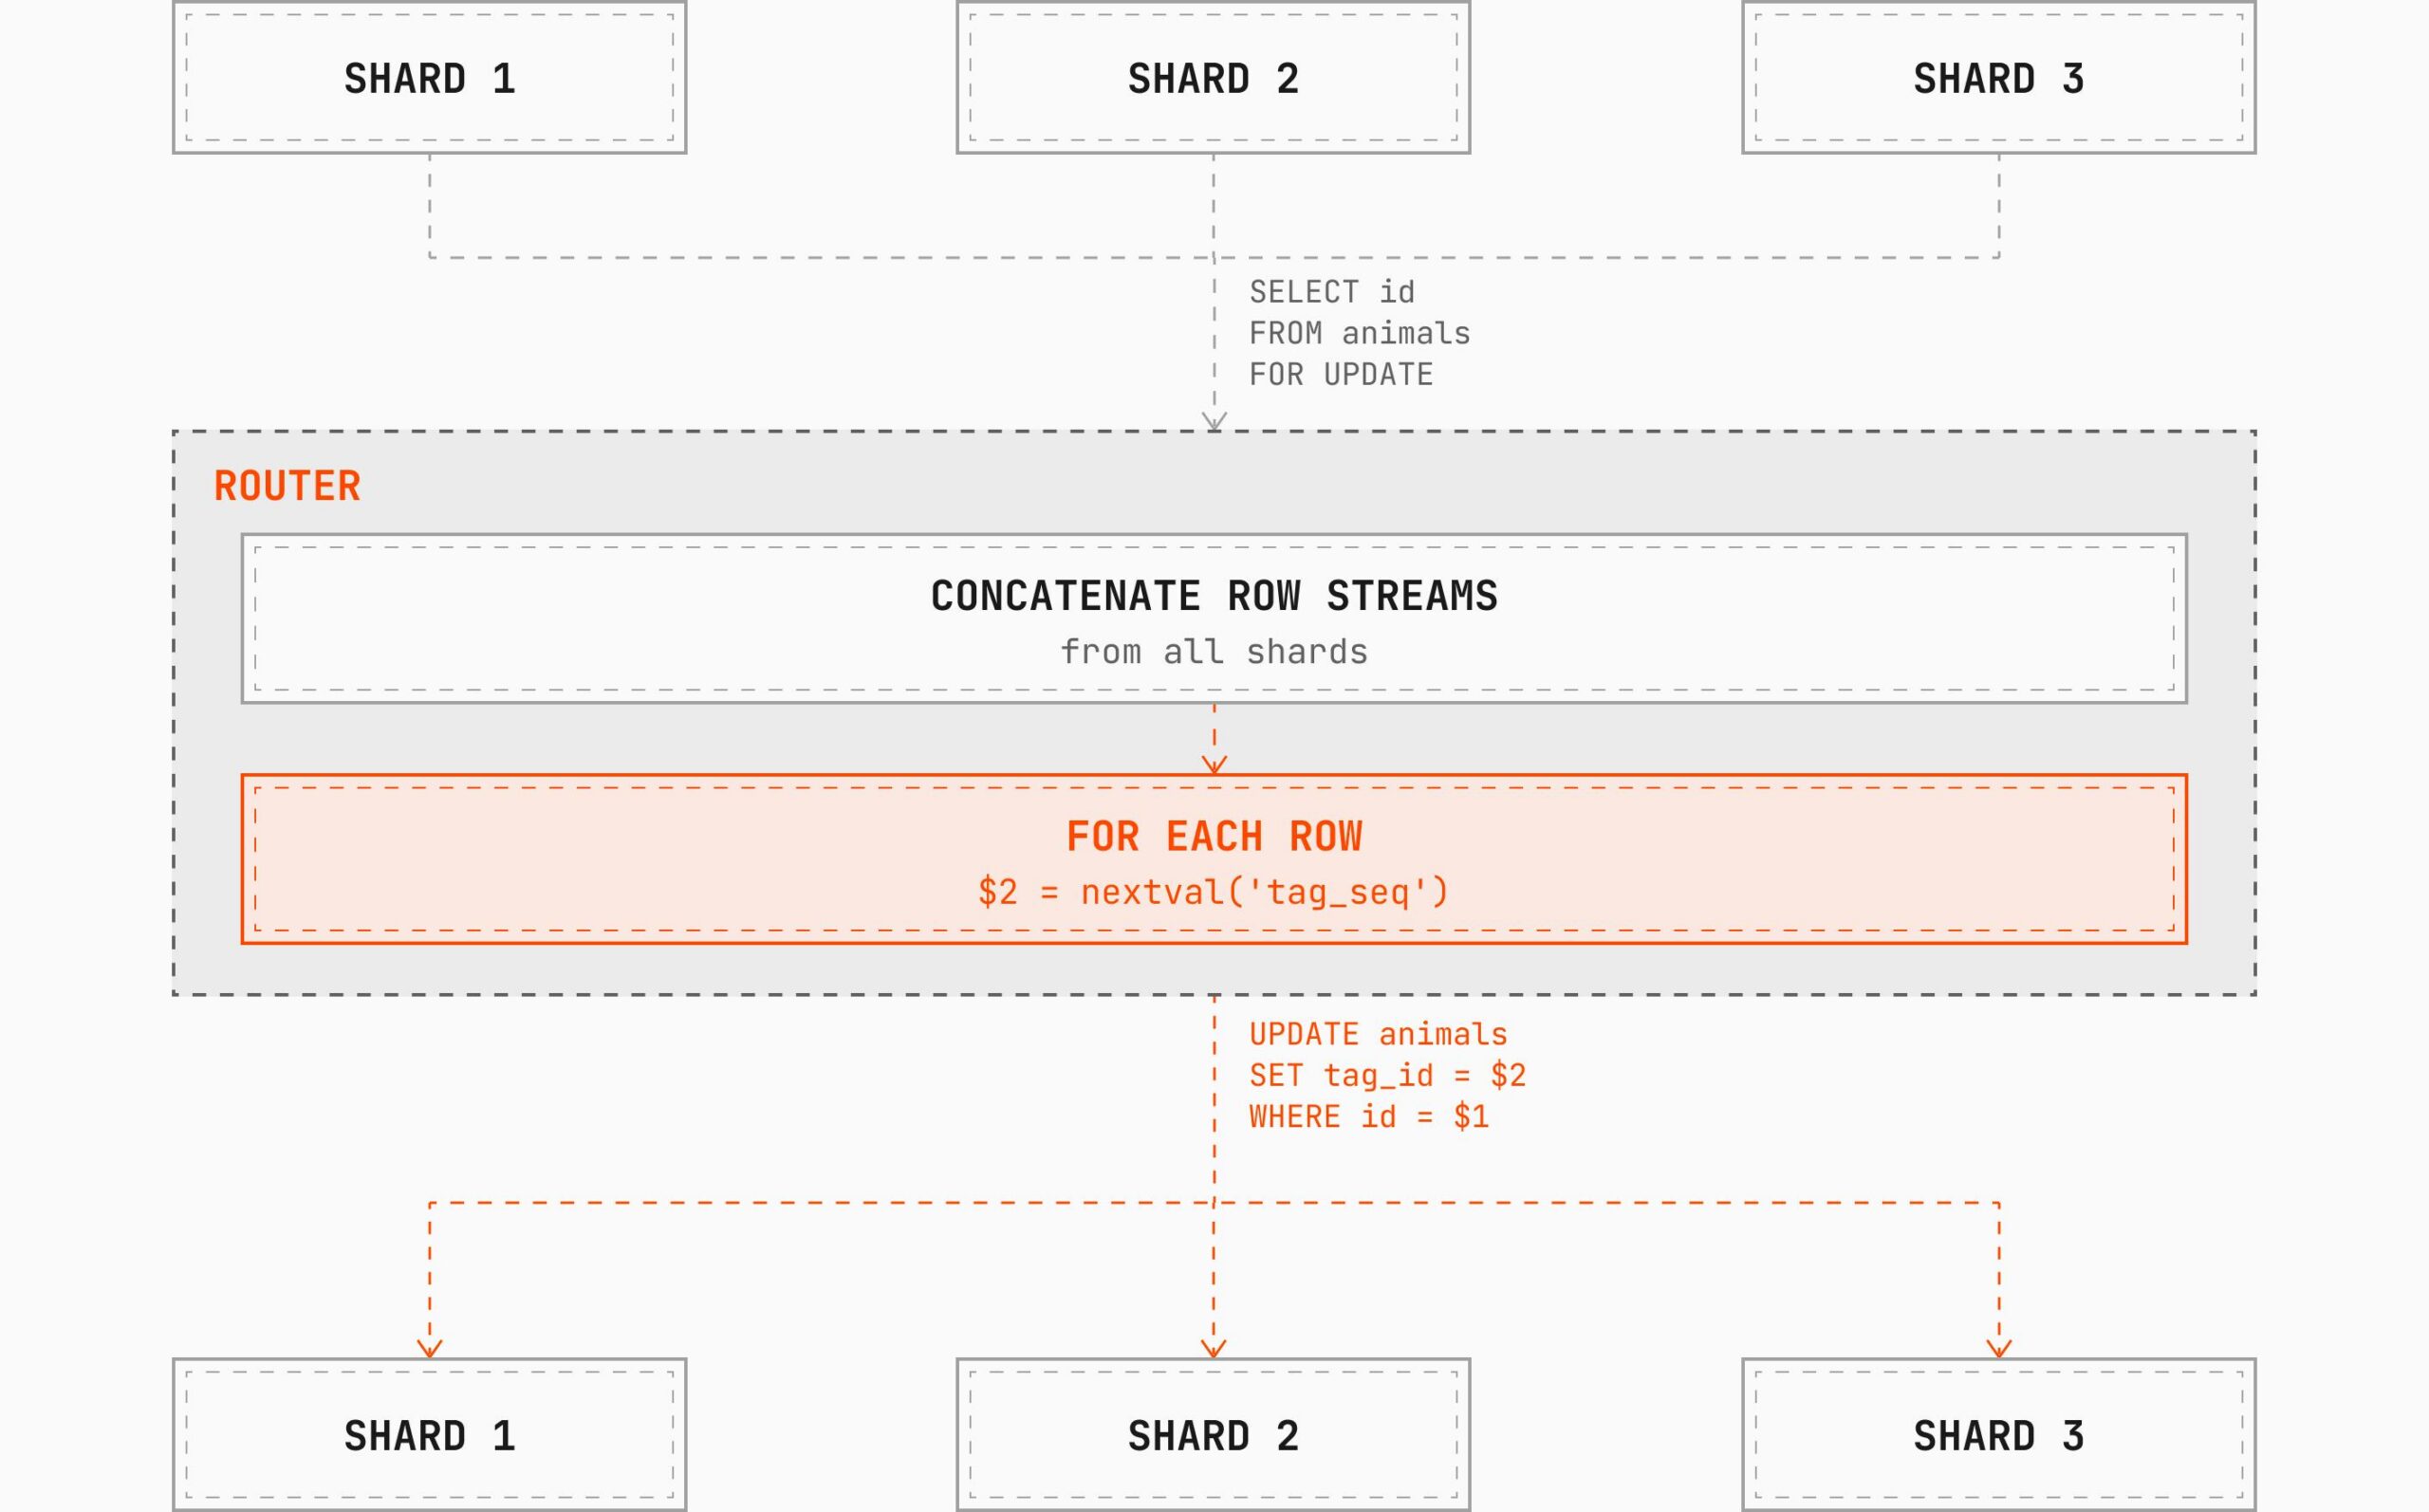
▲ Neki 数据流总览(图源:PlanetScale 官方博客):路由节点在分片返回的行流上「插入」volatile 表达式的求值,再写回正确的分片。
为什么序列是「病态」问题
Postgres 里序列(sequence)无处不在——计数器、IDENTITY 列、surrogate key 都靠它。它的核心承诺是不重号(可 caveat:reset/cycle 例外),并且不保证连续:事务回滚时已消耗的号不回收。
对单机 PG 这不是问题;但对分片系统 Neki 就是:每个分片都有自己的 pg_class 序列表,且都从空序列开始,任何查询都可能引用任何序列——必须由中心统一发号,否则两个分片会给出同一个值。这就是作者 Mats Rydberg(做了十几年查询语言与查询计划器,过去 8 个月专职 Neki 计划器+运行时)所说的「pathological case」:不能把活儿整体下放给某个分片,必须假设中心控制。
三类表达式:计划器的世界观
PG 在语义分析阶段给每个表达式标三类之一,Neki 的分布式计划器照单全收:
| 类别 | 承诺 | 例子 | Neki 策略 |
|---|---|---|---|
| immutable | 同输入永远同输出,跨语句不变 | 算术、lower() |
**能下推就下推到分片** |
| stable | 同一语句内同值 | now()、to_char() |
看依赖:**必须保证各分片依赖一致** |
| volatile | **每次调用都可能是新值** | nextval() |
**永远在路由求值** |
stable 类的细节最能体现分布式陷阱:to_char() 的输出依赖 lc_time GUC,用户在会话里 SET lc_time 一下,同一个表达式在不同分片就可能返回 Wednesday 和 Onsdag 两个结果——所以计划器必须把 SET 语句随查询一起推给用到它的分片。now() 则因为各分片时钟漂移、请求到达时刻不同,被直接划入「router-only」:只在路由算一次,追加到每行。
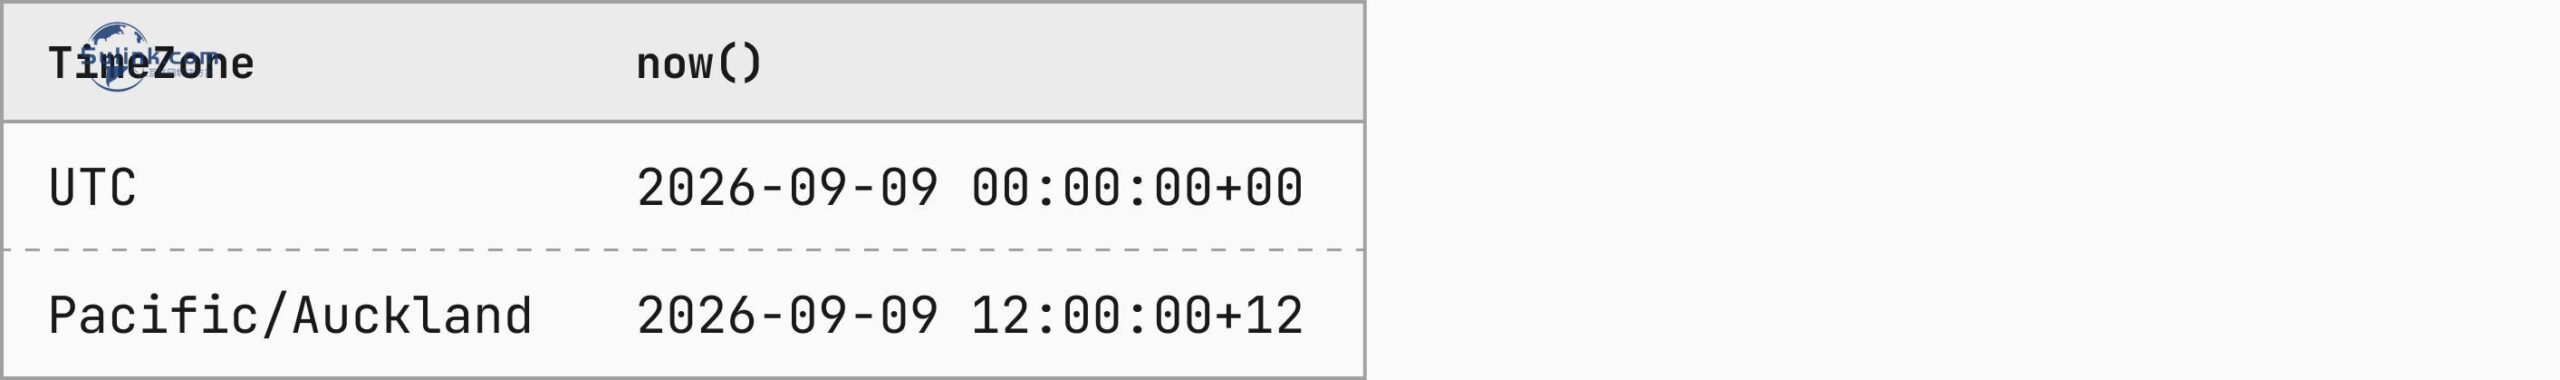
▲ 原文 Table 1(图源:PlanetScale 官方博客):同为 stable,now() 的输出随会话时区 GUC 变化——这就是 stable 依赖必须跨分片一致的原因。
作者顺带点名了优化难点:路由和分片谁更缺资源?传输求值结果划算还是传输原始列划算?嵌套表达式要不要拆开两边各算一段?Neki 的答案是一条启发式:能下推就下推。
「每行一次」:基数才是核心
volatile 函数的铁律是每行必须独立求值一次——同一个输入表达式在两行里也允许给两个不同值(PG 手册明说优化器不得假设它「可合并」)。于是问题变成:计划器怎么知道有多少行?
答案在「表表达式(table expression)」:FROM ... JOIN ... WHERE ... GROUP BY ... 构成一个逻辑单元,SELECT 输出列表里的 volatile 表达式必须按这个单元的行基数逐行求值。举个 Neki 原文的例子——animals JOIN feedings ON id 后加 WHERE feedings.time='morning':JOIN 出 3 行,过滤剩 1 行,所以 nextval('tag_seq') 只消耗 1 个号;把 WHERE 去掉,基数变 3,就消耗 3 个号。
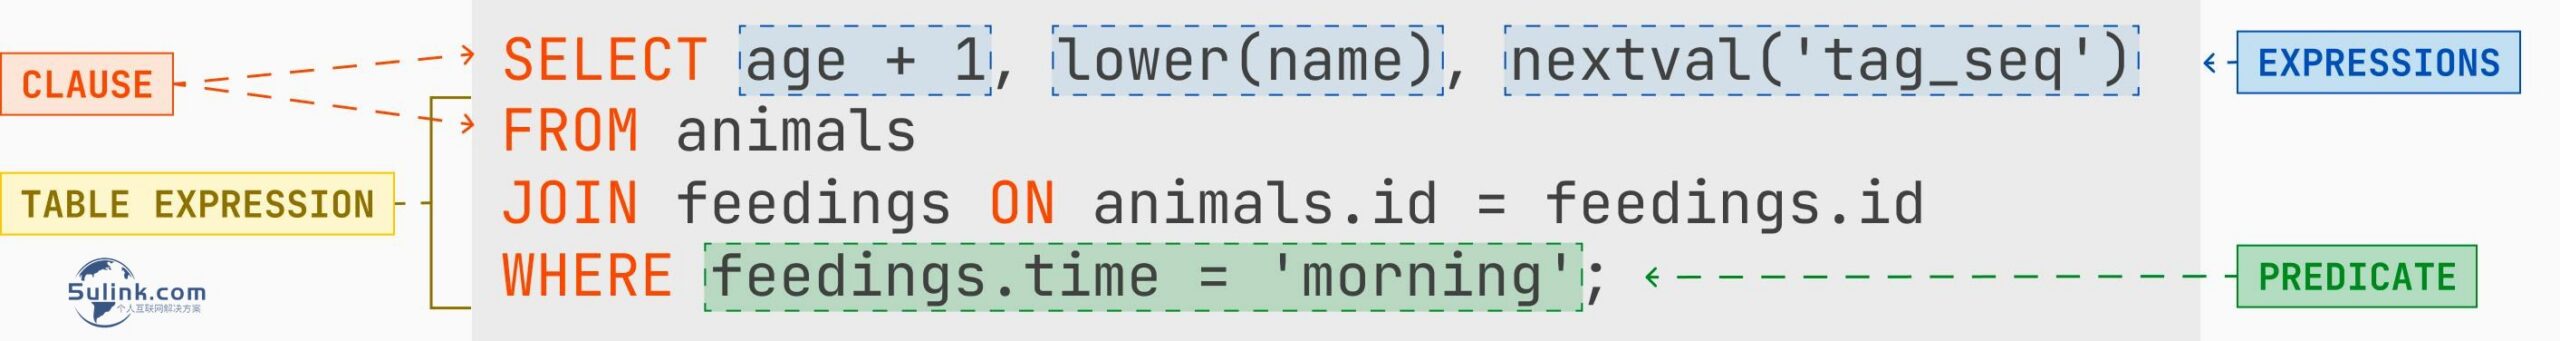
▲ 原文 Query 4(图源:PlanetScale 官方博客):JOIN+WHERE 构成一个完整的表表达式,「每行一次」以它的基数为准。
这里有个精妙的陷阱:无 WHERE 时,JOIN 会把 animals 同一行乘出两份,age、name 在两行里值相同——对 immutable 表达式可以合并只算一次,但对 nextval() 不许合并:两行就是两个号。顺序也影响正确性之外的东西:JOIN 和 WHERE 谁先做属于 join ordering 优化(先过滤后 JOIN 通常更便宜),优化器怎么排不保证结果顺序确定——只要谓词里有 volatile 表达式,「哪行拿到哪个号」就不保证,但保证正确。
分布式执行:路由只做「必须它做的」
Neki 计划器的通用模型三句话:
id 分片)时,JOIN 可以每个分片本地完成,路由只拼接各分片的子结果。到了 UPDATE 场景(原文 Query 7:UPDATE animals SET tag_id = nextval('tag_seq')),难点叠加:animals 的行数未知、行在各分片分布未知,序列又必须中心发号——发给分片的查询长什么样?
Neki 当前答案是两段式:
第一步(原文 Query 8):Neki 先在路由建立表表达式——只需主键+分片索引列(这里 id 一列身兼二职),FOR UPDATE 锁行等号。
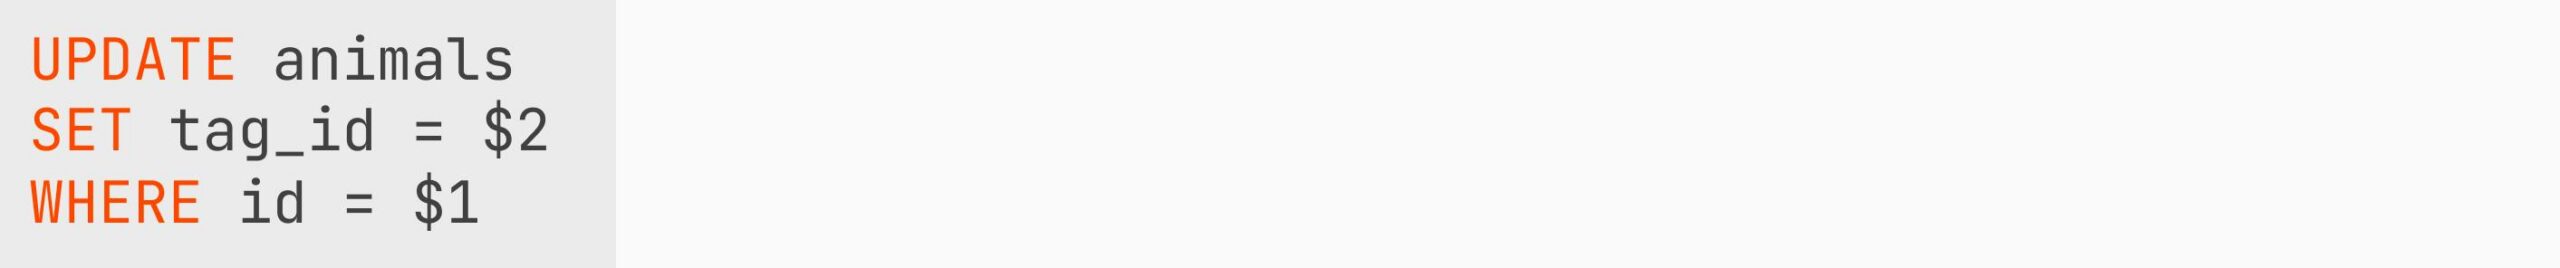
▲ 第二步(原文 Query 9,图源:PlanetScale 官方博客):路由每收到一行,就现场评一次 nextval(),把全局唯一号带进参数化 UPDATE,按 id 路由到正确分片的正确行。
三道练习题的答案(原文思路)
now() 在路由算一次、追加到所有行;nextval() 在路由逐行取号。nextval() 换成 now() 怎么办? 简单得多:stable 不依赖基数,路由算一次即可——作者留给读者的正是这个对比。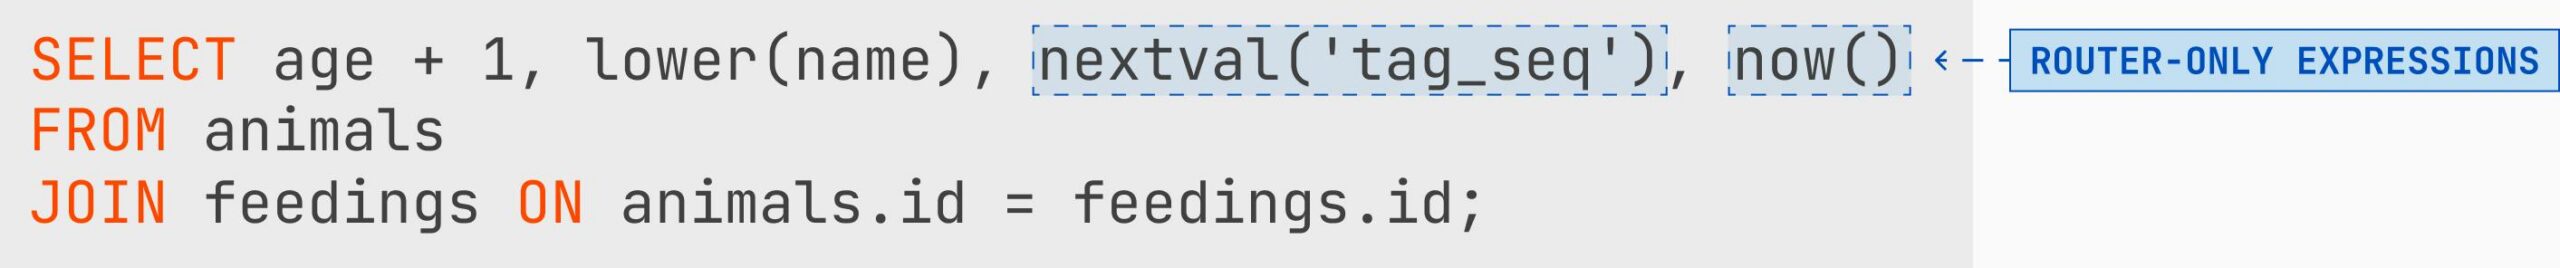
▲ 原文 Query 6(图源:PlanetScale 官方博客):immutable 两列下推分片,now() 与 nextval() 留在路由层——第一问答案的全图。
小夏点评
to_char() 会返回两种语言。