PyTorch 接上 FlyDSL:AMD GPU 迎来新内核后端,vLLM 端到端最高快 3 倍
MI350 系列 GPU 上的 PyTorch 用户现在可以直接受益于 AMD 的内核语言 FlyDSL:稠密与分组矩阵乘(GEMM)、融合多头注意力、MXFP8/MXFP4 缩放 GEMM、RMSNorm、TopK 这些算子都能走到 FlyDSL 内核,应用代码一行不用改。它不是一条孤立的内核库路线——GEMM 通过 torch.compile 作为候选后端参与自动调优,RMSNorm 和 TopK 在 eager 模式下满足条件就自动派发,注意力则藏在 AOTriton(PyTorch ROCm 版 SDPA 背后的库)里由调优数据库自动选。官方口径的账面成绩:vLLM 整请求加速 BF16 最高 1.13x、MXFP8 最高 2.04x、MXFP4 最高 3.01x。
三条路:编译 GEMM、eager 派发、AOTriton 注意力
FlyDSL 的定位是把 Triton 交给编译器的事情——线程、wave、指令怎么映射——交还给写内核的人:用布局代数显式划分块/wave/线程/寄存器的数据归属,自选 tiled-copy 和 MFMA 指令原子,自己定义共享内存 swizzle 和同步边界。这些控制直接体现在内核里:GEMM 的 HTI 流水和分阶段 LDS、MXFP 的”操作数与比例因子生命周期配对”、Grouped GEMM 的常驻专家调度——都用 Python 写,经 MLIR 下降,但硬件映射保持显式。
接入 PyTorch 后是三条执行路径:
torch.compile:Inductor 把 FlyDSL 加入 GEMM 候选名单,和 ATen、Triton 一起现场跑分,每个形状选实测最快的那个;F.scaled_dot_product_attention 调 AOTriton,由它在 FlyDSL、Triton、AITER ASM 内核间按工作负载选。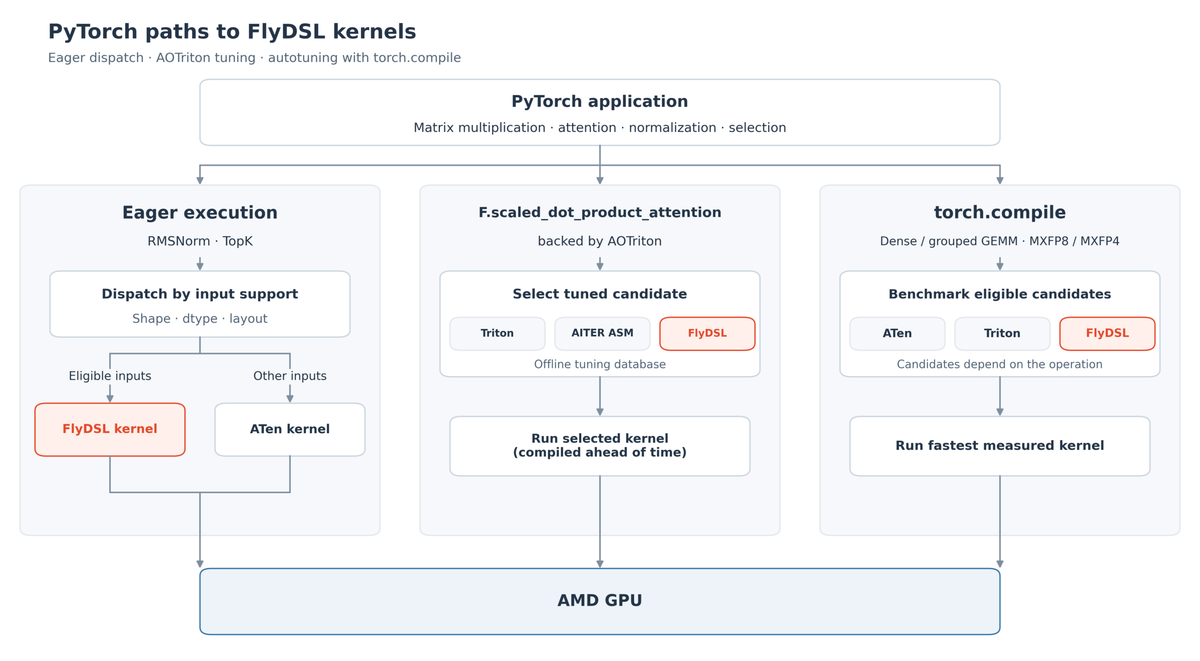
支持边界:MI350 系列,按算子划线
官方给出的支持矩阵(以下数据均在 MI355X / gfx950 上实测,稳态内核执行,不含编译和首次自动调优):
| 算子 | 触发方式 | API | 输入类型 | 布局/形状要求 |
|---|---|---|---|---|
| 稠密 GEMM | 编译 | torch.mm |
FP16、BF16 | 静态 2D,支持 NN/NT/TN/TT 四布局 |
| MXFP 缩放 GEMM | 编译 | F.scaled_mm |
MXFP8、MXFP4 | A 行主序、B 列主序;K 需为 128 的倍数 |
| Grouped GEMM | 编译 | F.grouped_mm |
FP16、BF16 | A 可按组不等长,空组跳过 |
| RMSNorm | eager | F.rms_norm |
FP16/BF16/FP32 | 前向支持,反向仍走原实现 |
| TopK | eager | torch.topk |
FP32 | 取最大、排序 |
| 注意力(经 AOTriton) | eager/编译 | F.scaled_dot_product_attention |
FP16、BF16 | head 维 32–512,前向反向都支持 |
MXFP 的量化输入按每 32 个值一个 E8M0 比例因子(BlockWise1x32),FP32 累加,输出 FP16/BF16。注意力头部维度到 512 时因 LDS 容量(约 272KB 需求对 160KB 上限)改用专门的宽头内核。不支持的组合全部回落原实现——这是整个集成的底线设计。
内核级成绩:收益最大的是低比特量化
官方按算子套件给出几何平均加速(对 ATen,注明处除外):
| 套件 | 对基线 | 几何平均 | 备注 |
|---|---|---|---|
| BF16 稠密 GEMM(15 形状) | 对每个形状上更快的 ATen/Triton | **1.10x** | 后一次全布局回归为 1.12x;小中形状最受益(64×4096×4096 达 1.33x) |
| MXFP8 缩放 GEMM(17 形状) | ATen | **1.58x** | 单点区间 1.31x–2.23x |
| MXFP4 缩放 GEMM(17 形状) | ATen | **1.68x** | 单点区间 1.31x–2.96x,峰值在 32×14336×4096 |
| Grouped GEMM(24 案例) | Triton | **1.20x** | 对 ATen 为 **1.95x**;不均衡专家(含空组)5 例全部 FlyDSL 赢 |
| RMSNorm(22 案例) | ATen | **1.17x–3.66x** | 对齐维度约 1.2x–1.5x;3.66x 出现在 4097 这类”差一个元素”的维度 |
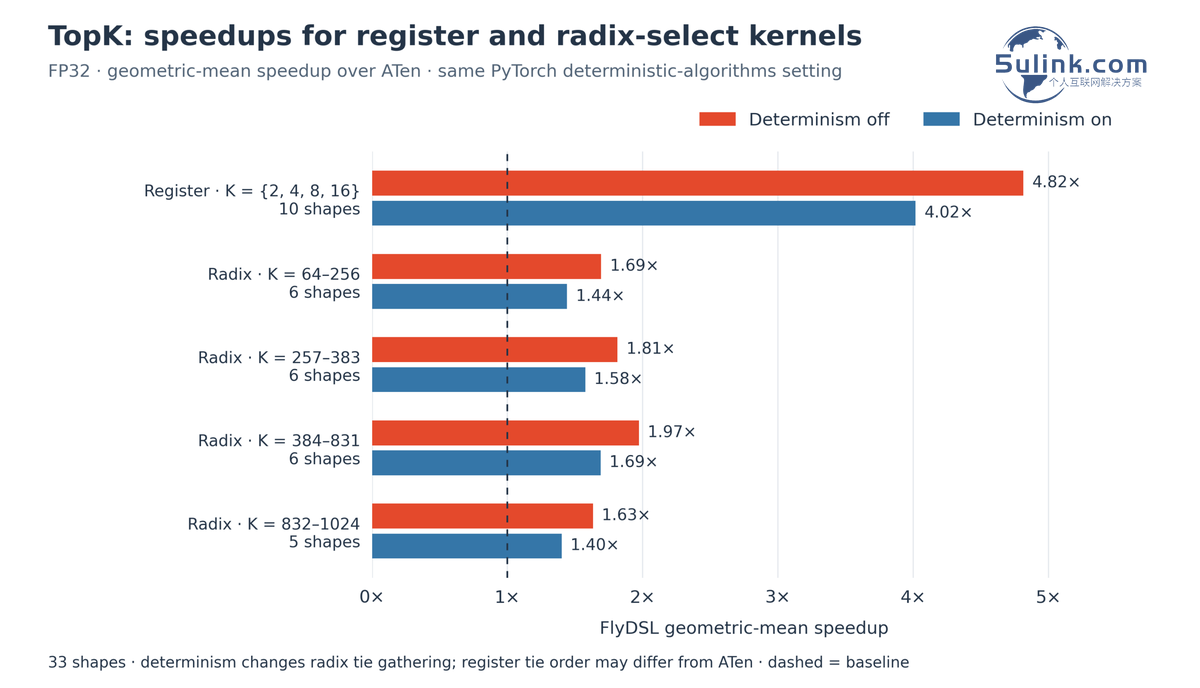
| TopK 小 K(10 案例) | ATen(关确定性算法) | **4.82x** | 开确定性仍有 4.02x;大 K 区间 1.40x–1.97x |
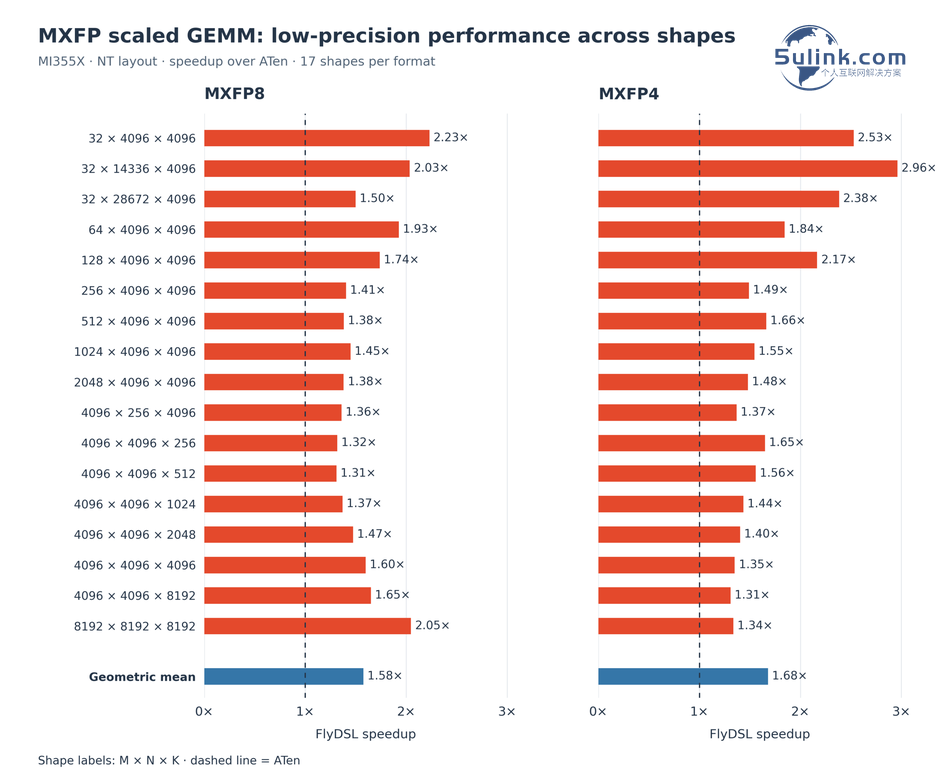
工程上值得注意的是形状敏感性:RMSNorm 的 3.66x 是特定 FP16 非对齐形状的数字,对齐维度收益只有 1.2x–1.5x;TopK 的小 K 寄存器路径平均最快,大 K 的 radix 路径部分案例接近打平。多后端共存的价值就在这里——最大的两个方形输出 GEMM 反而是 ATen 更快,PyTorch 会自动选。
vLLM 端到端:量化越激进,收益越大
单卡 MI355X(TP=1)上跑 vllm bench serve,三个模型:Llama-3.1-8B-Instruct、Qwen3-32B、Llama-3.3-70B-Instruct;每请求 256 token 输入、固定 512 token 输出,并发 8–256。基线与对照唯一差别是 Inductor 的 GEMM 候选名单。
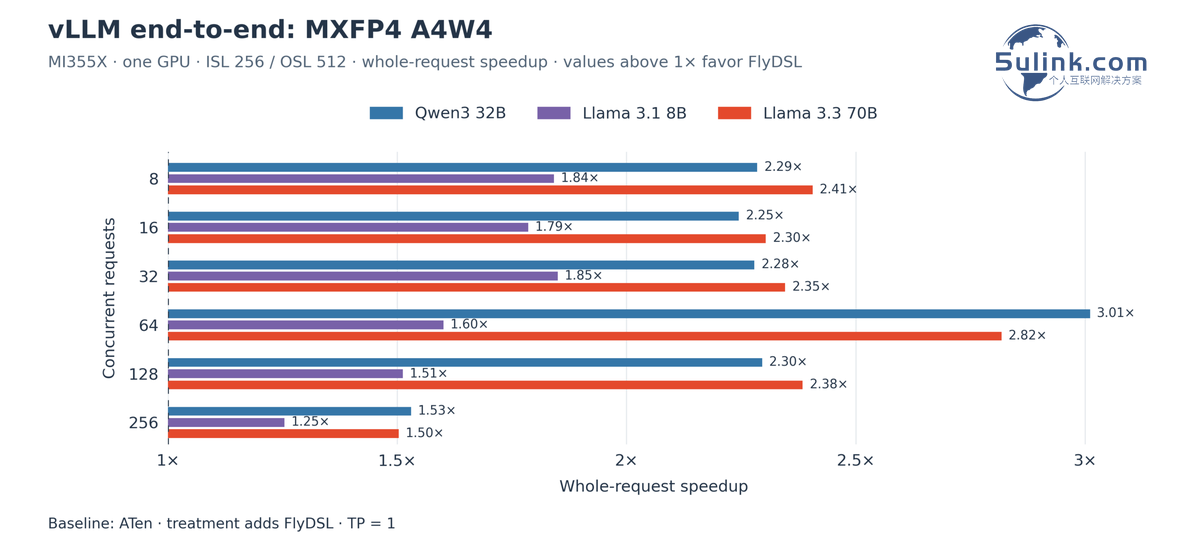
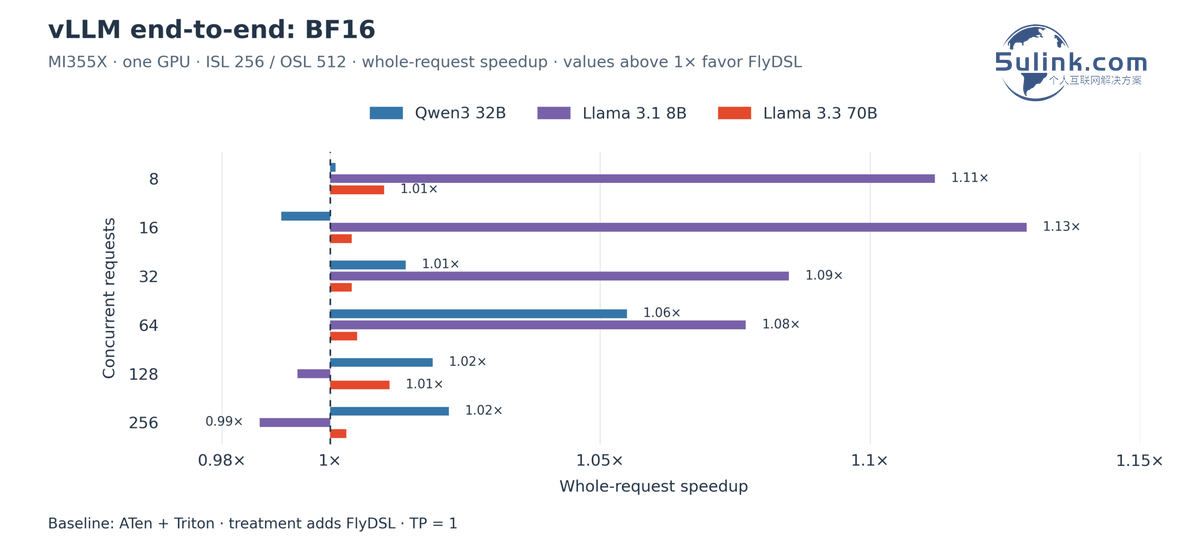
一个诚实的注意事项:BF16 是至少两轮 ABBA 交替的中位数,而 MXFP8/MXFP4 每格只有一次测量,小差异别当结论用。
怎么用起来
需要带集成(含 MXFP 缩放 GEMM)的 ROCm PyTorch nightly + 可选运行时 pip install "flydsl>=0.3.0,<0.4"。GEMM 把 max_autotune_gemm_backends 加上 FLYDSL 并开自动调优即可,首次调用含编译调优、之后复用赢家;RMSNorm/TopK 装好自动派发,pn.flydsl.disabled() 可以现场和 ATen 对拍;注意力什么都不用装,AOTriton 0.14.2b 起自带内核。官方下一步计划里包括 MI450 系列、MXFP8 Grouped GEMM、FlexAttention 后端和 GEMM 尾部融合。
小夏点评
1. 这篇公告的分量在"接入方式"而不是跑分数字。 1.1x–1.7x 的内核级加速单看不惊艳,但它选择的路径是进 torch.compile 的自动调优候选、进 eager 派发、进 AOTriton 的选择器——全程 API 不变、不支持就回落。第三方内核库最常见的死法是要用户改代码;FlyDSL 从第一天就把"零侵入"做成了产品形态,这才是 AMD 软件栈过去一年真正在补课的地方。
2. 曲线形状比峰值更有信息量。 收益随量化位数下降而放大(BF16 1.13x → MXFP8 2.04x → MXFP4 3.01x),说明新内核的优势主要在低比特数据通路上;而形状敏感性(非对齐维度收益最高、最大 GEMM 反而输给 ATen)提醒你:选型看的是你自己的工作负载分布,官方几何平均只是入场参考。
3. 对中国 IT 运维和开发者的启示。 国内 MI300/MI350 集群不少,但日常真正跑的就是标准 PyTorch/vLLM,没人手写内核——这类"API 不动、后端可插拔"的更新,意味着不用迁移代码就能把新硬件红利吃进去,升级 ROCm nightly + 打开 autotune 候选就是全部动作。同时它给出了异构算力的现实估值方式:低比特量化路径收益翻倍、BF16 只有一成——如果你的业务本来就要上 MXFP4 量化,AMD 卡的相对性价比要重算一遍。