2026 AI Agent 分层架构全景:六层两轨,和「不到某个东西坏掉就别加层」这条铁律
由
内推小冬
·
开场:demo 好做,上线难做
作者给的典型剧情:后端团队要做个内部 agent,需求很简单——回答客服问题、查客户记录、调一个退款接口,就这些。三周后系统长成了:图运行时、持久化状态、重试、自定义工具封装、向量库、记忆、追踪、仪表盘,外加几个没人用的”面向未来”抽象。
agent 本身还是那个简单的 agent,围着它的架构不是。 作者的判断是:多数团队失败不是因为选错模型或框架,而是在说不出”这层解决什么具体问题”之前就把层加上了。
地图:六层 + 两轨
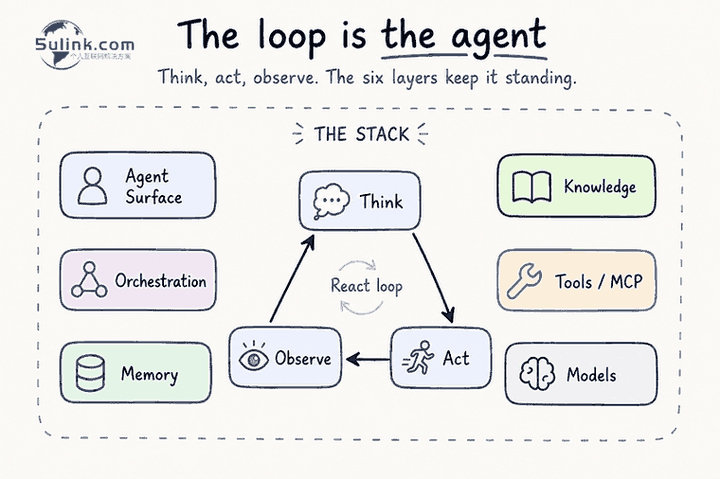
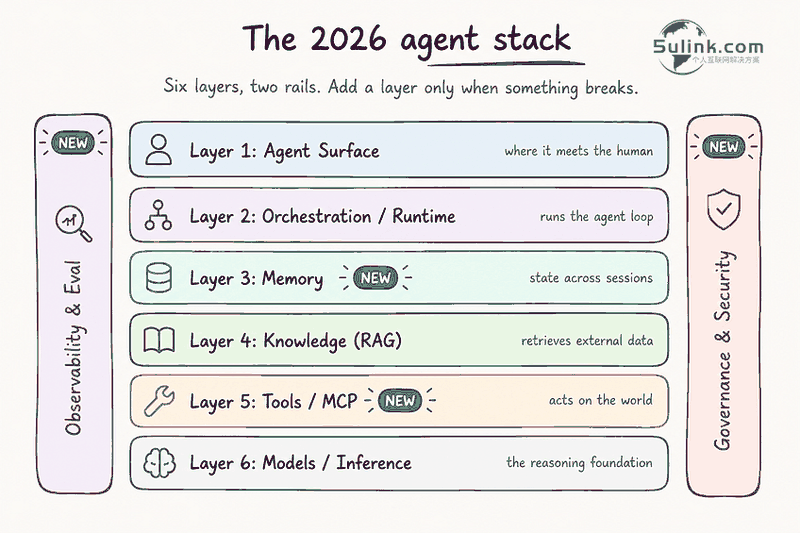
核心循环只有一个:思考 → 行动 → 观察(ReAct)。其余全是让这个循环在真实流量下不塌的基础设施。作者特别划清一条线:agent 栈不等于 LLM 栈——LLM 栈管推理(GPU、批处理、量化、跨服务器路由,如 vLLM/Ollama),agent 栈管模型与真实世界之间的那一段。
| 层 |
职责 |
代表 |
| L1 Agent Surface |
agent 在人面前长什么样 |
Chat、Cursor/Claude Code/Codex/Devin Desktop、Slack bot、审批队列 |
| L2 Orchestration / Runtime |
用代码把 agent 循环跑起来 |
**LangGraph**、各家 SDK、AutoGen、CrewAI、Agno、DSPy |
| L3 Memory |
跨步骤/跨会话/跨用户的自身状态 |
Mem0、Letta、Zep、LangGraph checkpointing |
| L4 Knowledge(RAG) |
训练里没有、需要现查的外部信息 |
pgvector、Pinecone、Qdrant、Chroma;BM25 / 稠密 / RRF 混合 |
| L5 Tools / MCP |
agent 如何对外界动手 |
**MCP**、各家 function calling、Browser Use/Playwright、E2B/Modal |
| L6 Models / Inference |
推理发生的地基 |
GPT-5.5、Claude 4.x、Gemini 3.x;开源权重 + Ollama/vLLM |
两轨纵贯所有层:Rail A 可观测与评测(LangSmith、Langfuse、Arize Phoenix、Braintrust)、Rail B 治理与安全(RBAC、审计、人在环、OWASP MCP Top 10)。
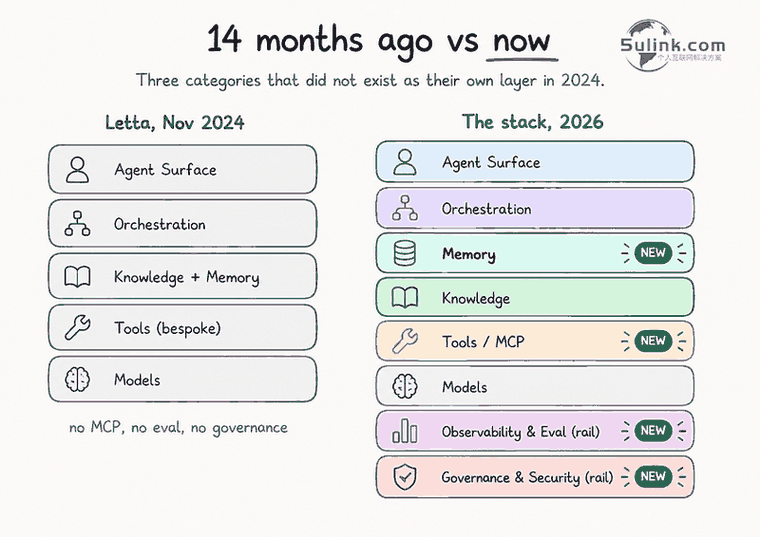
相对 2024 年那张原版图,改了四处
MCP 独立成一层——2024 年原版图里根本没有。Anthropic 于 2024-11-25 发布,走 JSON-RPC 2.0,本地用 stdio、远程用 HTTP+SSE。它解决的数学问题很直白:N 个 agent × M 个工具 = N×M 个自定义集成;两边共用一个协议后简化成 N+M。
记忆从知识里拆出来单列一层——原来记忆和向量库混在一起。
评测成了一等公民——原版图上没有。
厂商原生 SDK 把好几层吸进了单一 API。
各层最该记住的一件事
L6 模型:生产 agent 很少只用一个模型,主流做法是模型路由(RouteLLM 一类)——分类/分流用小模型,硬推理才上前沿模型。升级模型很少能救活一个坏掉的 agent:如果记忆没给对上下文、工具给了脏输入,换更大的模型没用。
L5 工具:agent 只要开始读库、调 API、写文件、开浏览器,你就已经在这层了。
L4 知识:RAG 失败多数不是向量库的锅,是检索质量的锅——哪些块被找到、怎么排序、正确上下文有没有送到模型面前。LongMemEval 的结论是朴素长上下文检索表现不差,所以先当评测问题,再当基础设施问题。
L3 记忆:基准已经换到新量级——LoCoMo(超长对话记忆)、LongMemEval(多会话与时间推理,500 道题)、BEAM(100 万与 1000 万 token 量级,靠加大上下文窗口硬吃已经不行)。难的是”该记什么”:Mem0 的说法是,一条被完美召回的”用户雇主”记忆在他跳槽之后会变成自信的错误——这才是危险的那种。
L2 编排:这层比预期更快商品化。LangGraph 1.0 于 2025-10-22 发布,Klarna、Uber、LinkedIn、JPMorgan 在生产使用;多智能体收敛出四种标准形态:图式(LangGraph)、角色式(CrewAI)、交接式(OpenAI Agents SDK)、层级式(Google ADK)。
Rail A 评测:Gartner 2026-02-02 的《Market Guide for AI Evaluation and Observability Platforms》说,2028 年 60% 的软件工程团队会用这类平台,2025 年是 18%。LangChain《State of Agent Engineering》的数更微妙:89% 的组织有可观测,只有 62% 有细粒度追踪,约一半在跑离线评测——有日志 ≠ 有评测。作者的实操建议:在造第二个 agent 之前先把评测架好。
Rail B 治理:2026 年这条成了试点与生产部署之间的分界。2026 年初针对 MCP 服务器/客户端/工具的 CVE 超过 30 个,其中 43% 是 shell 注入;Grant Thornton 对 950 位高管的调查里,78% 认为自己 90 天内过不了独立的 AI 治理审计;欧盟 AI 法案对高风险系统的全面执行条款在 2026-08 生效。
什么时候才该加层(作者给的信号)
| 别加层的理由 |
真正该加层的信号 |
| “我们想用 LangGraph” |
“我们在手写太多胶水代码来协调模型调用和工具调用” |
| “记忆听起来很酷” |
“用户反复告诉 agent 它本该已经知道的事” |
| “我们有日志” |
“改了 prompt,但完全没法衡量 agent 是变好还是变坏” |
| “安全评审迟早要做” |
“这个 agent 自动做错事的话,我们会心慌” |
| “多智能体听起来高级” |
“单个 agent 的上下文/工具/职责已经多到做不干净” |
默认起手式只有三层:模型 + 工具 + 知识。 多数用例到此为止就够了。
存在证明:编码 agent
要看六层两轨全部装配起来跑在生产是什么样子,看编码 agent 就够了——Claude Code、Cursor、Codex、Devin Desktop 是六层两轨都齐、且都在生产的品类。
小夏点评
这篇最有价值的是那张”加层信号表”:它把”要不要上 LangGraph/记忆/评测”从技术选型问题,改写成”你能不能指出一个具体的失败”。国内很多 agent 项目第一版就配齐六层三厂商,本质是同一件事的反面教材。
数据要分层看:Gartner 的 60%/18% 是预测,LangChain 的 89%/62%/约一半是现状——两者放在一起恰好说明”有可观测、没评测”的缺口。厂商自家基准(Zep、Mem0)作者自己都提醒要谨慎看,这个态度值得照搬。
给中国 IT 运维/开发:三条可直接落地的——① MCP 一旦接入生产,N×M→N+M 的收益是真的,但 43% 的 shell 注入类 CVE 说明协议标准化后安全边界从”代码审查”变成”权限与审计”,RBAC 和审计日志要提前设计;② 评测架在第二个 agent 之前,否则 prompt 迭代只能靠感觉;③ 欧盟 AI 法案 2026-08 全面执行 + 78% 高管自认过不了审计,意味着出海业务的 agent 合同会先谈治理条款——这块国内团队普遍还没准备。
参考来源
Brain Bytes(Eric Roby):The 2026 AI Agent Stack, Drawn from Scratch(2026-06-30)
原文引用基础:Paolo Perrone / O’Reilly:The AI Agents Stack (2026 Edition)、Letta:The AI Agents Stack
标签: AI AgentMCPRAG可观测性架构设计记忆系统
您可能还喜欢...