超微 Super AI Station 实测:能当工作站的 5U AI 服务器,本地大模型跑出 3000 tokens/s
开场:一台”能上机架的工作站”
NVIDIA 把服务器级 GB300 硬件塞进桌面工作站的 DGX Station 项目不缺供应商,各家也各有设计。而 ServeTheHome 在 11 月 5 日实测的这台超微 Super AI Station(ARS-511GD-NB-LCC),是所有 DGX Station 里最”超微”的一台:塔式工作站和 5U 机架二合一,把”放在桌边的服务器”这句话执行得最彻底。
结论先行:这台机器是 STH 测过的 DGX Station 里最安静的之一(STH 原话是”和其他 DGX Station 一样快、一样静”;满载约 39–42 dBA),单核跑分在 DGX Station 阵营里排第一,网络能跑满双 400G——而且它是第一台配 80 PLUS 钛金级电源的 DGX Station。
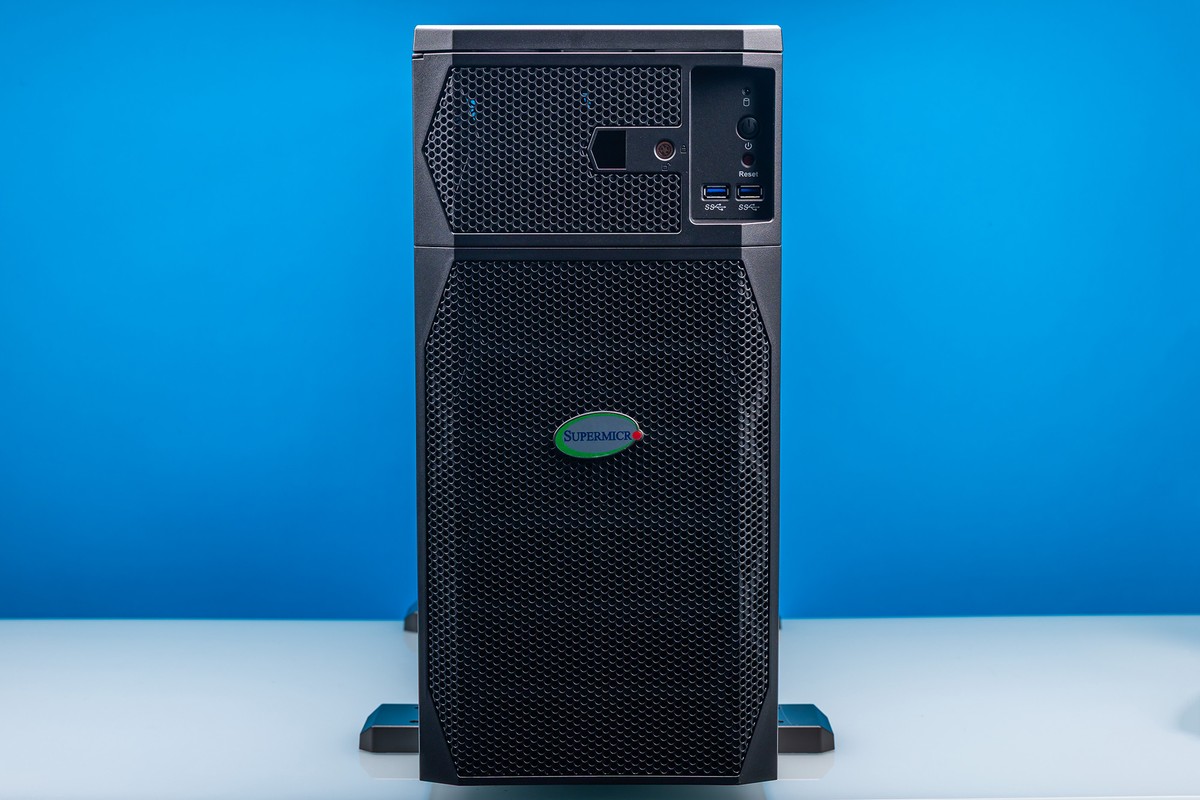
▲ 几乎整块前面板都是进风口——1600W 硬件全靠前到后的贯穿风道散热
关键规格
| 项目 | 规格 |
|---|---|
| CPU | NVIDIA Grace 72 核 Neoverse V2(72C/72T) |
| GPU | NVIDIA Blackwell Ultra(B300 降档版,7 栈 HBM3E 启用) |
| 内存 | CPU 侧 **496GB LPDDR5X(396GB/s)**;GPU 侧 **252GB HBM3E(7.1TB/s)** |
| 存储 | 2× M.2 2280(PCIe Gen6 x4,走 CX8)+ 2× M.2 2280(PCIe Gen5 x4,走 Grace) |
| 网卡 | 2× **400Gbps** QSFP112(ConnectX-8 SuperNIC)+ 10GbE RJ45 + 1GbE BMC |
| 显卡(可选) | NVIDIA RTX PRO Blackwell 2000/4000/6000(测试机装 RTX PRO 2000) |
| 电源 | **1600W 80 PLUS 钛金**(海韵 Prime-TX 1600,ATX 3.1) |
| 形态 | 塔式工作站 / **5U 机架可转换**,218 × 455 × 701 mm,**88 lb(约 40kg)** |
| 散热 | 液冷,外露冷却液罐;前至后贯穿风道 |
| 系统 | Ubuntu 24.04 LTS + NVIDIA AI 开发工具;OpenBMC 带外管理 |
外部:机箱就是它的”服务器血统”
可转换设计直接决定了整机布局:机身比普通塔式工作站更矮(455mm 高,刚好能塞进机架两柱之间)、更深(701mm),顶部和侧面基本不通风——因为机架场景用不上。顶部保留的是挂耳安装点,底部一眼能看出导轨位置,塔式模式需要拧上一对脚垫撑住这 88 lb。
前面板几乎整块都是进风口,唯一的例外是 DGX Station 史上第一个前置 I/O 面板——两个 5Gbps USB-A、电源键(内嵌状态灯)、复位键和硬盘灯,非常”服务器”。后侧 I/O 由 NVIDIA 统一主板决定:两个 QSFP112 由 ConnectX-8 SuperNIC 直出,10GbE 走 Marvell 控制器,另有 BMC 的 1GbE、micro-B UART 和 Mini DisplayPort。测试机上的 RTX PRO 2000 显卡提供真正的图形输出——DGX Station 本身没有集成显示 GPU,BMC 输出是开箱唯一的显示通道。
液冷是 DGX Station 全家桶标配,超微把它做得最”明牌”:外露式冷却液罐挂在机身上部,带液位观察窗和加注/排放口——这是数据中心需要主动维护的机器的习惯,被原样带进了工作站。电源则是第一个跨过钛金级的 DGX Station 电源(此前测过的都是白金级)。
内部:两条独立液冷回路
拆开侧板,STH 的原话是”如果有一张照片能说明这是服务器假扮的工作站,就是这张”。纯前到后风道,散热器放在前面,热风从主板仓和电源仓的下半部穿过。
风扇配置也是服务器式的:前部两个 140mm 风扇拉透厚冷排(其他家用的是 3×120mm),顶部一个 80mm 风扇直接从机外吸风、专供 PCIe 卡和 SSD,后部还有一个 80mm 机箱风扇,以及 STH 首次在 DGX Station 上见到的60mm 专用风扇——给 ConnectX-8 和它的 QSFP112 笼子吹风。
主板是 NVIDIA 统一供应的,倒装:Blackwell Ultra GPU 在左、Grace CPU 与 LPDDR5X SOCAMM 在右、CX8 SuperNIC 在右下角。超微改了冷却方案:别家是一条回路串三颗芯片,超微跑两条独立回路——GPU 一条,CPU + SuperNIC 一条。
存储四槽全被超微插满(480GB Micron 7450 Pro),其中两个 M.2 走 CX8 的 PCIe Gen6 通道——GPU 访问 NVMe 不用被 Gen5 卡脖子。三个全长物理 x16 插槽里,顶部是真 Gen5 x16,下面两个是 x8 电气,全部挂在 Grace 上。BMC 是 P3809,跑 OpenBMC,带 HTML5 iKVM。
拓扑与网络:GPU 侧 800G,CPU 侧只有 229G
这是整机最有信息量的一节。GB300 组合 = Grace CPU + Blackwell Ultra GPU + ConnectX-8 SuperNIC,而GPU 到 CX8 是 PCIe Gen6 x16,所以双 400G 网络能跑满 800Gbps;CPU 到 CX8 只有 PCIe Gen5 x8,上限约 229Gbps——和 GB10 机型双 Gen5 x4 的处境差不多。
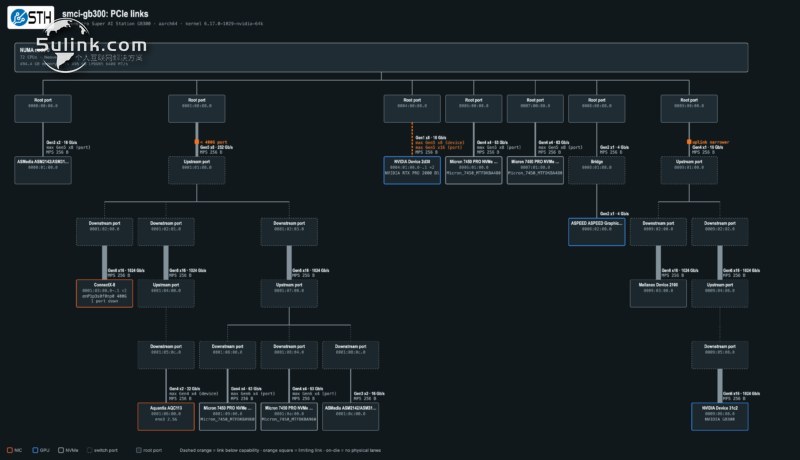
▲ 拓扑图:CX8 上挂着两个 400G 网口、两个 Gen6 x4 M.2、Marvell 10GbE 和 USB 控制器;CPU 侧仅 Gen5 x8
实测数据(STH 双机对测):
| 路径 | 实测载荷带宽 |
|---|---|
| GPU ↔ GPU(双 400G 轨道) | **784.3 Gbps** |
| GPU 侧单轨道 RDMA | **392–400 Gbps** |
| Grace CPU ↔ CPU | **229.0 Gbps** |
RDMA 跑满时 CPU 占用只有约 1.4%(还是轮询造成的)——没有顶级卸载做不到这一步。STH 的评价:这是当今工作站上你能买到的最好网络。
性能:CPU、GPU、图形三块都测了
Grace CPU:单核 AgentSTH V7 上,这台机器拿下 DGX Station 阵营第一,但三家 DGX Station 差距 <3%——NVIDIA 的标准化体验做得非常彻底。对打 x86:单核约为 Threadripper 9980X 的 70%;但喂满线程后,72 核把 64 核 Threadripper 和 24 核 Xeon 都甩在身后。SPEC CPU2026(-O3 估算)里唯一赢它的是 AMD 84 核 EPYC 8635P。STH 的建议很直白:Grace 是为填满线程设计的,填不满就是一堆被浪费的硅。
GPU 推理:STH 用优化过的 Qwen3.8 Flash Next 跑了带/不带工具调用、带/不带 MTP 的全场景扫描,并发 1 到 32——多个场景在并发 32 时超过 3000 tokens/s,且曲线还在往上走;32 并发正好是一个能跑在这类机器上的小型 agent 蜂群,MTP 对结果帮助明显。对比一年前热门的 GPT-OSS-120B,这就是”买一台能用更久”的含义。
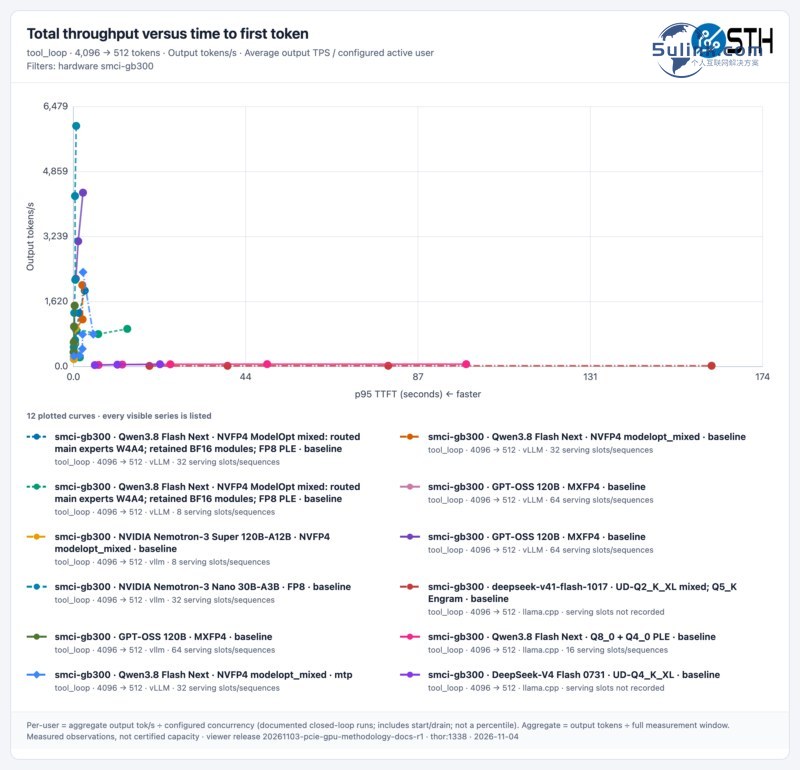
▲ 全模型 tool_loop 吞吐 vs TTFT:Qwen3.8 Flash Next 在并发 32 多场景破 3000 tokens/s
图形:装了 RTX PRO 2000 之后,这台机器跑成了第一台跑 SPECviewperf 15 的 DGX Station(Linux 版 15.0.1 首次支持 Arm AArch64,时间赶得刚好)。4K 下全面领先 GB10 机型 1.75×–4×,1080p 同样如此(除 Siemens NX 外普遍 4 倍以上)——而且用的还是支持列表里最低端的显卡,换 RTX PRO 4000/6000 差距只会更大。工程、医疗、创意岗位对这块很兴奋。
功耗与噪音:最安静的 DGX Station
Blackwell Ultra 在 1.3kW 功耗墙下待机约 152W(各机普遍 147–150W,STH 统一按 148W 记);Grace 模块 300W 上限、待机约 78W;整机待机不低于 250W,上限就是那台钛金电源的 1600W。RTX PRO 2000 只有 70W,对测试基本无感;但上 RTX PRO 6000(300W TDP)就会实打实吃掉 AI 的功耗预算。
噪音是这台机器最”离谱”的部分:满载约 39–42 dBA,待机 36–37 dBA——实验室多次忘了它开着机,只看指示灯才发现。纯服务器式风道 + 双回路液冷,安静到可以放桌边。
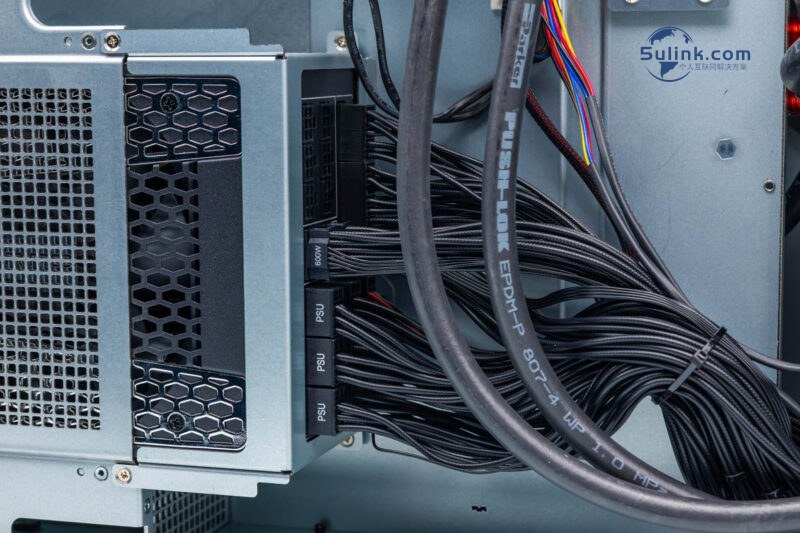
▲ 海韵 Prime-TX 1600(ATX 3.1)——STH 测过的第一台钛金级电源的 DGX Station