
Meta 造了个 Triton 扩展 TLX:warp 级显式编排,RecSys 内核在 H100 上快 4 倍
> 原文:Meta Engineering Blog《How We Built TLX: A Hardware-Native GPU Compiler for Production ML at Scale》,2026-11-10 发布。本文据原文改写,数据以原文为准。
过去几年,GPU 内核优化的主力语言是 CUDA;但 CUDA 的 SIMT 模型太细碎——要表达”warp group 之间怎么分工”,就得手写大量与架构绑定的编排代码。Triton 好用,却把这些执行关系藏在编译器里。
Meta 11 月 10 日在工程博客公开了 Triton Low-Level Extensions(TLX):一个 Triton 扩展,把 warp group 和 cluster 级编排显式化,同时保留 Triton 的生产力与自动调优。这是官方一手披露的工程实践,覆盖 RecSys 训练、RecSys 推理和大规模 LLM 预训练三条线。
为什么要做这件事:硬件跑得比编程模型快
文章给出的背景是硬件演进:Hopper 引入 warp specialization 和 TMA(Tensor Memory Accelerator),Blackwell 又加上 TMEM(Tensor Memory)、cluster 级执行、paired-CTA 执行和更激进的异步执行。
于是典型的现代 kernel 长这样:
- – FlashAttention 里,一个 warp group 负责发 TMA 搬运,另一个负责做 tensor core 计算;
- – Blackwell GEMM 里,多个 warp group 要同时协调 TMEM 分配、cluster 资源。
这些结构”不是计算本身,而是多个执行体之间的协作”,CUDA 能写但要写很久,Triton 写不了。作者的结论是:需要一个介于线程级和 block 级之间的抽象——MIMW(Multiple Instructions, Multiple Warps,多指令多 warp),也就是原文小标题说的”缺失的中间层”(the missing middle)。
Meta 同时给了一组佐证数据:在 Meta 内部 10 个月里,Triton kernel 数量增长 约 3.8 倍,同期 CUDA kernel 增长约 2.0 倍(图 1,以第 1 个月为 1.0 归一化)。
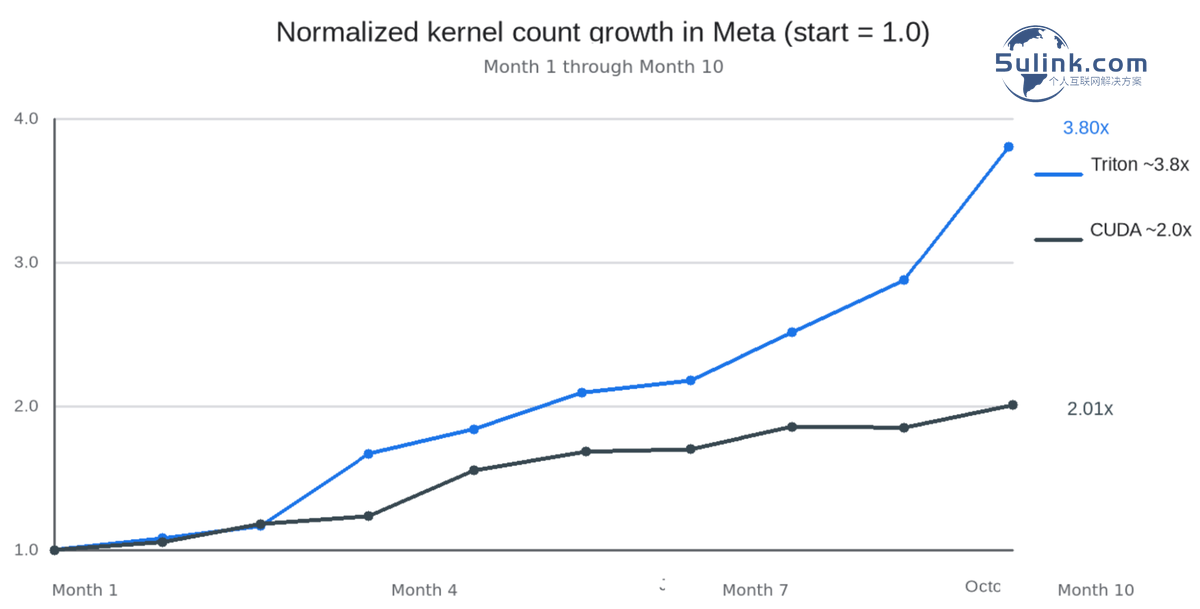
图:Meta 内部 10 个月内 Triton kernel 数量增长约 3.8 倍,CUDA 约 2.0 倍(图表源:Meta Engineering Blog)
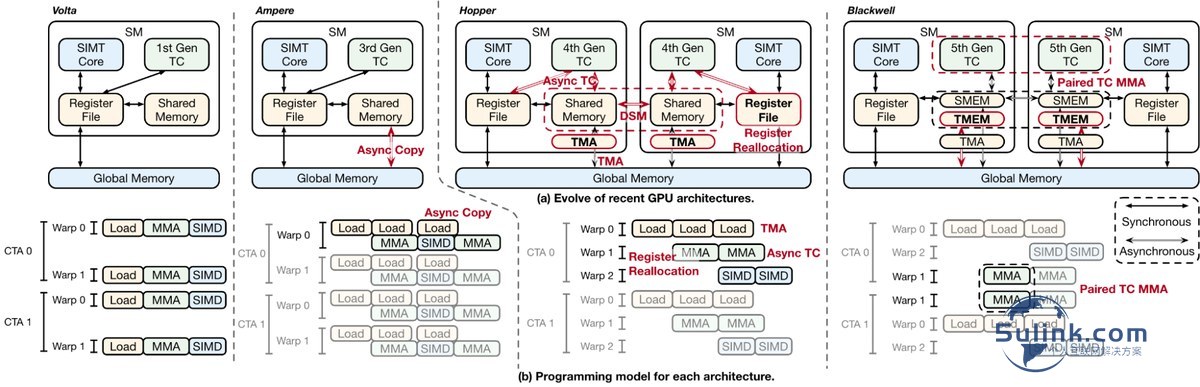
图:从 SIMT 到 SIMB 的演进,warp group 级协作成为编程模型问题(图源:Meta Engineering Blog)
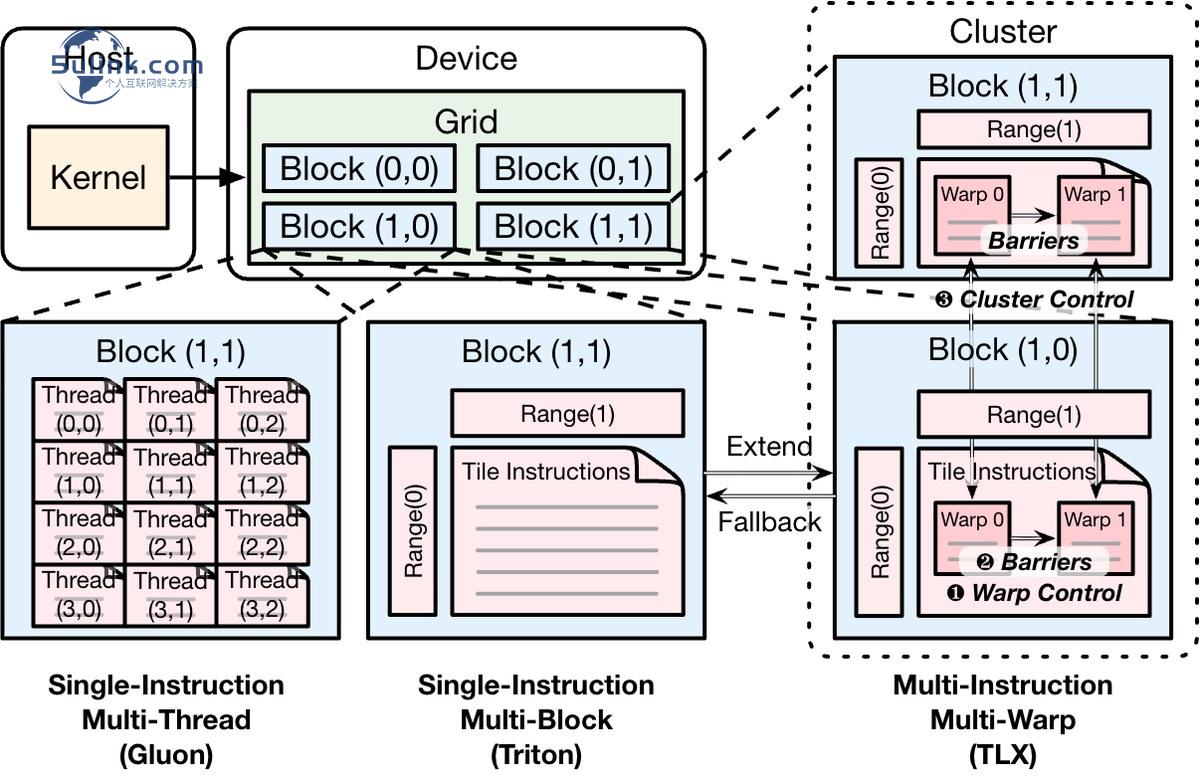
图:MIMW 把执行抽象从”线程”抬到”warp group”,填补 SIMT 与 SIMB 之间的空白(图源:Meta Engineering Blog)
TLX 提供了什么
TLX 不另起炉灶做一门新语言,而是在 Triton 之上加一层执行导向的构造——”Triton 回答该算什么,TLX 回答该怎么编排”。五个方向:
- 1. Warp group 编排:把 warp group 当一等执行体,显式分配 producer(搬数据)、consumer(tensor core 计算)、epilogue(写回结果)角色。
- 2. 同步:在 warp group 级而非线程级表达依赖,用 mbarriers 这类硬件原语建 producer-consumer 流水线。
- 3. 访存编排:直接操作 TMA、异步 tensor memory 等硬件能力。
- 4. Cluster 执行:把 cluster 级执行做成一等公民,多个 CTA 通过分布式共享内存和 cluster 级同步原语协作,省掉原本要绕全局内存的片上通信。
- 5. 布局可选:不像 CUDA/CUTLASS 必须先声明 layout 才能写计算,TLX 由编译器自动推断,只在为性能覆盖时才写。
因为布局是自动推断的,融合就变容易了——归一化这类操作可以直接融进 GEMM 与 attention kernel,省掉中间内存往返。Meta 还配了 ACE(Agent for Compute Efficiency),用 AI 自动做 profiling、分析与调优,缩短单个 kernel 的优化周期。
代码层面的差别很直观:标准 Triton 的 matmul 是同步的”加载—计算—丢弃”循环;TLX 版本用 tlx.local_alloc 分配共享内存 buffer、用 tlx.async_tasks() 划分 producer / consumer / epilogue 三组 warp group、用 tlx.barrier_wait 和 tlx.async_dot 做流水,计算部分仍然是 Triton。
三个生产案例的硬数据
| 案例 | 硬件 | TLX 解决的问题 | 结果 | 落地位置 |
|---|---|---|---|---|
| GEM 模型训练 | NVIDIA Blackwell | 异构 RecSys 基础模型要摸到 roofline MFU,标准 Triton 之上需要 warp specialization + 显式 tensor memory 控制 | 数千张 GPU 上端到端 MFU 20–25% | GEM 训练栈 |
| IKBO(kernel 内广播优化) | NVIDIA Hopper | 用户特征被复制几十份去匹配候选维度,带宽和算力白扔 | 计算密集型净延迟最多降 2/3;线性压缩 kernel H100 上快 4 倍 | RecSys 推理(粗排→精排),GPU + MTIA |
| 分布式 grouped GEMM | NVIDIA Blackwell | 专家并行 MoE 的分组矩阵乘要跨节点通信,现有实现还有余量 | 大集群长时间连续运行,生产验证 | 大规模 LLM 预训练 |
案例一:GEM 训练,20–25% 端到端 MFU。
Meta 最新的 GEM 训练栈在数千张 Blackwell GPU 上跑到了 O(10^24) 总量训练 flops,端到端 MFU 20–25%。作者明确说这里需要 warp specialization 和显式 tensor memory 控制,标准 Triton 到不了这个水平。TLX 的 GDPA(Generalized Dot Product Attention)kernel 把 GEM 里大量 attention 类操作统一进单个 GPU kernel,前向最高快 2 倍,同时实现复杂度大幅低于手写版本。
案例二:RecSys 推理的 in-kernel broadcast,最高 4 倍。
问题很具体:推荐场景里同一个用户特征会被复制几十份去和候选集打分,浪费的显存带宽随候选数线性增长。IKBO(In-Kernel Broadcast Optimization)把广播搬进 kernel 内部,让 kernel 直接吃”用户侧和候选侧不匹配的 batch 尺寸”,隐式完成广播。最终那个线性压缩 kernel 用 warp-specialized、多级流水的 TLX 实现,在 NVIDIA H100 上快 4 倍,整个计算塌缩成单个 persistent mega-kernel,producer/consumer warp group 用 ping-pong 调度共享环形 buffer。对 FlashAttention 而言,IKBO 把 kernel 从 I/O-bound 推到 compute-bound,计算密集型净延迟最多降低三分之二。
案例三:大规模 LLM 预训练。
基于 TLX 的分布式 grouped GEMM kernel 已部署在 Meta 的大规模预训练基础设施里,在大规模 GPU 集群上连续运行了较长时间,服务 MoE 模型所需的分组矩阵乘。它把计算与通信紧耦合以降低端到端延迟——作者强调在这个规模上峰值吞吐只是其中之一,可靠性、可调试性、长期性能稳定性同样关键。
跨 NVIDIA 与 AMD GPU,TLX 的定位是”把 SOTA kernel 与显式执行编排、模型感知融合结合起来,拿到超越独立库的整体收益”。
小夏点评
- 1. 这篇最实用的信息不是 4 倍,而是”编译器追不上硬件”这件事本身。文章直言这是”编译器追赶问题”:每代硬件都带来新的执行能力,程序员要么等编译器支持,要么自己掉进高度特化的实现里。对国内做国产算子栈的团队来说,TLX 代表了一条值得掂量的路线——在 Triton 这类生产力框架上加一层显式编排,比自研一门 DSL 更现实。
- 2. 三个案例的收益分布很不均匀,选型时要看清自己在哪一档。GDPA 的 2 倍和 IKBO 的 4 倍都是模型-运行时-内核协同设计的结果——IKBO 明确要求改模型架构和推理运行时,不是换个 kernel 就能拿到的;而”性能与手写 CUDA 持平但迭代快得多”才是 TLX 的普适价值。做收益预期时应按第三档算,别按 4 倍算。
- 3. 国内落地的三个具体障碍:一是门槛只在 Hopper 及以后才有意义,TMA、TMEM、mbarrier 都是新硬件特性,国产卡上要重新落到自己的访存与同步原语上,等于要自己写一遍后端;二是多 warp 流水对调试的门槛——作者自己强调可靠性与可调试性,mega-kernel 一旦 hang 很难定位,引入前建议先把卡死检测与回退到普通实现的机制做进 CI;三是收益要用自己的业务模型重测,Meta 的 4 倍来自推荐系统的特征广播模式,结构非常特殊,通用 dense attention 上能不能拿到同样收益,原文没有给数据。国内做推荐或广告的团队可以优先试 IKBO 路线,做 LLM 训练基础设施的团队则更该关注分布式 grouped GEMM 那条线。
原文链接
- – Meta Engineering Blog:How We Built TLX: A Hardware-Native GPU Compiler for Production ML at Scale(2026-11-10)
How We Built TLX: A Hardware-Native GPU Compiler for Production ML at Scale
- – TLX 论文(arXiv)
https://arxiv.org/abs/2605.10905
- – 原文列出的 TLX kernel 深入解析合集(全部七篇:六篇 PyTorch 官方博客 + 一篇 AMD 技术文章)
- – In-Kernel Broadcast Optimization: Co-Designing Kernels for RecSys Inference
https://pytorch.org/blog/in-kernel-broadcast-optimization-co-designing-kernels-for-recsys-inference
- – TLX Block Attention: A Warp-Specialized Blackwell Kernel for Fixed-Block Sparse Self-Attention
https://pytorch.org/blog/tlx-block-attention-a-warp-specialized-blackwell-kernel-for-fixed-block-sparse-self-attention
- – Fast 2-Simplicial Attention: Hardware-Efficient Kernels in TLX
https://pytorch.org/blog/fast-2-simplicial-attention-hardware-efficient-kernels-in-tlx/
- – Enabling Cluster Launch Control with TLX
https://pytorch.org/blog/enabling-cluster-launch-control-with-tlx/
- – Achieving Free Normalization: Fusing Norms into GEMM and Attention via TLX
https://pytorch.org/blog/towards-free-normalization-fusing-normalization-into-gemm-and-attention-kernels/
- – Optimizing Jagged Flash Attention with TLX: The Road Toward SOTA FA4 on Blackwell
https://pytorch.org/blog/optimizing-jagged-flash-attention-with-tlx-the-road-toward-sota-fa4-on-blackwell/
- – Optimizing GEMM + Activation on CDNA4 with TLX(AMD 技术文章)
https://www.amd.com/en/developer/resources/technical-articles/2026/optimizing-gemm-with-tlx.html