稀疏注意力的新外挂:LMSYS 联手 Netpreme,KV 外置换内存层,解码快 2–3 倍
> 原文:LMSYS Blog《XM-Sparse: Pushing the Throughput Frontier of Sparse Attention with Netpreme X-Mem™》,作者 Netpreme Team,2026-11-05 发布。本文据原文改写,数据以原文为准。
稀疏注意力(sparse attention)有个尴尬:每一步 decode 只用到少数 KV 条目,但完整 KV 缓存一个都不能丢,因为”选哪些”会随生成过程变化。于是显存不够时,大家只能把 KV 往外挂——而外挂如果带宽不够,解码延迟就会被拖垮。
LMSYS 博客 11 月 5 日发布的一篇技术文章给出了新解法:把外挂的 KV 从普通内存换成专门的高带宽内存层,配合 SGLang 的 HiSparse 稀疏注意力路径,在 16K 上下文下把 TPOT(每输出 token 时间)压掉 49.25%,峰值解码吞吐做到 PCIe 方案的 2.09–3.04 倍。
需要先说明的是:文章署名 Netpreme Team,发布在 LMSYS 官方博客上,测的是自家 X-Mem 内存处理单元(MPU)——带有明确的厂商立场。但它的建模方法和测试口径公开得比较完整,数据仍可作为参考。
> 补充一句区别:我们前几天发过的《把 KV 缓存挪进 SSD:首 token 延迟降了 4 倍》讲的是存储层(SSD 撑前缀缓存,目标是压 TTFT);这篇讲的是内存层 + 稀疏注意力选路(只取本步真正要用的 KV 条目,目标是压 TPOT、提高高并发下的解码吞吐)。两者优化的环节和指标都不一样,可以对照看。
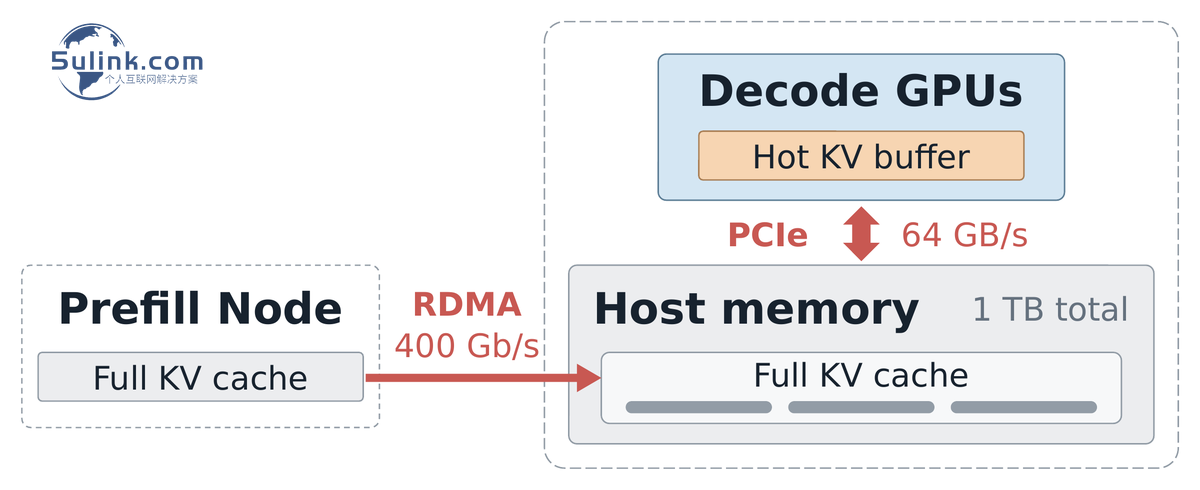
图:现有 KV 卸载架构,完整 KV 在主机内存、decode GPU 只保留热 KV buffer,缺失条目经 PCIe 回取(图源:LMSYS Blog)
瓶颈到底在哪:带宽和容量两个独立的墙
文章把外部内存方案拆成四种配置做建模对比:
| 外部内存方案 | 每 GPU 带宽 | 四卡实例总容量 |
|---|---|---|
| PCIe(基线) | 64 GB/s | 1 TB |
| CXL | 64 GB/s | 24 TB |
| NVLink-C2C(Grace-Blackwell) | 225 GB/s | 1 TB |
| Scale-up 扩展内存 | 900 GB/s | 24 TB |
模型跑的是 GLM-5.3,四张 B300 做 decode(attention DP4 + MoE EP4)。每个请求每层保留 4096 token 的热 KV buffer,每步从完整 KV 中选出 2048 个条目;每 GPU 划出 60 GiB HBM 给热 KV 和索引缓存,外部内存占比假设为 20% miss 率(来自此前 trace 分析)。
结论很直接——高吞吐需要同时满足容量和带宽,缺一不可:
- – 128K 上下文(编码 Agent 的典型场景):1 TB 配置受容量限制,每 GPU 只能跑 batch 36,就算换成 225 GB/s 的 NVLink-C2C 也无济于事;扩到 24 TB 后 batch 提到 109,但这时 PCIe-CXL 就成了带宽瓶颈,此时 900 GB/s 的 scale-up fabric 拿到 1.39 倍吞吐。
- – 16K 上下文:容量不是问题(每 GPU batch 241 时,四卡合计只用 0.85 TB,仍在 1 TB 预算内),纯带宽决定胜负,900 GB/s 相对 64 GB/s PCIe 拿到 1.80 倍。
- – 1M 上下文:容量重新成为主约束,同样 64 GB/s 带宽下,把容量从 1 TB 扩到 24 TB 把可行 batch 从 4 提到 20,吞吐 2.34 倍。
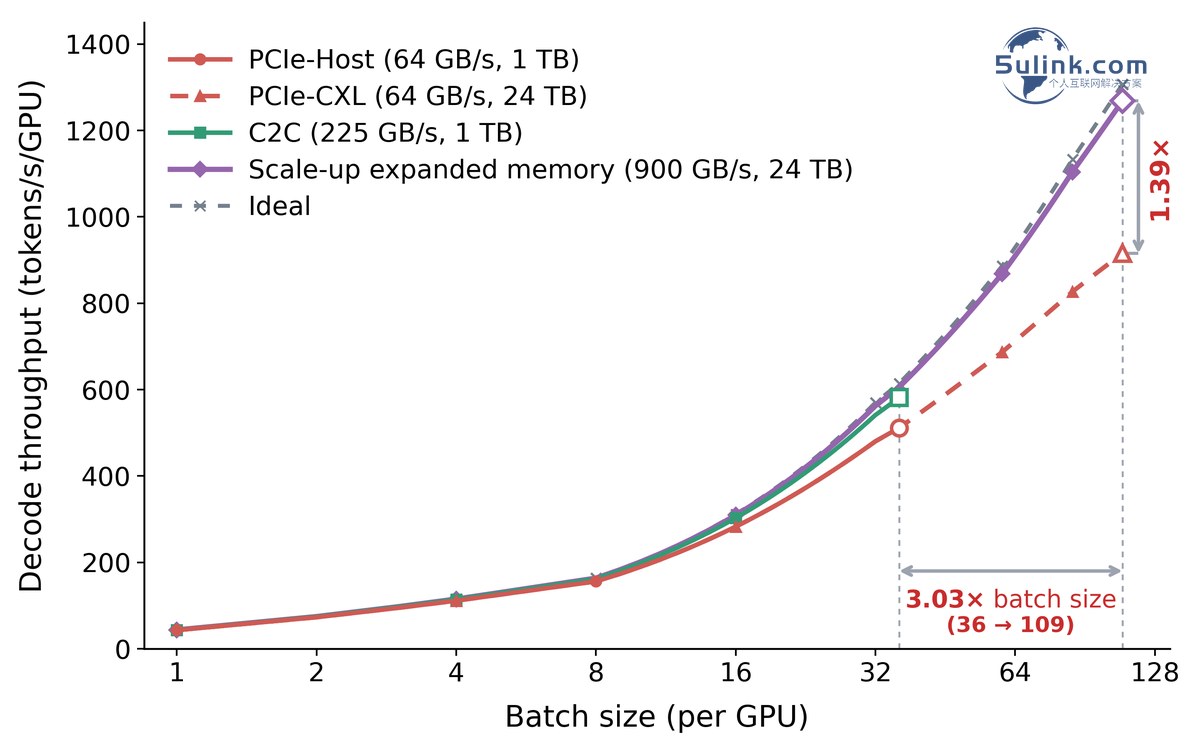
图:128K 上下文下四种外部内存配置的解码吞吐建模,容量与带宽同时构成约束(图表源:LMSYS Blog)
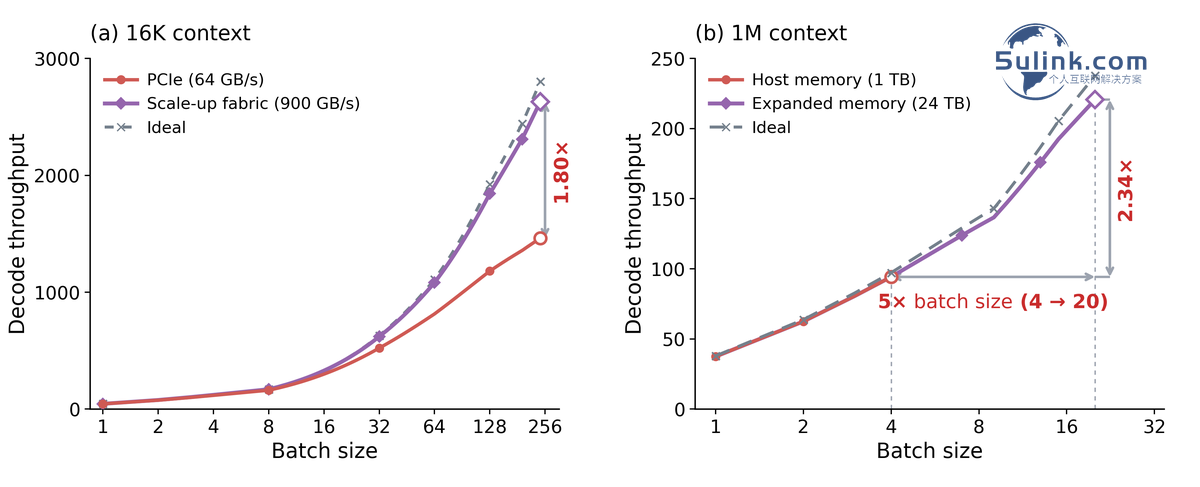
图:(a) 16K 与 (b) 1M 上下文下的建模吞吐与每 GPU batch(图表源:LMSYS Blog)
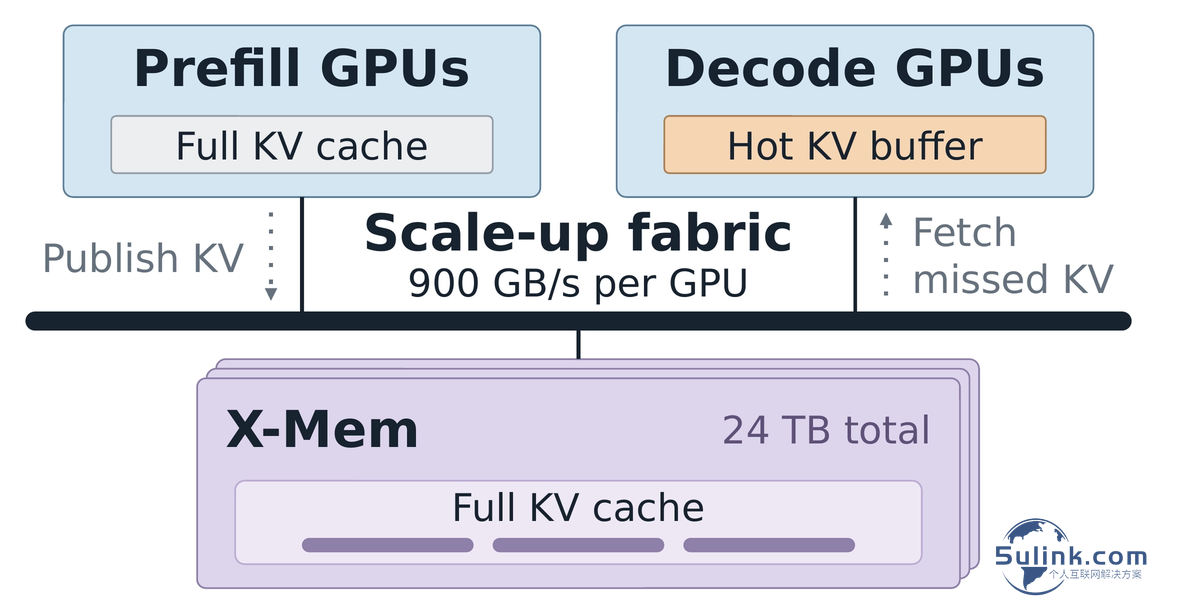
图:KV 缓存卸载到 Netpreme X-Mem 的架构,prefill GPU 发布 KV,decode GPU 经 scale-up fabric 取回缺失条目(图源:LMSYS Blog)
实测:TPOT 降一半,吞吐翻两三倍
在 X-Mem Pilot 虚拟机上,用 SGLang HiSparse 做实测:
同 batch 下的延迟对比(16K 上下文,每 GPU batch 192,关闭 prefetch):
| miss 率 | host DRAM over PCIe | X-Mem | TPOT 降幅 |
|---|---|---|---|
| 20% | 167.48 ms | 84.99 ms | -49.25% |
| 40% | 255.69 ms | 93.13 ms | -63.58% |
小 batch 差别不大,甚至可能略慢;batch 越大收益越明显。miss 率越高,降幅越大——因为要回外部内存取的 KV 变多了。
峰值吞吐对比(20% miss,取各配置最高吞吐的 batch):X-Mem 在 16K–1M 各上下文长度上达到 host DRAM 的 2.09–3.04 倍。
需要说明的是测量条件:decode 用 4 张 B300,另用 4 张 B300 的 HBM 充当 X-Mem 内存(走与真实硅片相同的访问路径),容量按 24 TB 预算建模而非物理显存;host DRAM 对照组按 1 TB 预算;用的是合成 KV 前缀与固定 miss 率,prefetch 关闭。硅片本身”稍后才会上市”——目前能拿到的是 Pilot VM。
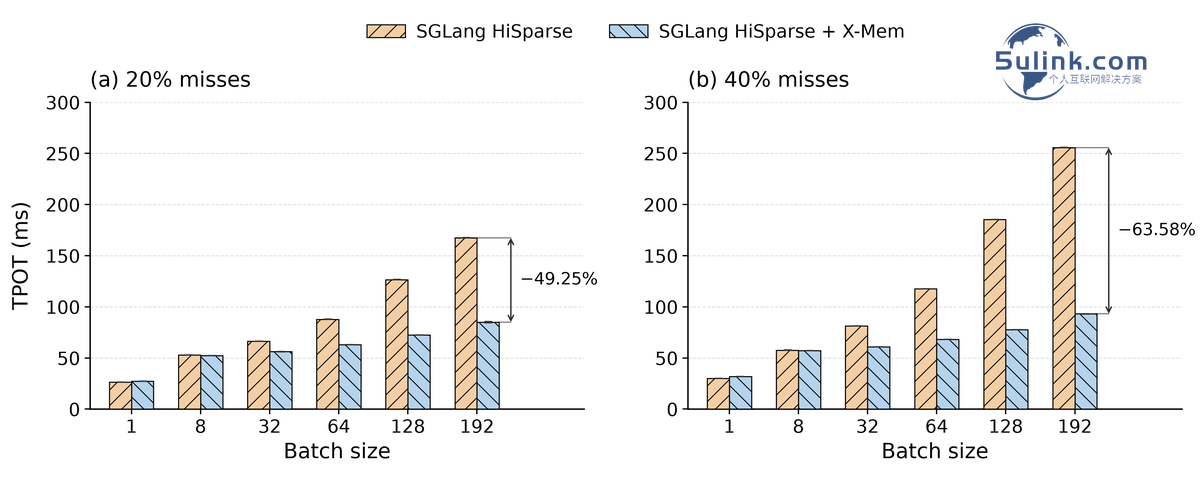
图:16K 上下文、关闭 prefetch 时的平均 TPOT,(a) 20% miss、(b) 40% miss,箭头标出 batch 192 处的降幅(图表源:LMSYS Blog)
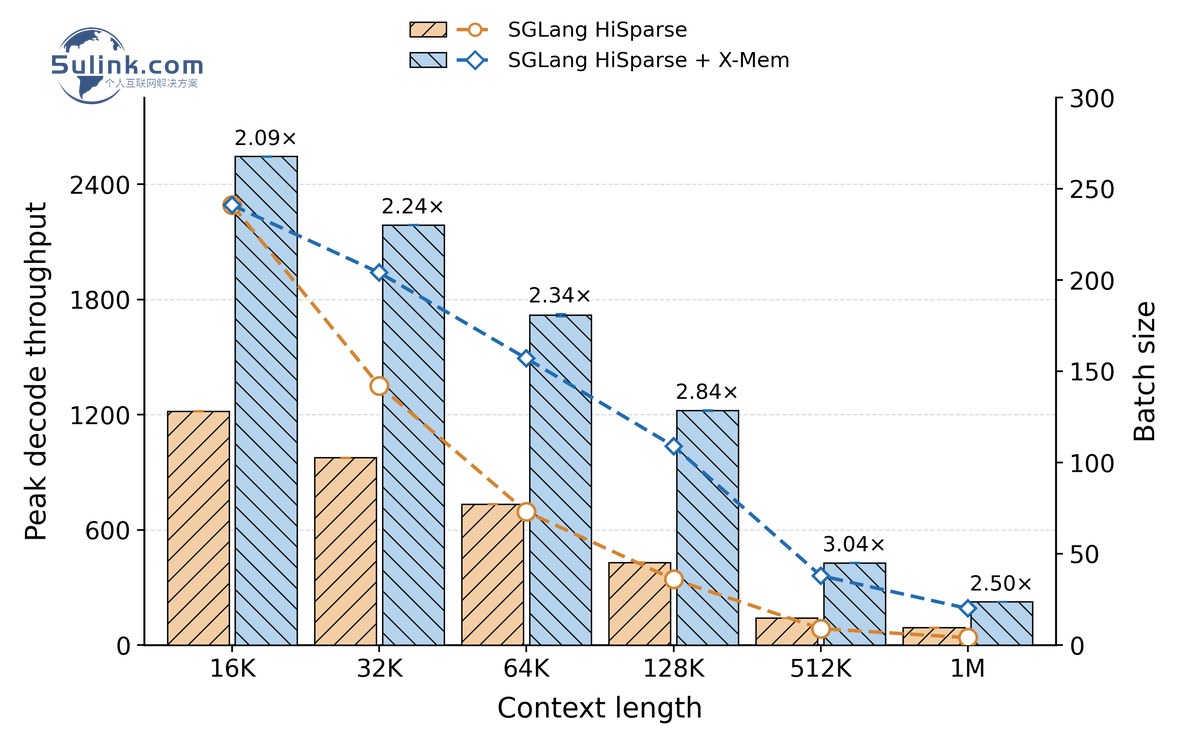
图:20% miss 下的峰值解码吞吐(每 GPU tok/s),虚线为每 GPU batch,蓝柱上方为相对 host DRAM 的倍数(图表源:LMSYS Blog)
X-Mem 是什么形态的东西
Netpreme X-Mem 是一种内存处理单元(MPU),定位是”机架里的专用内存节点”,通过高速 fabric 对 GPU 暴露可寻址内存:
- – 单节点 4 个 MPU,最高 24 TB DDR5 内存,聚合内存带宽约 4 TB/s,由机架内 GPU 共享;
- – 支持 GPU 对等访问,内存层可以独立于算力横向扩展;
- – 通过 CUDA / PyTorch 兼容 API 暴露,保留 HiSparse 的稀疏选择、缓存管理与 prefetch 机制,支持 CUDA Graph 捕获与重放(decode 计算和 selected-KV 取回都能 capture);
- – 共享前缀请求可以共用同一份 KV,避免重复存储;owner 进程创建共享内存区域,其它进程用可移植描述符 attach,全部 detach 后才释放物理内存。
生命周期也很清楚:prefill GPU 直接把 prompt KV 写入 X-Mem → 发布完成后 decode 无需先在 decode 侧 HBM 里落一份完整 prompt → decode 每步从本地热 buffer 找,没命中的再回 X-Mem 取 → 新生成的 KV 追加回 X-Mem 供后续步骤使用 → 请求结束后等所有 KV 访问完成再回收。
小夏点评
- 1. 这篇最值得抄的不是数字,是那套”带宽 × 容量”双约束模型。B_max = min(HBM 允许的 batch, 外部内存允许的 batch),两条线哪条先卡住,决定你该加显存还是加带宽。国内的推理集群做扩容规划时,经常只盯着”显存放不放得下”,结果加完显存发现瓶颈在 PCIe 带宽上——文章里 128K 场景正是这个陷阱:换 225 GB/s 的 NVLink-C2C 也没用,因为容量先卡死了。
- 2. TPOT 降 49.25% 这条只在 batch 192 时成立,小 batch 甚至可能更慢,这个前提必须照抄进任何选型结论。它意味着稀疏注意力的内存层收益只在高并发场景兑现——低并发的在线服务、批处理式的离线任务都吃不到。评估时务必按自己的真实 batch 分布测一遍。
- 3. 国内落地要过三道关:一是内存层的位置——900 GB/s 的 scale-up fabric 目前是 NVLink 域内的事,跨机架 RDMA 的带宽离这个量级差着数量级,X-Mem 这类”内存进机架”的形态暂时难以照搬;二是容量口径——模型里的 24 TB 是按建模预算给的,真实集群里 1 TB 预算跑 128K 上下文时 batch 只有 36,扩内存的收益要按自己的 miss 率重新折算;三是厂商绑定风险——硅片还没上市,今天能用的是 Pilot VM,采购决策前务必在真实负载上复现这套测试方法。另外提醒一句:SGLang HiSparse 这条稀疏注意力路径本身与常规 dense attention 的推理质量差异,文章没有给出评测,落地前要自己补一轮业务侧效果验证。
原文链接
- – LMSYS Blog:XM-Sparse: Pushing the Throughput Frontier of Sparse Attention with Netpreme X-Mem™(2026-11-05)
https://www.lmsys.org/blog/2026-11-04-xm-sparse
- – Netpreme X-Mem 早期访问(Pilot VM 申请)
https://netpreme.com/xmem/early-access
- – SGLang HiSparse 稀疏注意力(前作介绍)
https://lmsys.org/blog/2026-04-10-sglang-hisparse/
- – SGLang 开源仓库
https://github.com/sgl-project/sglang