
AI 集群后端网络横评:InfiniBand、Spectrum-X、RoCE 与标准以太网怎么选
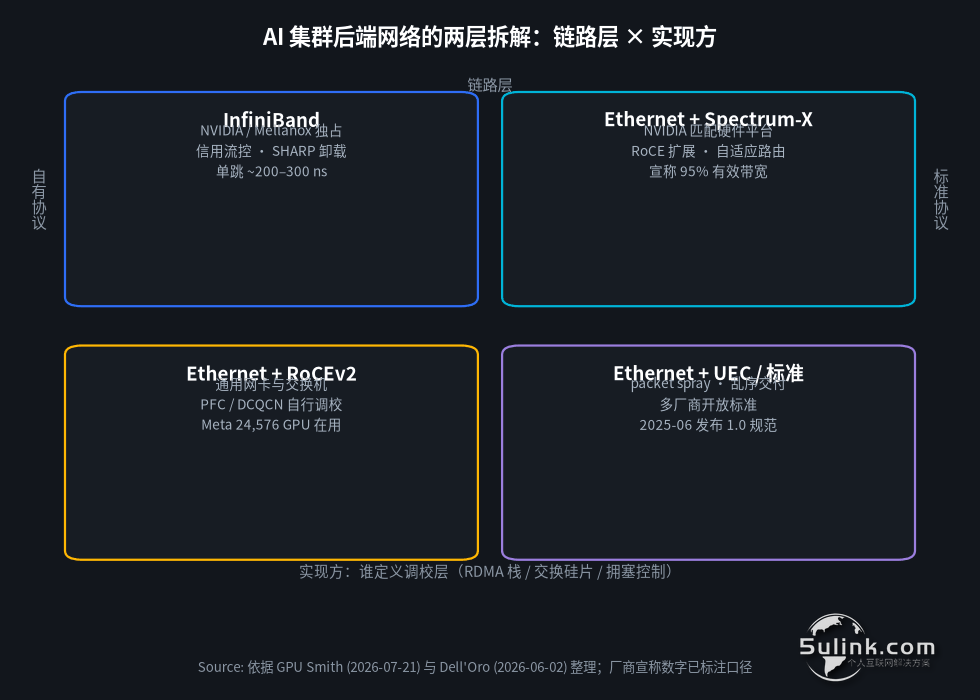
在 2026 年为 AI 集群选后端网络时,真正摆在面前的并不是四个独立选项,而是两个链路层选择(InfiniBand 与以太网)× 一个实现方问题(用谁的 RDMA 栈、谁的芯片)。
这句话看起来像绕弯子,但它决定了后面所有的选型逻辑:如果只是比”InfiniBand 还是以太网”,你会被各种营销话术带着跑;一旦拆成链路层和实现层,你会发现市场上其实是四个象限同时在长大,而不是一家吃掉另一家。
本文主源是一份 2026 年 7 月 21 日发布的分析师长文(约 39 分钟阅读),覆盖 Dell’Oro 与 650 Group 的市场数据、延迟基准,以及 Meta、xAI、Oracle 的真实部署案例。
为什么要单独给 AI 集群建一张网
先把前提说清楚。分布式训练作业在每个 batch 之后要在几万张 GPU 之间同步梯度,Arista 的 AI 网络白皮书指出,在这个”计算-交换-归约”循环中,约 20–50% 的作业时间花在跨网络通信上。通信一旦成为瓶颈,作业完成时间就直接被拖长。
所以从通用企业流量里单独拆出一张后端(east-west)网络,已经成了大规模 AI 集群的标准配置。Meta 在建 24,576 GPU 集群时,就明确把 GPU 训练隔离到了独立的后端网络。
物理拓扑上,四条路线几乎共用同一套底层骨架:非阻塞 Clos 或 fat tree,每个叶交换机(ToR)连到所有脊交换机,任一 GPU 到任一 GPU 跳数相同、可用带宽相同,避免热点。NVIDIA 的 Quantum-X800 InfiniBand 交换机宣称支持两级 fat tree,可连接最多 10,368 个网卡。
四条路线的本质区别
InfiniBand:为 RDMA 而生
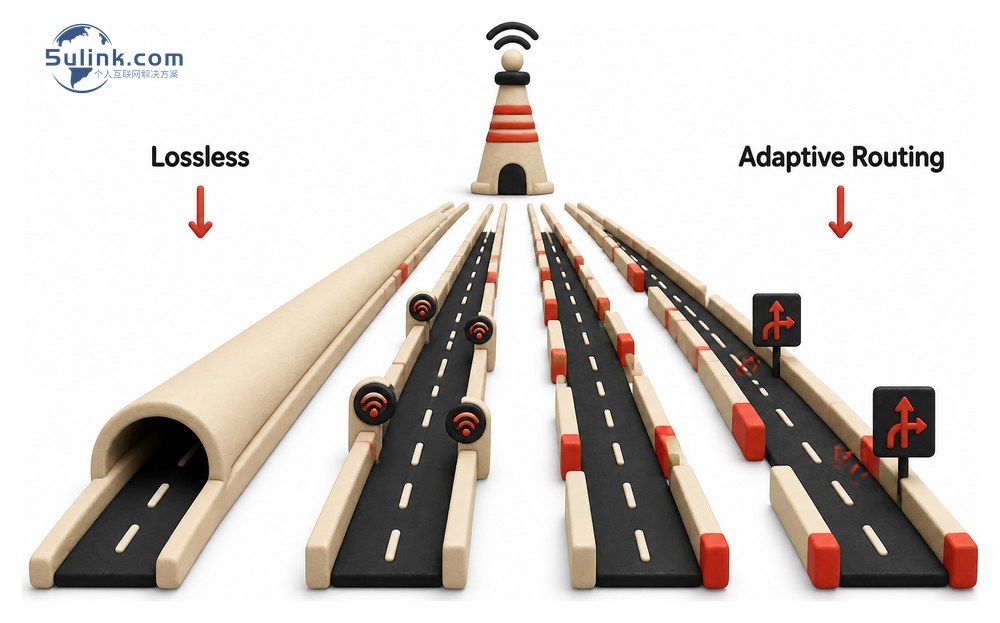
InfiniBand 从上世纪 90 年代末起就围绕 RDMA 和基于信用的无损流控设计,链路级信用机制保证接收缓冲区先有空间再发送,架构上就不丢包。
当前旗舰 Quantum-X800 宣称是全球首个端到端 800 Gb/s 网络,每台交换机 144 个 800 Gb/s 端口。上一代 Quantum-2(NDR)在 1U 机箱内提供 64 个 400 Gb/s 端口、双向聚合吞吐 51.2 Tb/s。IBTA 在 2025 年 7 月 31 日发布的 Volume 1 Release 2.0 规范,支持 XDR 每通道 200 Gb/s,对应 800 Gb/s(QSFP)和 1.6 Tb/s(QSFP-DD / OSFP) 的链路带宽。
两个 IB 独有的能力:自适应路由依靠实时队列深度遥测绕开拥塞链路,而不是静态哈希;SHARP(现已在 Quantum-X800 上到第四代)把 all-reduce 这类集合操作卸载进交换芯片,NVIDIA 报告部分服务商在自研 AI 工作负载上获得 10–20% 性能提升。
弱点也很清楚:供应商集中度。NVIDIA(2019 年收购 Mellanox)实际上是唯一能规模供应 InfiniBand 交换芯片与主机通道适配器的厂商,这带来”单一供应商定价”的成本溢价。同时 InfiniBand 通常需要专门的子网管理器和与常规以太网运维不同的技能栈。
NVIDIA Spectrum-X:不是新协议,是调校过的以太网平台
Spectrum-X 官方定义是”全球首个面向 AI 的以太网网络平台”,把 Spectrum 交换机与 BlueField / ConnectX SuperNIC 配成一对匹配硬件,再叠加 NVIDIA 的专有 RoCE 扩展——RoCE 自适应路由、拥塞控制和性能隔离,目标是让 RoCEv2 以太网在大规模下逼近 InfiniBand。
NVIDIA 的官方宣称是相比通用现成以太网性能提升 1.6 倍,并能在超过 10 万 GPU 的部署中维持最高 95% 的有效带宽。这两个数字都应读作厂商口径,不是第三方测量。
Spectrum-X Multiplane 架构把每张 GPU 的 SuperNIC 拆到两个或更多独立网络平面,两级拓扑下可扩展到 128,000 GPU。2025 年 8 月追加的 Spectrum-XGS Ethernet 是”scale-across”层,用于把多个物理分离的数据中心连成一个巨型训练域,NVIDIA 称其 NCCL all-reduce 带宽比现成以太网最高提升 1.9 倍。
Spectrum-X 的价值在于:跑的是标准可路由以太网帧,能与超大规模云其余的以太网融合、支持多租户,网络操作系统用 SONiC 或 NVIDIA Cumulus。但它本质上仍是 NVIDIA 定义的匹配硬件平台——收窄了却没有消除供应商集中的问题。
RoCEv2:把 RDMA 语义搬回以太网
RoCEv2 的做法是把 RDMA 流量封装进 UDP/IP 包,从而能穿过普通 IP 路由器、与数据中心现有以太网基础设施共存。这让它成为最容易上车的以太网路线。
代价是拥塞控制。2022 年 UT Austin、Georgia Tech 与 Meta 的研究指出,基于 PFC(优先级流控)的原生 RoCE 拥塞控制方案”存在不公平、队头阻塞与死锁等多重缺陷”。PFC 的死锁问题正是 Meta 最终只跑 PFC-only、把拥塞管理交给集合通信库驱动的原因——这是理解 RoCE 部署时最容易被跳过的一行字。
标准以太网与 UEC:把各家私有的传输创新标准化
第四条路线是通用以太网正在演变成的 Ultra Ethernet。UEC 于 2023 年由 AMD、Arista、Broadcom、Cisco、Eviden、HPE、Intel、Meta、Microsoft 共同创立,2025 年 6 月发布 UEC 1.0 规范。
UEC 1.0 的关键在于定义了 packet spray(跨全部路径做包喷洒)、乱序交付与选择性重传,目标是减少对 PFC 的依赖——本质上是把 InfiniBand 当年那些传输技巧标准化到以太网上。该规范覆盖拥塞控制、RDMA 传输与多厂商互操作;相关篇幅与版本信息据 Introl 整理(行业博客口径,UEC 1.0.2 规范)。
落地进展比规范本身更有说服力:AMD 的 Pensando Pollara 400 是业界首款符合 UEC 1.0 的网卡,Oracle 是首家部署它的云服务商;AMD 随后推出 800 Gb/s 的 Vulcano(完全符合 UEC 1.0,支持 PCIe 与直连 CPU/GPU 的双接口);Broadcom 则推出 Thor Ultra,称其为业界首款 800G 以太网网卡且完全符合 UEC 规范。
四项硬指标横向对比
| 维度 | InfiniBand | NVIDIA Spectrum-X | RoCEv2(通用以太网) | Ultra Ethernet / 标准以太网 |
|---|---|---|---|---|
| 链路层 | 原生 InfiniBand | 以太网 | 以太网 | 以太网 |
| 丢包处理 | 原生信用流控,架构级无损 | PFC + NVIDIA RoCE 拥塞/自适应路由扩展 | PFC,ECN/DCQCN 可选;Meta 最终 PFC-only | UEC 1.0 定义 packet spray、乱序交付、选择性重传 |
| 典型单跳延迟 | **约 200–300 ns** | 厂商优化,比通用以太网紧,未独立披露纳秒值 | 约 **300–3,000 ns**,随硬件与模式变化 | 与通用以太网同一硅基,UEC 目标是缩小差距 |
| 单 fabric 规模(公开宣称) | 两级 fat tree 下最多 **10,368 个网卡** | Multiplane 两级扁平拓扑可达 **128,000 GPU** | Meta 已部署一个 24,576 GPU 的 RoCE 集群;Oracle 目标 80 万 GPU | 截至 2026 年中尚未在同等规模上验证 |
| 供应商生态 | 实际单一(NVIDIA/Mellanox 硅) | NVIDIA 定义的交换机 + SuperNIC 配对 | 广泛:任何支持 RoCEv2 的网卡与交换机 | 开放多厂商(Broadcom、Cisco、AMD、Arista、Marvell 等) |
| 代表部署 | Azure ND H100 v5 | xAI Colossus(10 万–20 万 GPU) | Meta RoCE 版 24,576 GPU 集群(用于 Llama 3 训练) | AMD Pollara @ Oracle,首个 UEC 合规部署 |
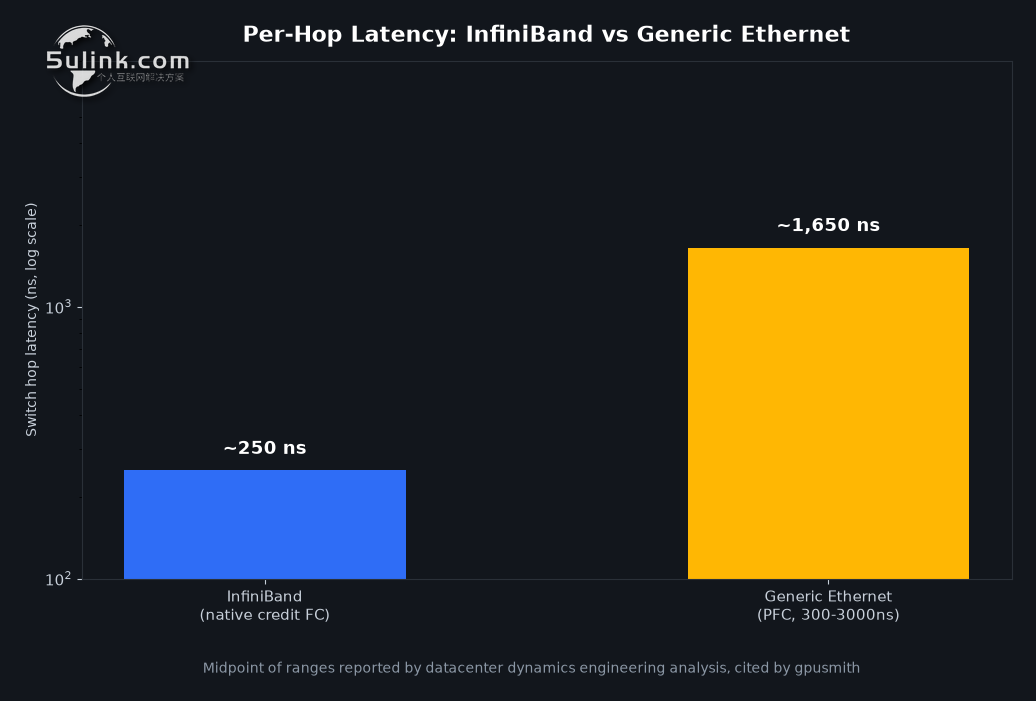
最尖锐的技术差异仍然是延迟与丢包处理的确定性:InfiniBand 在每跳几百纳秒的量级上仍占优,而这个差距对超大规模买家而言,正在被规模、多租户和生态因素逐渐盖过。但没有一条路线在所有维度上取胜——InfiniBand 领先于单跳延迟和单厂商调优,Spectrum-X 领先于单一商业平台下已验证的 GPU 数量,Ultra Ethernet 领先于长期的供应商可选性,但截至 2026 年 7 月它也是四条路中最不成熟的。
交换硅片:51.2T 到 102.4T 的一倍级跳跃
选型讨论经常被”IB 还是 Ethernet”占满,但真正驱动成本与功耗曲线的是交换硅片的代际。
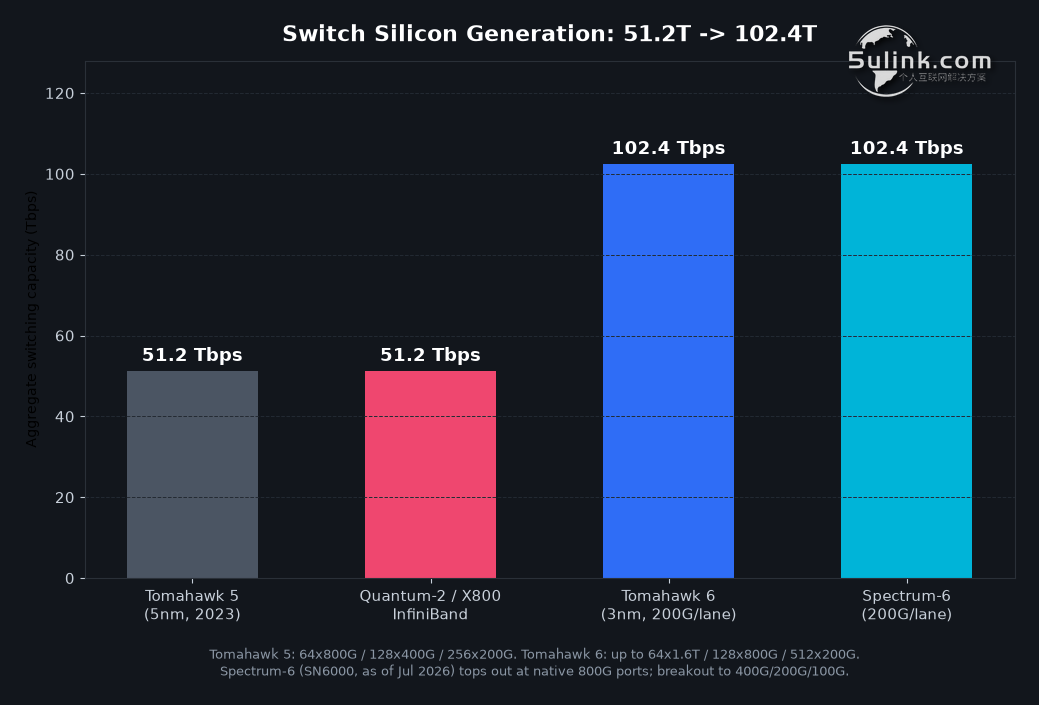
Tomahawk 5 是 Broadcom 首款 51.2 Tb/s 以太网交换芯片,采用 5nm 工艺在单片上跑满全部带宽,端口配置为 64×800GbE / 128×400GbE / 256×200Gbps,共享缓冲架构,面向 RoCEv2 提供最低尾延迟。Broadcom 称单颗 Tomahawk 5 可替代 48 台 Tomahawk 1 交换机,等效带宽下功耗降低超过 95%。
Tomahawk 6 把带宽翻倍到 102.4 Tbps,Broadcom 于 2026 年 3 月宣布标准版进入量产,官方列出的 I/O 采样配置为 64×1.6TbE / 128×800GbE / 256×400GbE / 512×200GbE / 1024×100GbE。Spectrum-6 同为 102.4 Tbps,200G/lane SerDes 进入系统,1.6T 与共封装光学(CPO)开始从路线图走向实际产品。
一个容易被忽略的细节:据 NADDOD 产品页(厂商口径),截至 2026 年 7 月,SN6000 系列的最高原生端口速率仍是 800GbE,支持 400G/200G/100G breakout;双口 OSFP 连接器承载的是两条独立 800G 链路,不是原生的 1.6TbE 端口。TH6 与 Spectrum-6 都不强制要求 CPO——CPO 是构建高密度 102.4T 交换系统的方式之一,不是达到该容量的前提。
市场数据:Ethernet 拿量,InfiniBand 拿价
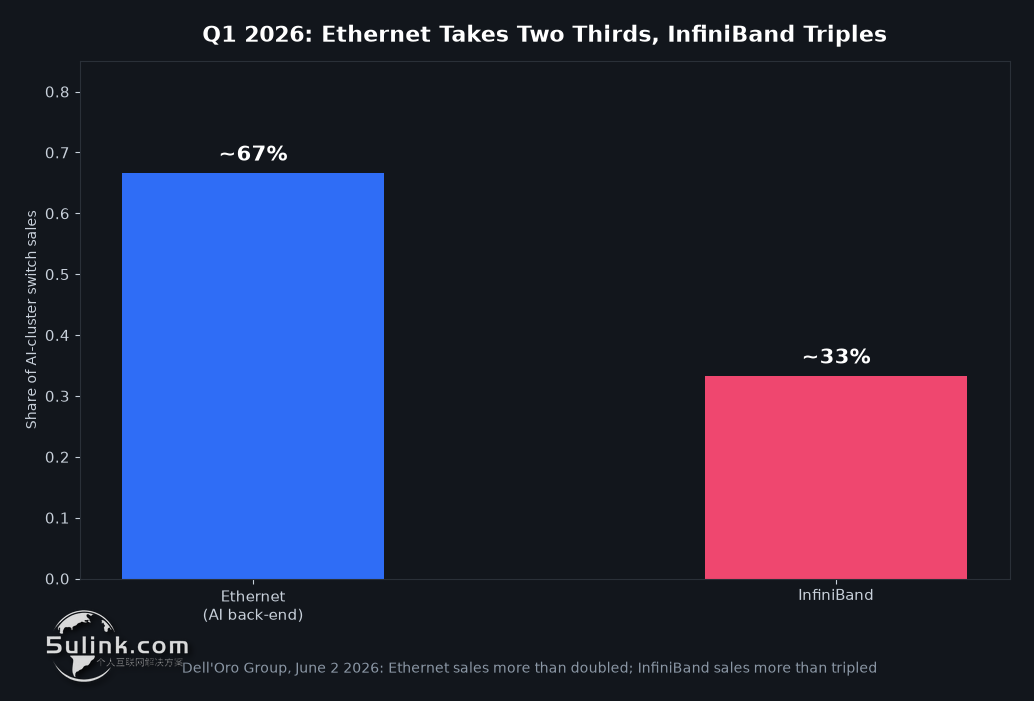
Dell’Oro Group 在 2026 年 6 月 2 日发布的季度快照给出了这一代最清晰的市场图景:AI 后端网络中的以太网交换机销售额翻了一倍以上,占 AI 集群数据中心交换机销量的约三分之二;与此同时,InfiniBand 销售额同期增长超过三倍,驱动力来自 NVIDIA Blackwell Ultra 平台配套的 800 Gb/s 交换机出货爬坡。
注意两个限定条件。其一,Dell’Oro 分析师提醒,InfiniBand 这波反弹可能相当一部分来自存量集群的升级而非新建扩张——这意味着不能单凭季度销售额推断未来的架构偏好。其二,供应商格局在同季度高度动荡:Celestica 重回以太网 AI 后端首位,NVIDIA 紧随其后,Arista 第三,思科份额增长最大、排名第四。800 Gb/s 交换机占据该季度以太网出货与收入的大多数,1600 Gb/s 交换机刚开始采样,预计 2026 年下半年爬坡。
往远了看,Dell’Oro 2026 年 2 月预测 AI 后端交换机支出到 2030 年将超过 1000 亿美元,且以太网将主导 scale-up 与 scale-out 两个细分市场——这与 2024 年 7 月那份”InfiniBand 当前主导”的判断相比,是一次彻底的翻转(当时预测五年 800 亿美元)。650 Group 的 2026 年 1 月预测同样给出 AI scale-out 以太网收入到 2030 年超 1000 亿美元,算上光模块则整个数据中心网络市场接近并可能超过 2000 亿美元/年。
真实部署:规模并不能预测选择
| 组织 / 部署 | 网络 | 规模 | 截至 2026 年 7 月状态 |
|---|---|---|---|
| Meta(Llama 3 训练集群) | 以太网 RoCE | 24,576 GPU | 2024 年起生产;Meta 另一个同规模集群用 NVIDIA Quantum-2 InfiniBand |
| xAI Colossus | NVIDIA Spectrum-X 以太网 | 10 万 – 20 万 GPU | 生产中,仍在扩容 |
| Oracle OCI Zettascale10 / Stargate(与 OpenAI) | Oracle Acceleron RoCE (RoCEv2) | 单次部署目标最高 80 万 GPU | 2025 年 10 月公布;Oracle 称架构正在 Stargate 部署,OCI 可用性原定 2026 下半年 |
| Microsoft Azure ND H100 v5 | NVIDIA Quantum-2 InfiniBand | 单部署数千 GPU,每 VM 3.2 Tbps 互连带宽 | 2023 年 8 月起正式可用 |
| Google TPU v4 | 自研光电路交换(既非 IB 也非以太网 RoCE) | 4,096 芯片 | 2020 年起生产 |
几个数字值得单独记:xAI Colossus 从破土动工到建成只用了 122 天,首个机架进场后 19 天即开始训练;xAI 官网现列出 20 万张 H100 在单一互联集群中,聚合内存带宽 170 PB/s,单服务器网络带宽 2.8 Tb/s。Oracle 的 Acceleron 架构宣称网络带宽性能高 5 倍、延迟低至多 5 倍,其 131,072 GPU 超集群报告 2 µs 延迟、52 Pbps 非阻塞带宽;新一代 Zettascale10 宣称 RDMA 吞吐最高 2.1 Eb/s、延迟低于 10 微秒——这些是 Oracle 面向竞品的自述,不是第三方审计,对比对象也未在同行评议语境下指明。
Microsoft Azure ND H100 v5 则是相反的例子:每张 GPU 在 VM 内拥有自己专属的、拓扑无关的 400 Gb/s NVIDIA Quantum-2 CX7 InfiniBand 连接,单 VM 互连带宽 3.2 Tbps,2023 年 8 月起 GA,截至 2026 年 4 月的文档更新仍是这条产品线的默认架构。
Meta 最有说服力的一点是它同时建了两个同规模的集群,一个用 RoCE 以太网、一个用 Quantum-2 InfiniBand,其 SIGCOMM 2024 论文是工程化 RoCEv2 能支撑前沿规模训练的重要公开证据——但它不能证明 Meta 两个集群都用 RoCE。
选型指标:钱、耐心与运维能力
成本上,网络其实是小头。 一份厂商测算把网络放在 AI 集群五年总拥有成本的约 5–8%。这意味着网络选型重要,但很少是整个集群里最大的成本项。(另一份来自以太网硬件厂商的测算认为 InfiniBand 相对开放硬件以太网的溢价通常在 +30% 到 +60%,这应读作利益相关方的估计而非审计数字。)
独立基准方面,WWT 的对照测试结论值得注意:在两台 8 路计算节点加单交换机的受控环境下,”在生成式测试与 OEM 上,InfiniBand 与以太网的性能差异统计上不显著(低于 0.03%)”,九项生成式测试中有三项以太网比 InfiniBand 的最好成绩还快,推理测试中以太网平均慢 1.0166%。但 WWT 明确说明更大网络带来的过订阅、争用与不完美负载均衡不在该测试范围内,因此不能据此断定生产规模下性能等同。WWT 的定位是:超高性能领域(可能占市场 3–5%)仍属于 InfiniBand,而当前绝大多数 InfiniBand 部署实际上都能由以太网承接。
真正该盯的选型指标有四条:
补充一条来自学术侧的正面证据:2025 年 11 月高通研究者的基准研究在生产集群上验证,RoCE 在正确配置下可实现接近线性的扩展性能,与 InfiniBand 相当,同时指出 InfiniBand”带来了显著的基础设施与运维成本”。
小夏点评
一、别再用”IB 还是 Ethernet”这个二选一来理解 2026 年的 AI 网络。 拆成”链路层 × 实现方”两层之后,图景立刻清晰:InfiniBand 是链路层选项,Ethernet 是另一个链路层选项,而 Spectrum-X 与 UEC/RoCE 是后者的不同实现路径。Meta 同时建 RoCE 集群和 InfiniBand 集群这个事实,比任何一份跑分都更能说明问题——用两条路线的团队,赌的是运维熟练度和供应商关系,而不是性能。
二、真正改变成本曲线的是硅片代际,不是协议之争。 一颗 Tomahawk 5 替代 48 颗 Tomahawk 1、等效带宽下省下 95% 功耗,这个数字比任何一份 IB 与 Ethernet 的跑分对比都更有实际影响。未来三年,AI 网络的电力与机架密度问题会更多由 102.4T 硅片与 CPO 解决,而不是由协议选择解决。在选型讨论里把硅片代际权重排得太低,是常见的分析错误。
三、给国内 IT 运维和开发者的启示:国产智算集群的网络选型,”以太网 + 调校”几乎是唯一可选项,但调校能力才是护城河。 三条具体建议:其一,优先把运维技能栈建在以太网侧——国内主流 GPU 集群的以太网生态、工具链、运维人才储备都远厚于 InfiniBand,而 WWT 的受控测试已经给出”低于 0.03% 差异”这个量级的参考;其二,RoCE 的调校不是配置项而是工程项,PFC-only 下的死锁规避、DCQCN 硬卸载、ECMP 路径数规划、共享缓冲与尾延迟预算,这四件事必须像 DBA 调索引一样有专人负责,抄一份配置模板就跑不出稳定集群,这是以太网路线最常见的翻车点;其三,别过早锁死单条路线——CoreWeave 的做法值得借鉴:维护 InfiniBand 与 RoCE 两套标签、用一套”fabric-agnostic schema”让调度与监控工具在两种 fabric 上行为一致,把 fabric 选择变成逐集群的采购决策而非公司级架构承诺,这在国内多代际硬件混跑(不同批次卡、不同代际交换机)的现实里几乎是刚需;其四,如果所在团队有能力参与 UEC 生态或使用已合规的 UEC 1.0 硬件(AMD Pollara/Vulcano、Broadcom Thor Ultra),这是降低单一供应商锁定风险的最短路径,但务必记住截至 2026 年 UEC 仍是四条路线中最不成熟的一条,SN6000 的最高原生端口速率目前也仍停在 800G。