
MLPerf Inference v6.0 与 v6.1 解读:GPT-OSS 120B 进场,Blackwell 与 MI355X 差距怎么算
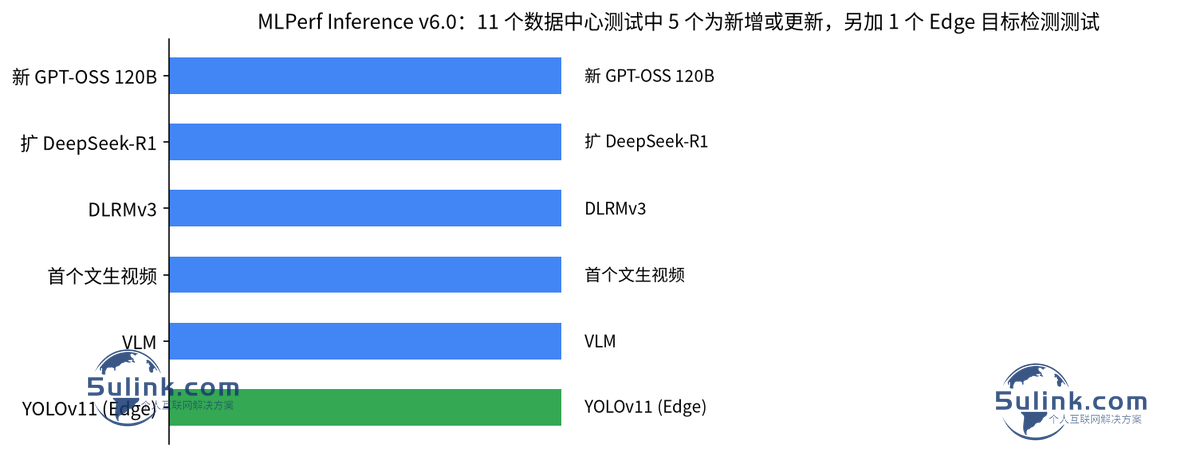
如果你在 2026 年要采购推理算力,摆在面前的榜单比两年前复杂了一个量级:MLPerf Inference v6.0 在 2026 年 4 月 1 日发布,一次性把 11 个数据中心测试里的 5 个换成新的或更新的,理由相当直接——旧基准已经跑不动区分度了。
这轮换血里最值得关注的不是某个 GPU 的分数,而是基准本身在往真实生产负载的方向长。而六个月后的 v6.1 更进一步,第一次把「端到端 RAG 管道」和「边缘 Agentic 推理」写进标准测试集,等于把整个行业的部署形态变成了可打分对象。
本文以 MLCommons 官方发布稿为主源,用 Spheron 的 per-GPU 折算解读做数据补充,所有第三方数字都会标明出处。
v6.0 到底改了什么:五个新基准各有各的用意
MLCommons 官方稿把这一轮称为「Inference 基准套件史上最大的一次修订」。共同主席 Frank Han(Dell Technologies)的说法是,成员贡献的工程量和 IP 是前所未有的。
| 基准 | 状态 | 测什么 | 为什么换 |
|---|---|---|---|
| GPT-OSS 120B | 新增 | 开放权重 MoE 大模型的文本生成吞吐 | 老的 GPT-J 6B 已被所有加速器跑满,失去区分度 |
| DeepSeek-R1 | 扩展 | 高级推理,新增支持投机解码的交互场景 | 推理型模型已成生产主流 |
| DLRMv3 | 第三代 | 推荐系统查询吞吐,首个顺序推荐测试 | Meta 提供大量工程贡献,贴近真实特征规模 |
| 文生视频 | 首个 | 视频生成吞吐(模型由 Spheron 标为 WAN-2.2,官方未公布模型名) | GPU 云已大量承接 AI 视频生产 |
| VLM | 新增 | 视觉语言模型端到端吞吐 | 数据来自 Shopify 商品目录的多模态结构化 |
| YOLOv11 Large | Edge 新增 | 边缘场景单发目标检测 | Ultralytics 参与,反映边缘与云侧检测器现状 |
其中最耐嚼的是 GPT-OSS 120B 这个替换决策。它是一个 117B 总参数、每 token 激活 5.1B 的 MoE 模型——按直觉,激活参数这么少,推理应该很轻。但实际约束在于全部 117B 参数都必须装进显存,显存容量门槛依然很高;同时 MoE 路由带来的访存模式与稠密模型完全不同,这正是硬件差异还能显形的原因。
用 Spheron 的解读来对照硬件门槛:VLM 任务用的是 Qwen3-VL-235B-A22B-Instruct(235B 总参数、22B 激活),按 FP8 计算仅权重就要约 235 GB,已经超过 H200 的 141 GB 显存;FP16 下更要到约 470 GB。H100 的 80 GB 和 H200 的 141 GB 都装不下,单卡不可行——多卡 H200/B200 或 GB200 NVL72 这类带显存池化的节点才是实际选项。
B200、MI355X 与 H200:闭源组数字怎么读
采购决策上真正要看的是闭源组(closed division)——模型权重、精度、前后处理全部固定,跨厂商数字可直接比较;开源组允许自定义 kernel 和非标准量化,数字好看但不是你能直接拿到的东西。
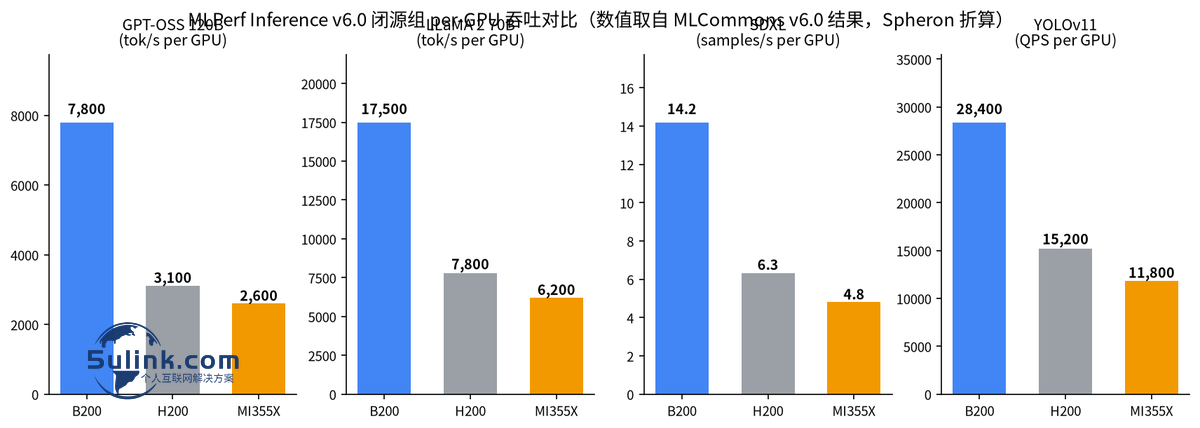
Spheron 把 MLCommons 的系统级成绩按加速器数量折算成了单卡数字,这是第三方解读而非官方口径,读的时候要留个心眼:
| GPU | GPT-OSS 120B(tok/s/卡) | LLaMA 2 70B(tok/s/卡) | SDXL(samples/s/卡) | YOLOv11(QPS/卡) |
|---|---|---|---|---|
| NVIDIA B200(GB200 NVL72) | 约 7,800 | 约 17,500 | 约 14.2 | 约 28,400 |
| NVIDIA H200 SXM | 约 3,100 | 约 7,800 | 约 6.3 | 约 15,200 |
| AMD MI355X | 约 2,600 | 约 6,200 | 约 4.8* | 约 11,800* |
\* MI355X 的 SDXL 与 YOLOv11 数字来自开源组(含 ROCm 优化),与闭源组不可直接横向比较;MI355X 在闭源组的提交覆盖 LLaMA 2 70B 与 GPT-OSS 120B。
这张表里有两个容易被误读的地方。
第一,B200 领先 GPT-OSS 120B 的幅度大致是 H200 的 2.5 倍,主因是带宽而非算力。 B200 支持 FP4 精度、HBM3e 带宽 8.0 TB/s,而 H200 是 4.8 TB/s。大模型推理在模型装得进显存的前提下是显存带宽瓶颈,显存带宽翻倍,吞吐大致也翻倍。NVLink 5 的 1.8 TB/s 双向带宽则让 120B 模型跨卡切分时不吃互联的亏。
第二,MI355X 的位置比「落后一代」这种说法更靠前。 闭源组里它与 H200 的差距在 20% 以内——这还是在 H200 的强项(带宽)上打的。而且 MI355X 的 288 GB HBM3e 大于 B200 单卡的 180 GB(Spheron 按单卡口径写 192 GB(GB200 版本),与 B200 SXM 单卡 180 GB 规格不同),当模型体积接近显存上限时,AMD 能塞进更大的 batch,差距会进一步收窄。
关于 Intel:这一轮没有 Gaudi 3
这是本次解读里最容易被写错的一条。Intel 在 MLPerf Inference v6.0 的官方提交只覆盖 Xeon 6 CPU 与 Arc Pro B 系列 GPU,没有 Gaudi 3 加速器的成绩。 因此在闭源组 per-GPU 对比表里,Intel 没有可填的 Gaudi 3 行——不是「Intel 输了」,而是官方数据集里根本没有这一格。Spheron 的解读中同样明确写了这一点,并说明若后续轮次出现 Gaudi 3 结果会更新表格。
到了 v6.1,Intel 的出现方式是 Intel Arc Pro B70 作为新加速器之一(与 AMD Ryzen AI Max+ 395、AMD Instinct MI350P 并列,均为「已上市」状态),NVIDIA Rubin 与 Vera Rubin NVL72 则处于「预览」状态。WAN-2.2 文生视频任务在 v6.0 首轮由 NVIDIA 与 AMD(MI355X) 提交,Intel 当时尚未提交。
多节点提交暴涨 30%:市场在买「整机」而不是「单卡」
v6.0 有一组数据比单卡分数更能说明产业状态:
- – 多节点系统提交量创历史新高,比六个月前的 v5.1 增长 30%;
- – 全部提交系统中,节点数超过 10 个的占 10%,而上一轮只有 2%;
- – 最大提交系统为 72 个节点、288 个加速器,节点数是上一轮最大系统的 4 倍。
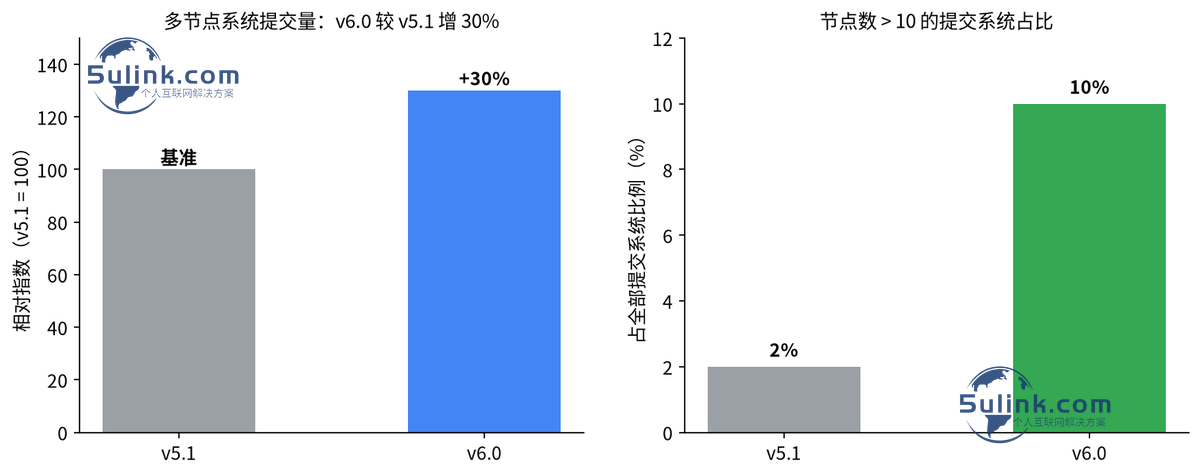
AMD 共同主席 Miro Hodak 的说法是,多节点带来的不只是单节点之外的系统工程挑战——系统架构配置、网络互连、数据存储、软件层都要一起优化。翻译成采购语言:2026 年的推理招标单上,「一台带 8 卡的主机」正在变成「一套经过整机调优的机柜」,两者的验收方式完全不同。
v6.1:把 RAG 管道和 Agent 循环写进标准
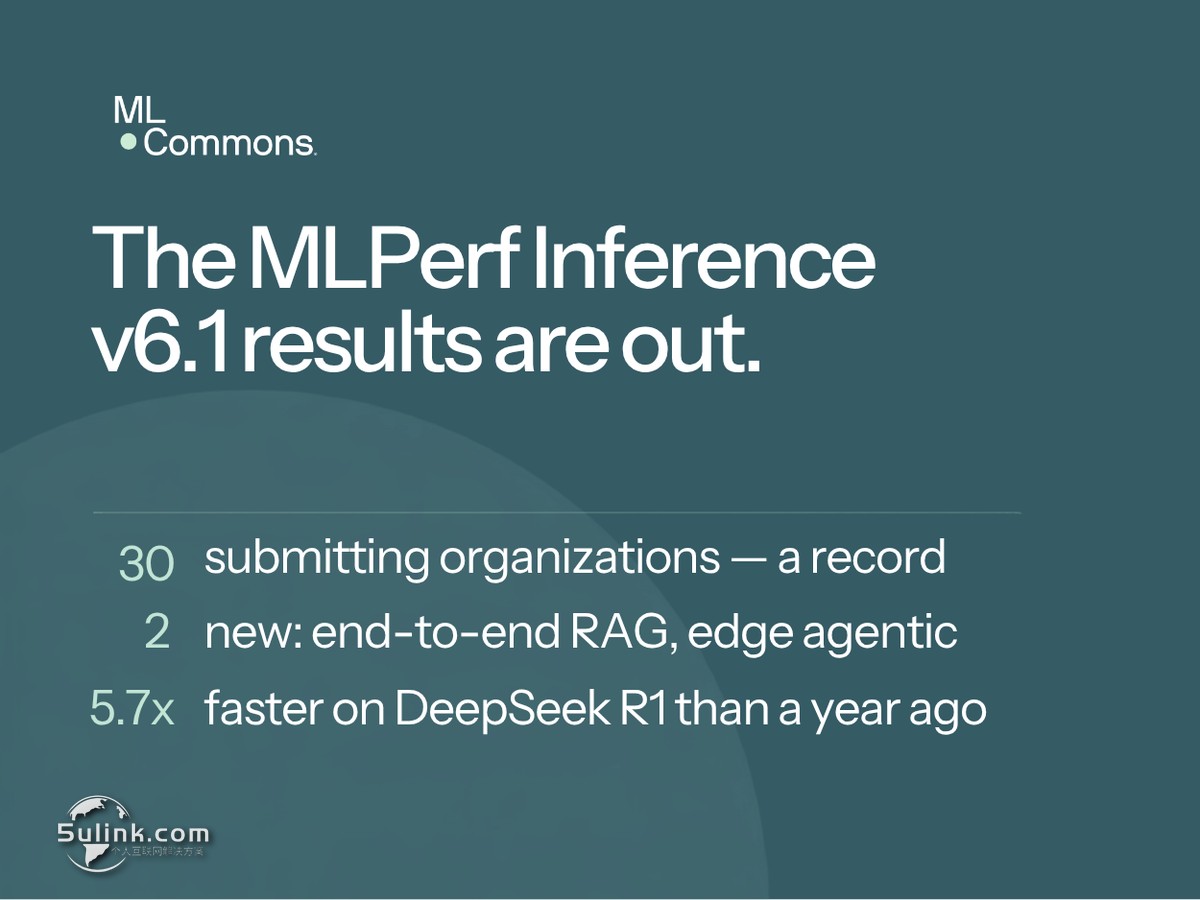
v6.1 于 2026 年 9 月 16 日发布,官方称之为「参与机构数创纪录」的一轮——30 家机构提交(v6.0 是 24 家),其中 6 家首次参与:Atlas Inference、Crusoe、Orrick Industries、ScitiX、VibeHPC 以及个人贡献者 Naeem Khoshnevis。
两项新测试是这一轮的核心:
端到端 RAG 基准。 它把一条完整的多模型管道拆成序列:嵌入模型把查询转成向量 → 检索器从向量库拉候选段落 → 重排序器精修列表 → 一个或多个 LLM 在数据上推理生成答案。测试分成两个任务:把文档语料摄取成向量库,以及在已建好的向量库上做查询问答。这是 MLPerf 第一次承认「RAG 不是一个检索步骤,而是一串组件」。
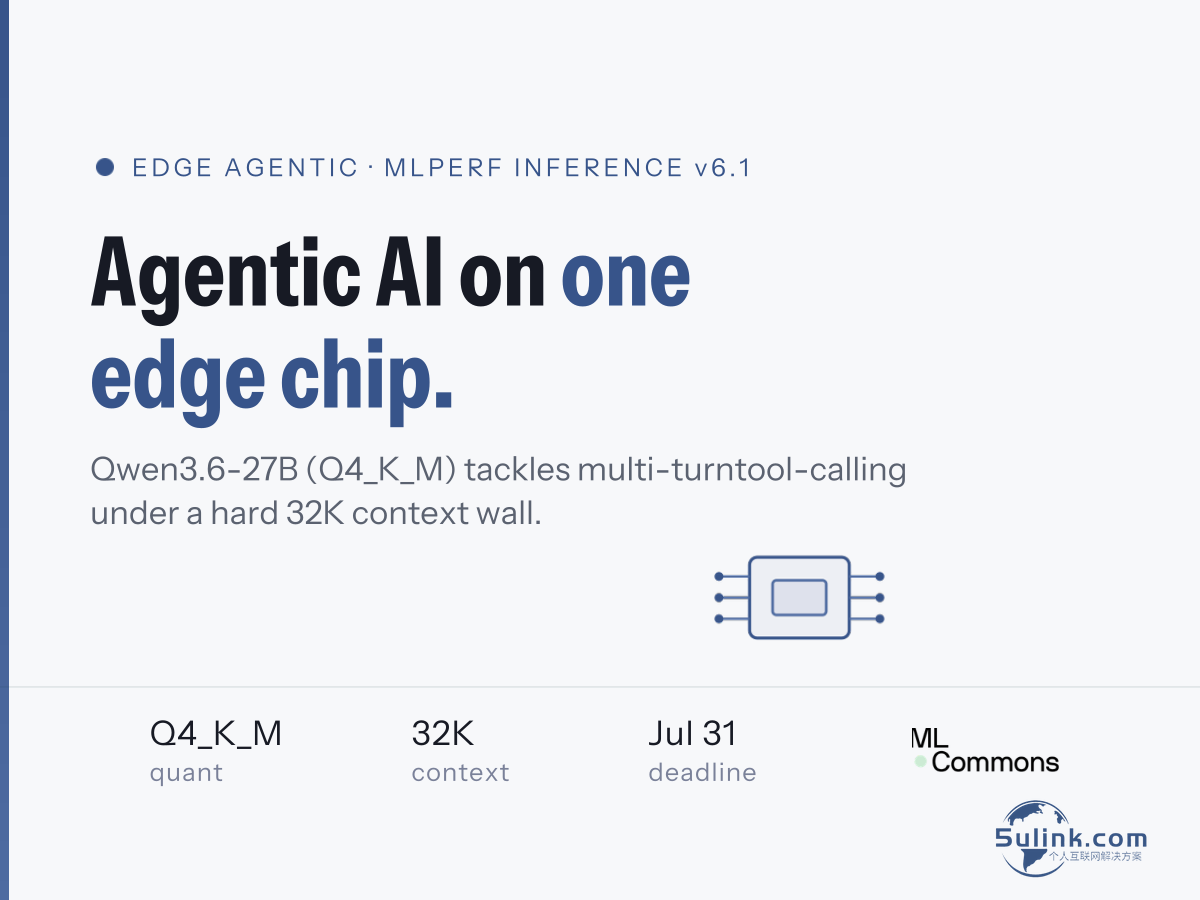
边缘 Agentic 推理基准。 它反映从单发交互向复杂多轮负载的迁移——对话历史不断增长,每次查询依赖前序查询,模型把证据收集与后续推理合并,必要时迭代。官方描述里特别点出:Agentic 部署越来越适合在边缘,因为一次服务一个用户、内存/算力/功耗/上下文都固定,形成了独特的性能挑战。这个基准采用即将发布的 MLPerf Agentic 数据中心基准的框架与方法论,再用边缘模型与量化、单流编码负载、延迟指标和统计上可靠的精度门槛做特化,包含两个任务:时间约束下的负载精度测量,以及精度内生于负载的确定性工作负载性能测量。
v6.1 还把投机解码(Speculative Decoding)纳入了两个推理基准的交互场景,并新增了 GPT-OSS 任务的支持——这意味着「一次前向预测并校验多个 token」这个生产环境里的常规优化,终于有了官方可比的成绩。
成绩涨得有多快:一个容易被忽略的对照
官方公布的两组倍数,是这一轮里最有冲击力的数据:
- – VLM 任务本轮单加速器 Server 场景最佳成绩,比六个月前的 v6.0 提升 2.99 倍;
- – DeepSeek-R1 任务单加速器 Server 场景最佳成绩,比一年前的 v5.1 提升 5.7 倍。
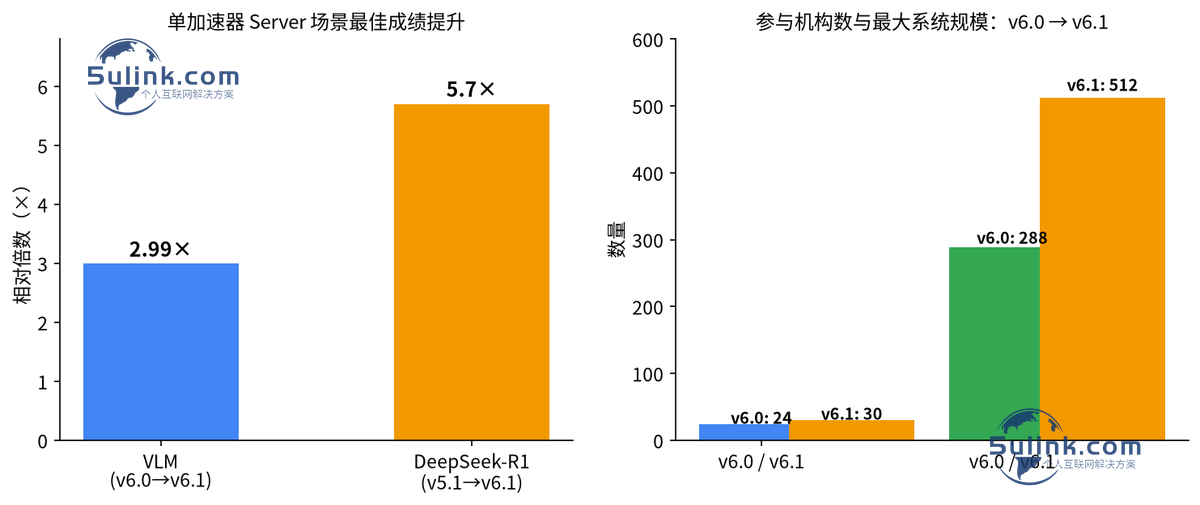
v6.1 还包含了史上最大的提交系统:512 个加速器,以及两个新型异构系统——第一个把高性能网络与两家不同厂商的加速器组合在一起,第二个则是跨太平洋的地理分布式系统。「不同厂商加速器混跑」能进入基准榜单本身,就说明开放加速器生态已经从论文进入了可提交的工程现实。
此外,超过 50% 的提交方使用了 MLCommons 新的 API-centric harness——用真正的 client/server 架构通过行业标准 API 与被测系统通信。官方明确表示,MLPerf Endpoints 将取代 Inference 成为数据中心的基准,这个过渡的平滑程度就取决于这套新 harness 的采用率。
成本视角:把吞吐换算成每百万 token 的价格
只比吞吐没有意义,得除以价格。Spheron 用 2026 年 4 月 11 日的费率做了换算(按 ($/hr) ÷ (tok/s/卡) × (1,000,000 ÷ 3,600)):
| 配置 | GPT-OSS 120B tok/s/卡 | 费率(4/11 快照) | 每百万 token 成本 |
|---|---|---|---|
| B200 SXM6 | 约 7,800 | 竞价 $2.06/时 | 约 $0.073 |
| H200 SXM5 | 约 3,100 | 竞价 $1.19/时 | 约 $0.107 |
| H200 SXM5 | 约 3,100 | 按需 $4.50/时 | 约 $0.403 |
| GH200 PCIe | 约 3,100 | 按需 $1.97/时 | 约 $0.177 |
| H100 PCIe | 约 1,300(估算) | 按需 $2.11/时 | 约 $0.451 |
这里要标注清楚:这是单一供应商的费率快照,不是行业公允价;H100 那一行的 1,300 tok/s 是按带宽比(约 2.0 TB/s vs 4.8 TB/s,即 H200 的 42%)估算的,不是实测提交值;费率本身也随 GPU 供给波动。方法本身是通用的——把这个换算公式套进你自己手上的报价单,比看任何榜单都有用。
小夏点评
一、v6.0 真正的信号不是分数,是「旧基准被淘汰」这件事本身。 GPT-J 6B 被所有加速器跑满、失去区分度,于是 GPT-OSS 120B 上位——这是一个行业从「模型能跑就行」走向「模型必须按真实部署形态打分」的转折点。对国内做智算采购的团队来说,这意味着你现在手上那份两年前的 MLPerf 榜单,在 LLM 推理选型上基本已经没有参考价值了:它测的量级和精度约束,跟现在实际跑的 100B+ MoE 服务不是一回事。
二、AMD MI355X 与 Intel Gaudi 3 这两条线,媒体上的说法普遍比事实更粗糙。 闭源组里 MI355X 与 H200 差距在 20% 以内,而且 288 GB 单卡显存大于 B200 单卡的 180 GB——这不是「落后一代」的描述能概括的。反过来,Intel 在 v6.0 官方提交里根本没有 Gaudi 3,只有 Xeon 6 和 Arc Pro B 系列,任何把 Gaudi 3 拉进这张表比较的文章都是错的。给采购方的实操建议是:只信闭源组、只认官方数据集里真实存在的行,第三方的 per-GPU 折算可以看,但要记住它是自己做的除法,不是 MLCommons 的原表。
三、给国内 IT 运维与开发者的启示:v6.1 引入 RAG 与 Agentic 基准这件事,比任何单卡跑分都更值得跟进,因为它定义的是接下来两年的验收方式。 三条具体建议:其一,现在开始用 v6.1 的口径重写自己的验收标准——端到端 RAG 基准把「检索 + 重排 + 生成」拆成了独立可测量的环节,这意味着一个 RAG 系统的性能瓶颈第一次可以被分环节定位与优化,而不是笼统地归给「模型慢」;其二,多节点占比从 2% 跳到 10%、最大系统到 512 加速器,说明整机交付能力正在变成硬门槛,如果你手上的推理集群还是单台 8 卡机器拼出来的,那么在下一轮招标里大概率过不了整机调优这一关——跨厂商加速器混跑已经进入官方榜单,互联与调度栈的工程能力必须提前建;其三,别用 v6.0 的单卡榜单去谈 2027 年的算力合同。VLM 任务六个月涨 2.99 倍、DeepSeek-R1 一年涨 5.7 倍,这个斜率意味着你现在基于某一代硬件做的 TCO 推演,保守估计在两年内就会失效;更务实的做法是把「单卡吞吐 × 单价 ÷ 显存占用」这套换算固化成你自己的表格,每次 MLPerf 发新版就重算一遍——这张表比任何榜单都更接近你真实的采购决策。
参考链接
- – 主源:MLCommons《MLCommons Releases New MLPerf Inference v6.0 Benchmark Results》(2026-04-01,官方发布稿)https://mlcommons.org/2026/04/mlperf-inference-v6-0-results/
- – 主源:MLCommons《MLCommons Sets Participation Record with New MLPerf Inference v6.1 Benchmark Results》(2026-09-16,官方发布稿)https://mlcommons.org/2026/09/mlperf-inference-v6-1-results/
- – 数据解读:Spheron《MLPerf Inference v6.0 Results Explained》(2026-04-11 发布,2026-10-19 更新;per-GPU 折算与费率换算来源)https://www.spheron.network/blog/mlperf-inference-v6-benchmark-results-2026
- – MLCommons: Where the Industry Is Investing – MLPerf Inference v6.1(配图出处:wp-content/uploads/2026/09/chairblog.png)https://mlcommons.org/2026/09/chairs-mlperf-inference-v6-1
- – 官方结果看板:https://mlcommons.org/visualizer
- – MLCommons 基准套件文档:https://mlcommons.org/benchmarks/