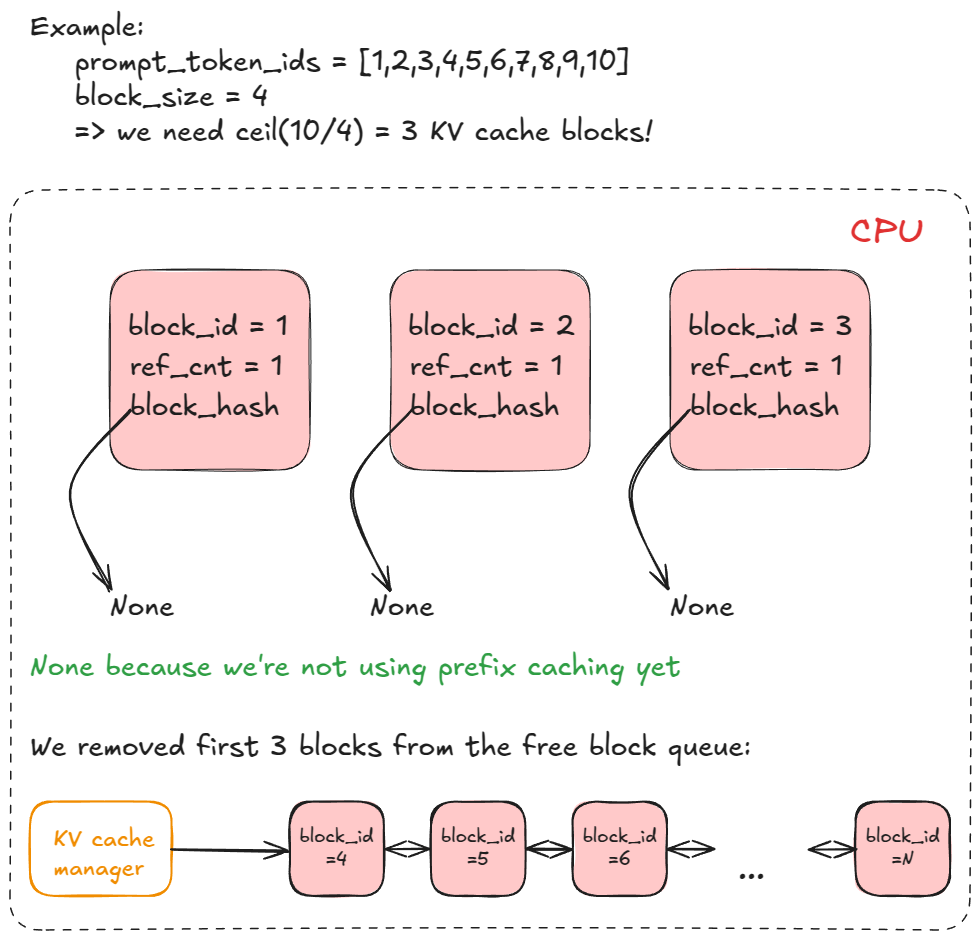
PagedAttention 深度解析:vLLM 连续批处理与显存分页的工程奇迹
vLLM 凭什么一张 24GB 显卡顶住 30+ 路并发?靠 PagedAttention 把 OS 虚拟内存思想搬进 GPU,KV cache 从连续大块变可分散小块;连续批处理把 GPU 利用率从 30% 拉到 80%+。本文扒 vLLM 官方博客 + SOSP 论文讲清双引擎原理 + 实测性能。

Share Life
vLLM 凭什么一张 24GB 显卡顶住 30+ 路并发?靠 PagedAttention 把 OS 虚拟内存思想搬进 GPU,KV cache 从连续大块变可分散小块;连续批处理把 GPU 利用率从 30% 拉到 80%+。本文扒 vLLM 官方博客 + SOSP 论文讲清双引擎原理 + 实测性能。
狗云服务器优惠