pgvector 对决专业向量数据库:5000 万向量下的生产级实测
一个没有数据的世界
一个团队在周二下午给现有 Postgres 装了 pgvector,embedding 和关系数据同表存放,一条 SQL 同时完成过滤和相似度检索。六个月后,一封厂商邮件落到收件箱,坚持让他们在”撞墙”之前迁移到”真正的”向量数据库。两边都没有附带基准数据,只有信心。这个缺口——强观点、没有数字——就是这篇文章要填的。
两边的定义
pgvector 是开源 Postgres 扩展(当前 0.8.6,支持 Postgres 13+),给 Postgres 加了原生 vector 列类型和精确/近似最近邻检索。实践含义:embedding 和它所描述的记录在同一张表、同一行,用你已经会的 SQL 查询。没有独立服务、没有第二套系统要同步、关系数据和向量数据之间没有网络跳转。支持单精度/半精度/二进制/稀疏向量,五种距离函数(L2、内积、余弦、L1、Hamming)。
专业向量数据库 是独立部署、独立进程、独立存储引擎的服务,从零围绕向量检索设计——意味着新的部署、监控、备份和同步负担。最常见的五个:Pinecone(全托管零运维)、Qdrant(Rust 高性能、复杂 JSON payload 过滤)、Weaviate(AI 原生、内置向量化与 BM25 混合检索)、Milvus(分布式、GPU 加速、十亿级)、ChromaDB(轻量嵌入式、本地原型)。
笔记本上的动手基准(完整可复现)
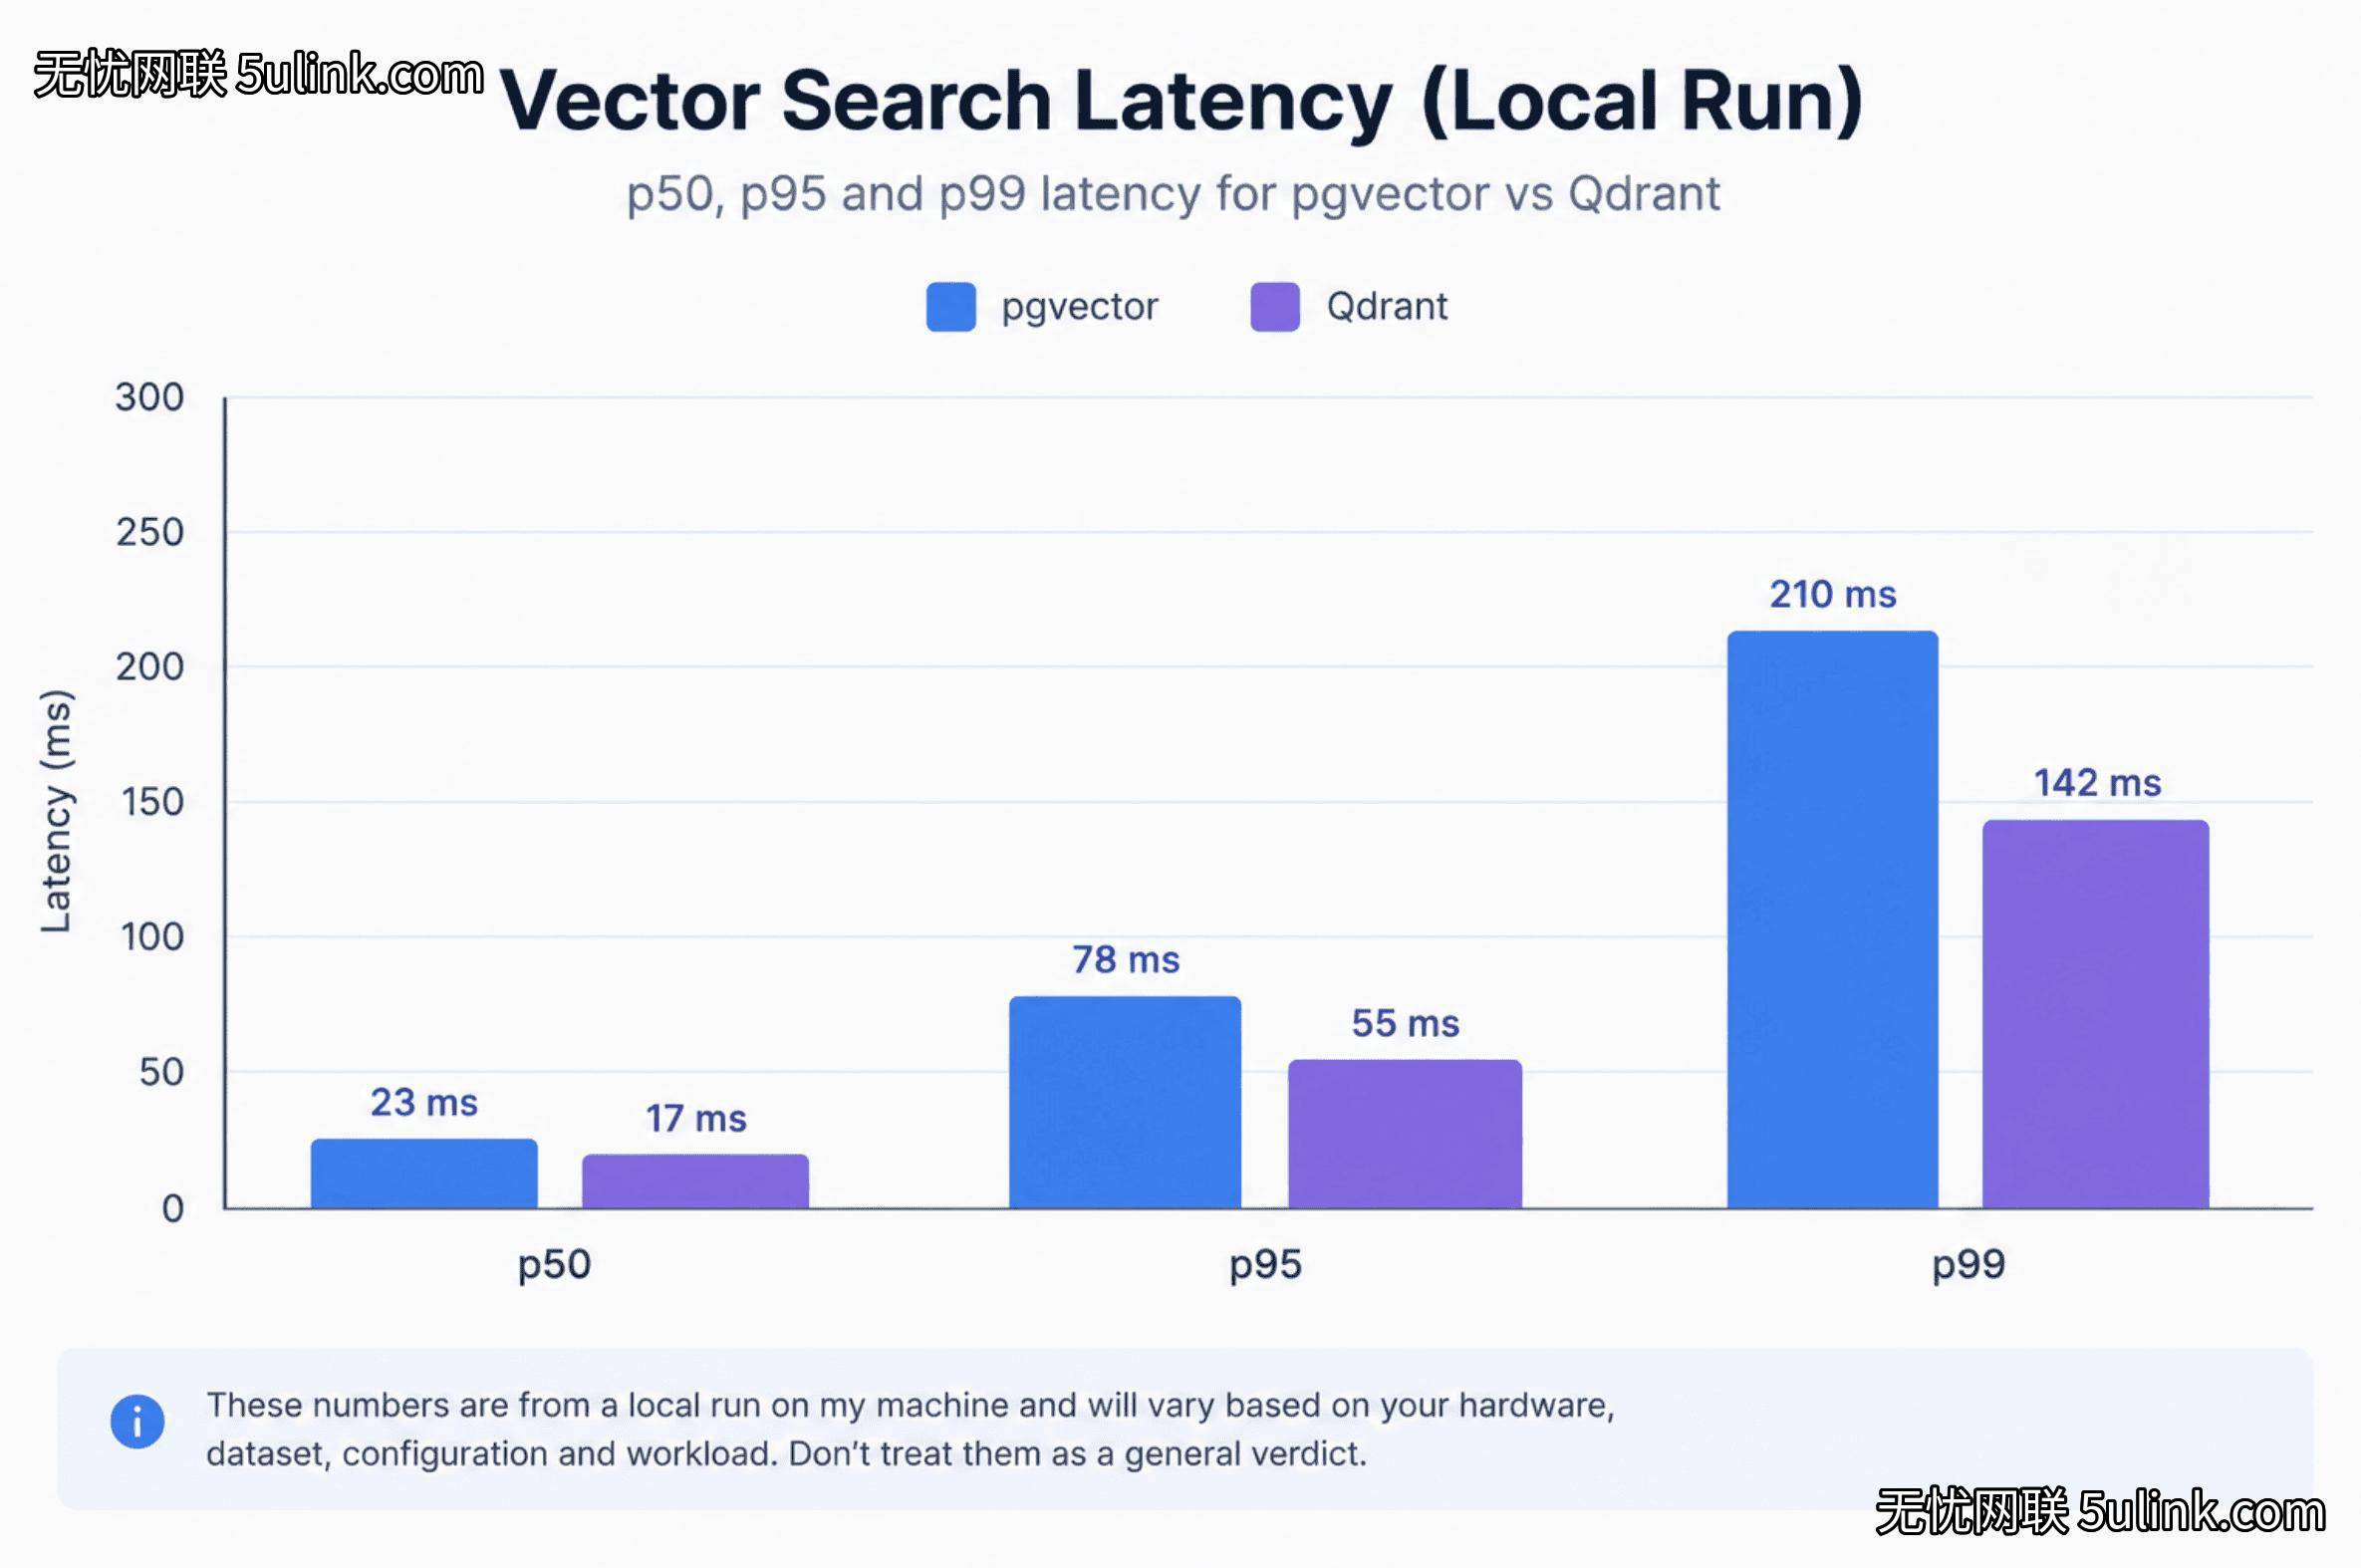
全文给出了在自己机器上跑通两边对比的完整代码:Docker 起 pgvector/pgvector:pg17 和 qdrant/qdrant,生成 10 万条归一化的 1536 维随机向量(seed 42,模拟 OpenAI text-embedding-3-small 维度),两边用完全相同的 HNSW 参数(m=16, ef_construction=64——pgvector 自己的默认值,刻意在 Qdrant 侧对齐),用 200 条全新查询向量测 p50/p95/p99 和 QPS。
原文点破了关键:参数不对齐的对比不是基准,是两场各测各的展览。笔记本结果双方都在个位数到几十毫秒级——10 万向量这个规模太小,得不出生产结论,双方都快到差异不重要。真正的要问的是:数据和查询负载真的长大时,谁扛得住。
生产规模的数据:Tiger Data 公开基准
这是目前最详细、方法论最透明的公开对比:5000 万条真实 Cohere embedding(768 维),双方跑在对等的 AWS r6id.4xlarge(16 vCPU / 128GB RAM)上,用改造过的行业标准 ANN-Benchmarks 工具。
一个重要的精度说明:这个基准用的是 Postgres + pgvector 加 pgvectorscale——Timescale 自己的扩展,提供另一种叫 StreamingDiskANN 的索引,不是裸 pgvector。很多二手转述把这个区别模糊掉了,它很重要,下面的数字反映的是这个组合。
| 指标 | pgvector + pgvectorscale | Qdrant |
|---|---|---|
| p50 延迟 @ 99% recall | 31.07 ms | 30.75 ms |
| p95 延迟 @ 99% recall | 60.42 ms | 36.73 ms |
| p99 延迟 @ 99% recall | 74.60 ms | 38.71 ms |
| 吞吐 @ 99% recall | 471.57 QPS | 41.47 QPS |
| p50 延迟 @ 90% recall | 9.54 ms | 4.74 ms |
| 吞吐 @ 90% recall | 1,589.79 QPS | 360.81 QPS |
| 索引构建(5000 万向量) | 11.1 小时 | 3.3 小时 |
模式是真实的双边,不是任何一方的干净胜利:99% recall 下 Postgres 组合给出 11.4 倍吞吐;Qdrant 的尾延迟优势同样真实可测,p99 好 48%,最慢的查询明显更快;索引构建快 3.4 倍。而双方所有百分位都压在 100ms 以内——这本身就值得咀嚼,它直接动摇了”通用数据库扛不住真实规模”的假设。
什么时候 pgvector 够用
- 规模在 500-1000 万向量以下,合理硬件上完全在射程内;
- 需要关系数据与 embedding 的事务一致性(文档和它的向量在同一个原子事务里更新)——这是独立数据库给不了的结构性优势;
- 团队已经会运维 Postgres(监控、备份都会),加向量检索的成本是一个扩展加一个索引,不是一套新系统;
- 中等查询并发,而不是每秒数千并发查询。
什么时候该上专业向量库
另一侧同样具体:
- 亿到十亿级规模,才是分布式专用架构挣回运维成本的区间;
- 重并发过滤检索下有硬性尾延迟 SLA(p99 超过 25-40ms 就是真问题)——这正是 Qdrant 展示过的优势;
- GPU 加速索引需求指向 Milvus(名单里唯一从底层围绕 GPU 设计的);
- 组织就是想要零运维托管——团队没有数据库专家、不想调任何东西——这正是 Pinecone 存在的意义。
结论
这份数据不支持两种流行的简单故事——”pgvector 永远够用”和”专业库永远赢”。它展示的是两个在同等透明条件下测出的、真实不同的取舍:一个在吞吐上决定性获胜,另一个在尾延迟上决定性获胜,而双方都轻松越过大多数真实应用的及格线。”该用哪个”从来不该是一个名字,而是你的真实工作负载(不是厂商的推销)站在取舍的哪一边。
小夏点评
- 11 倍吞吐和 48% 尾延迟同时存在,说明这场对决的正确答案取决于负载形状:高并发读选 Postgres 组合,硬 SLA 的过滤检索选 Qdrant,两边都别听厂商的信仰宣言。
- pgvectorscale 这个脚注是全文最重要的一行:引用基准时把”pgvector+扩展”说成”pgvector”,会让结论在裸 pgvector 用户手里失效——看任何 benchmark 文章,先查它测的到底是什么组合。
- 给国内团队的启示:国内 Postgres(含国产发行版)存量远大于专业向量库,”先扩展、后独立”的路线几乎零迁移成本——500 万向量以下直接把 pgvector 当默认答案,把迁库的预算留给真正的亿级场景。
参考链接
- 原文:pgvector vs. Dedicated Vector Databases: A Production Benchmark(2026-10-20,作者 Shittu Olumide)
- pgvector 仓库:github.com/pgvector/pgvector
- Tiger Data 基准方法论:Tiger Data 博客
- ANN-Benchmarks 工具:github.com/erikbern/ann-benchmarks