2分钟和6.7小时建完:六款数据库的向量检索分水岭在并发
Percona 实验室把 99 万条 1,536 维 OpenAI 官方 embedding 灌进六款”自己会建向量索引”的数据库(MariaDB 11.8 / MariaDB 12.3 / AliSQL / pgvector / Valkey / Percona Search for MongoDB),每台建 HNSW 索引,同机同容器规格测五件事:建库时间、存储占用、召回-吞吐曲线、并发吞吐、10% 语料重写后的衰减。同一台机器、同一跑法,全部数据开源在 github.com/Percona-Lab/vector-bench。
建库:最窄差 2 分钟,最宽 6.7 小时
| 指标 | 组内范围 | 细节 |
|---|---|---|
| 到可查询索引时间 | **1.9 分钟 → 6.7 小时** | 换 embedding 模型:pgvector 一下午,AliSQL 一个周末 |
| 索引体积 | **3.9 GiB → 15.1 GiB** | 索引最小的那台(MariaDB 11.8 / 12.3 / AliSQL 并列 3.9 GiB)反而建得最久——跑满 6.7 小时的是 AliSQL |
| 灌数据速度 | 41 行/秒 → **69,018 行/秒** | 逐行改图形的 MHNSW/VIDX 最慢(41-76 行/秒);批量入库的 Percona Search 最快,Valkey 30,170 行/秒居第二 |
| 表+索引合计 | MariaDB 14.3 GiB / Percona Search **5.8 GiB** | 同一批向量差 2.5 倍 |
并发:这张表最该细看
单客户端时大家差距不大,32 客户端时队形散了:pgvector 交回单客户端 21.7 倍 的吞吐,结论节给出的判据是 4,798 QPS、p99 10.8 ms,比 MySQL 家族高一个数量级。而三个 InnoDB 系引擎停在约 1 倍——吞吐不涨、中位延迟涨 20 倍(MariaDB 11.8 从 4.6ms 到 97ms,AliSQL 5.1ms 到 133ms),这就是服务端排队的形状。
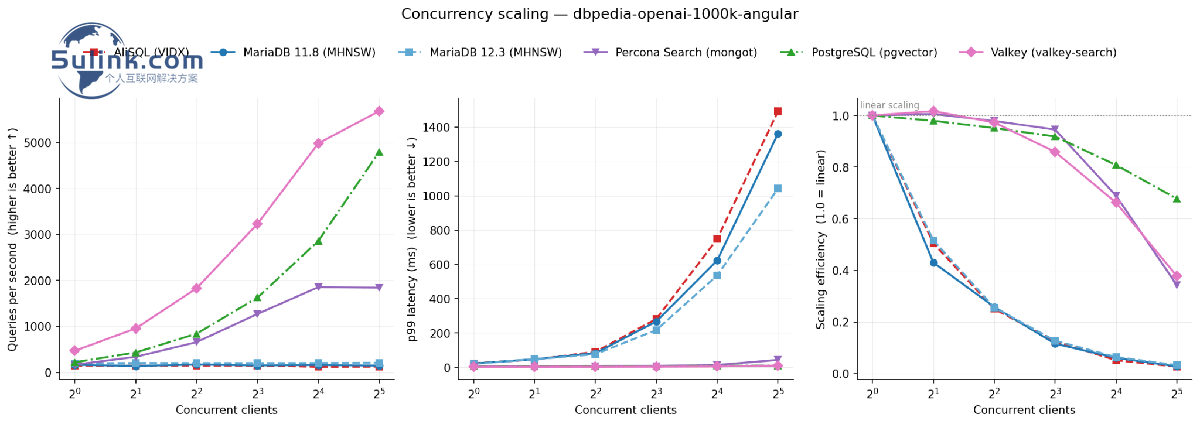
原文的诚实值得单独说:并发表里有 2 个被明确标记撤销 的数据点,另有 6 个(36 个格里)被 harness 拒绝换算——Python 线程共享解释器锁,MariaDB 连接器在 socket 等待时持锁,部分”客户端”其实在等锁而不是等数据库。作者按 Little’s law 复核”在服务中的查询数”后拒绝换算。但作者强调:撤销不影响结论,队列是服务端实打实的。
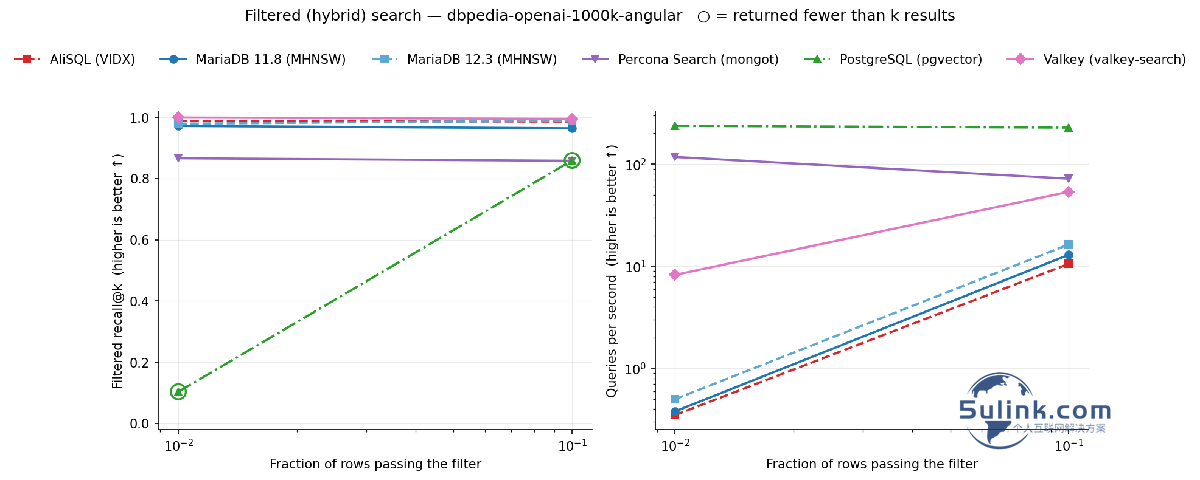
带过滤的检索:三家三种活法
| 引擎策略 | 10% 选择性 | 1% 选择性 | 表现 |
|---|---|---|---|
| pgvector:过滤后停 | — | 召回 **0.1034**(默认配置) | 只要 10 条时真返回一两条,不报错、全速跑 |
| MariaDB/AliSQL:过滤后继续搜 | 召回 >0.97 | 吞吐 <1 QPS,p99 **10-13 秒** | 准,但慢到不可用 |
| Percona Search:先过滤再搜 | **71.9 QPS** | **117.5 QPS** | 唯一越过滤越快的引擎 |
| Valkey:逐查询规划 | — | 唯一”又准又能用”的 | — |
pgvector 的 0.1034 是默认配置的代价——0.8 版有 iterative scan 专门治这个,但本次没测。原文一句话很扎心:这个默认值就是”没人知道要改”时应用拿到的东西。
语料重写 10% 之后
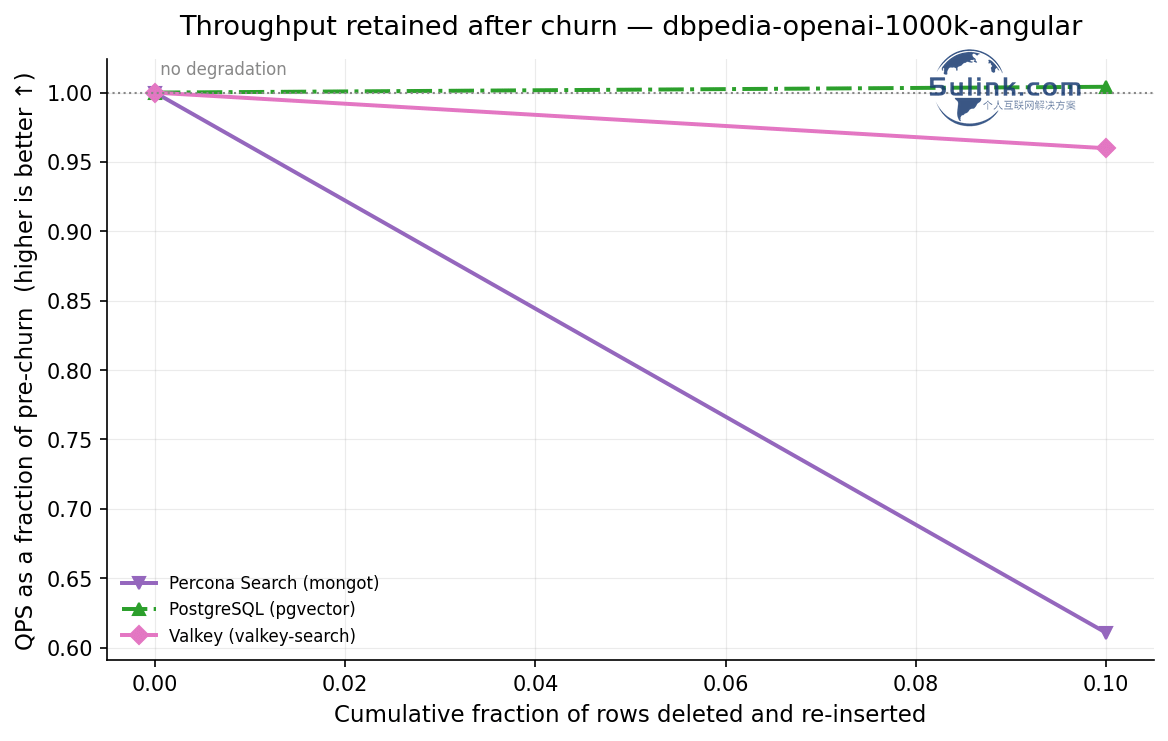
删除 99,000 行再原样插回,重新测索引:往已建成的图里重写,成本是初次建库的 2-3 倍(重插 16-28 行/秒 vs 首灌 41-76)。Percona Search 吞吐掉了 39.2%(全场最大跌幅,召回几乎不动);pgvector 持平,因为跑了 VACUUM ANALYZE——它是全场唯一提供维护钩子的引擎。
原文的选择建议(附边界)
并发流量选 pgvector(记得先开 iterative scan);工作集放得进内存且过滤要又快又准选 Valkey(官方建议先测其索引写入路径);索引要小、流量不大选 MariaDB 12.3(召回 0.99 全场最快 277 QPS);过滤是常态且能接受技术预览版选 Percona Search。边界:单机、单语料、单跑次,最可能变动的是三个缺失的重写数据和六个被撤销的并发点。