Sprig 实测:一个 ScyllaDB 换掉 Postgres+ClickHouse+Redis,读延迟快 4-8 倍
主角:一家小公司扛住了多大的量
Sprig 做产品内调研(在用户完成关键动作时弹出问卷),团队不大,但数据量是实打实的平台级:
| 指标 | 规模 |
|---|---|
| 追踪的独立访客 | **150 亿**(跨多设备) |
| 属性(attributes) | **750 亿** |
| 事件计数器 | **200 亿** |
| 累计处理事件 | **1.3 万亿** |
| 实时处理速率 | **每秒 2 万–4 万** 事件与属性 |
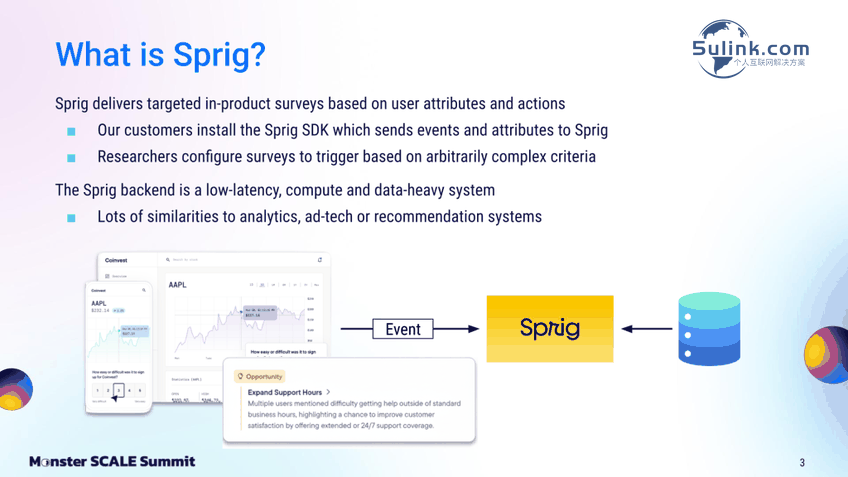
问题在于,每一次 SDK 调用都要先读到访客记录,再判断是否命中触发条件——整个判断必须在毫秒级完成,否则问卷就弹不出来。
原来的三件套,各自卡在哪
pread,避免线程在重查询时互相抢 CPU。即便如此,P99 仍在 50ms 左右,访问模式切换、批任务一跑就出现周期性 brownout(短时性能塌陷)。三套系统三份运维,而运维的人手是个位数。
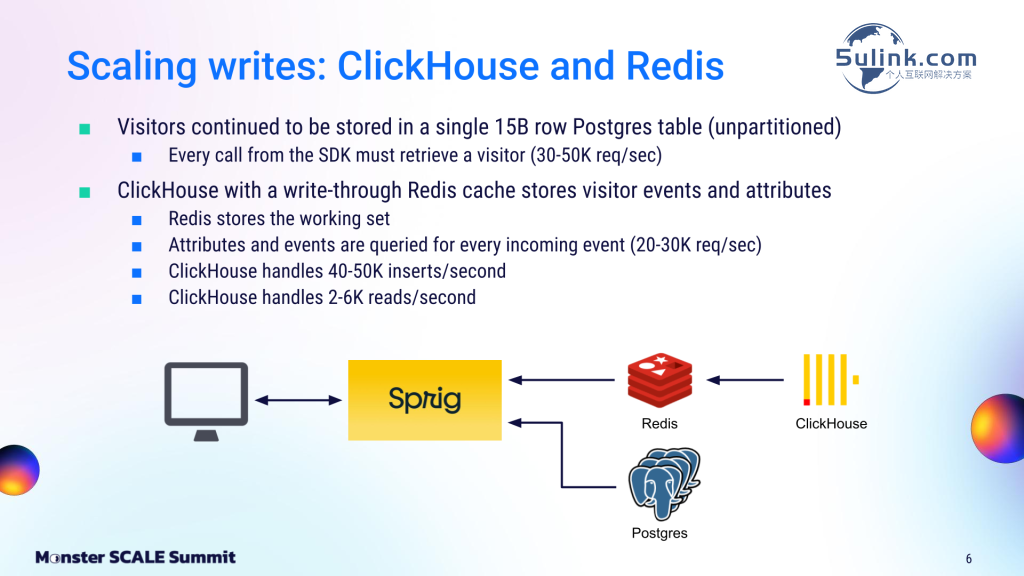
四条路,三条被否
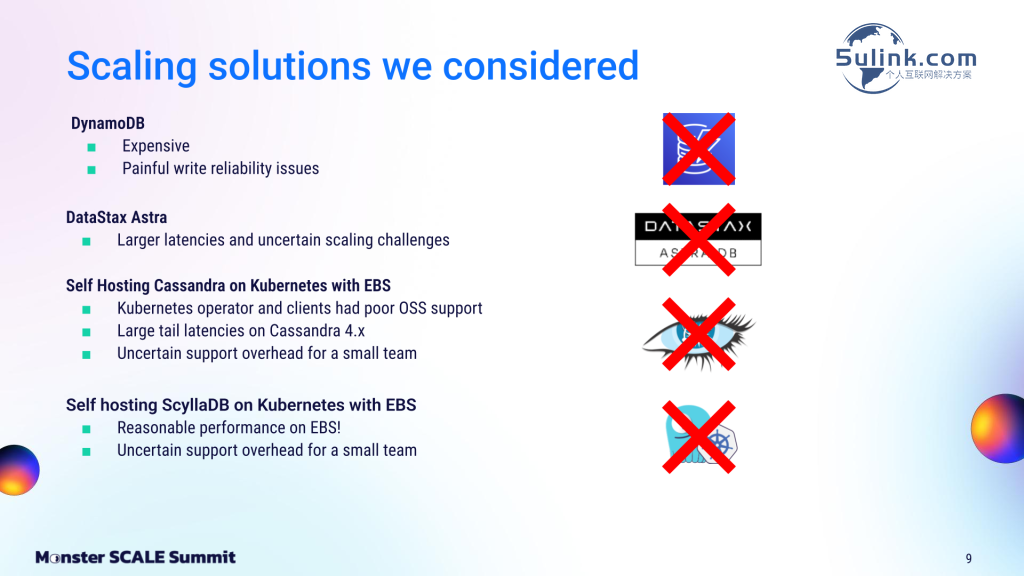
团队评估了四个方向:
| 候选 | 结论 |
|---|---|
| **DynamoDB** | 否——按 Sprig 的读写量,RCU/WCU 计价成本扛不住;团队此前还吃过写入可靠性亏 |
| **DataStax Astra** | 否——基准测出来延迟更高、扩展行为不确定;IBM 收购带来的不确定性也是风险 |
| **自建 Cassandra on K8s** | 否——测试里尾延迟立刻不可接受,而且等于让**两个人的团队**长期运维一个大型 Java 分布式数据库 |
| **ScyllaDB** | ✅ 选中——低延迟扛得住 Sprig 的规模(注:自托管 K8s 版也被排除,最终落地的是 Cloud 托管版) |
被否掉的三条里,最扎心的是 Cassandra 那条:技术上并非不可行,是运维人力不允许。
迁移:双写 + 双读校验,对齐到 99.99% 才切
updated_at 字段作为权威时间戳。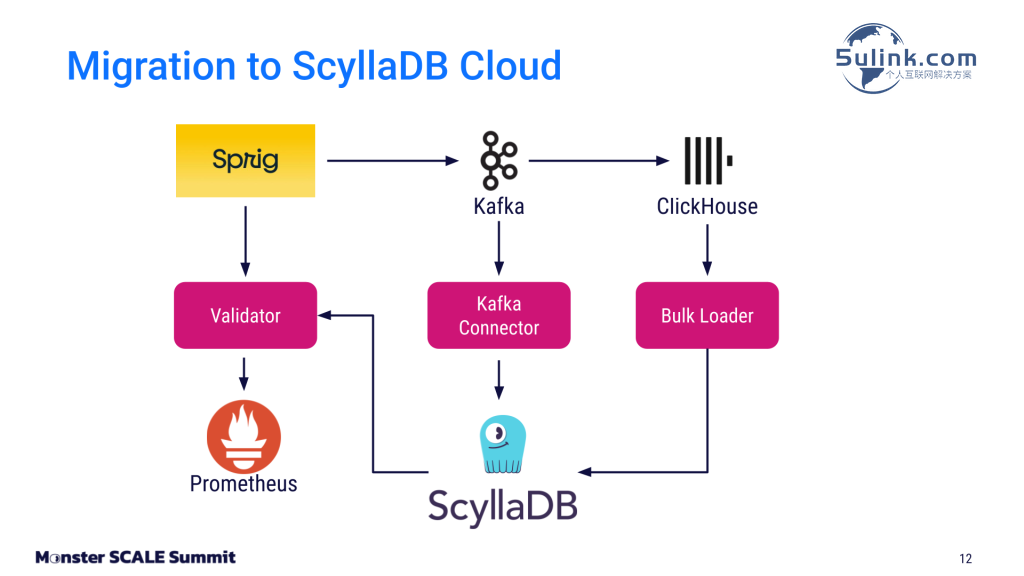
结果:读延迟 4-8 倍改善
Sprig 高级工程师 Brendan Cox 的原话:属性负载上 ScyllaDB 的读延迟约为 Redis 的 1/4,整体平均延迟约 500 微秒、P90 约 1-2 毫秒,比原 Redis 方案好 4-8 倍。
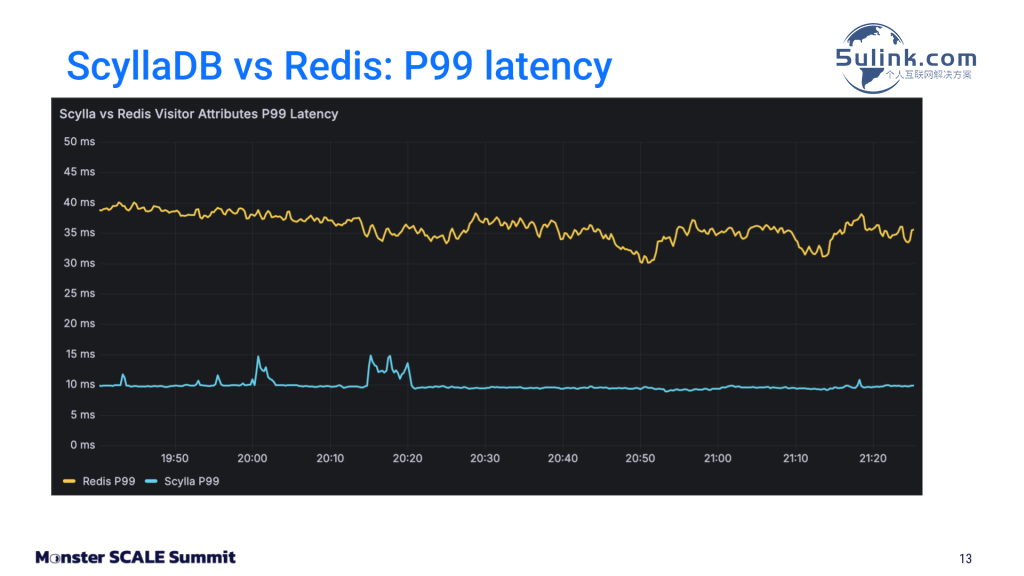
下一步他们准备上 Incremental Compaction(写放大更优,适合缓存读场景)和 Workload Prioritization(保证周末批任务不挤占实时读)。
小夏点评
updated_at 为权威)+ 双读校验对齐到 99.99% 才切。这是小团队做”不可逆迁移”时最稳的模板。