二手数据中心卡跑本地大模型实测:P40、P100、V100、A4000 到底怎么选
数据中心退役下来的 Tesla 加速卡,正在变成家用本地大模型最便宜的入场券:一张二手 P40 花 420 美元就能给你 24GB 显存,而同容量二手 RTX 3090 在亚马逊上要 1980 美元左右。
拦在便宜前面的不是算力,是软件。CUDA 13 已经取消了对 Maxwell、Pascal、Volta 架构的离线编译,vLLM 则把 P40、P100、V100 三张卡全部拒收。ComputingForGeeks 在 2026 年 10 月用租来的机器把这批卡挨个跑了一遍 llama.cpp 基准,并对照当前文档核清了驱动、Ollama、vLLM 的支持边界,结论如下。
先查软件支持,再谈买卡
老卡便宜是因为服务器批量退役,NVIDIA 也已经把最老的几张挪进了 legacy 列表。CUDA 13.0 的发布说明写得很直白:Maxwell、Pascal、Volta 的离线编译已移除,工具链只保证支持到 12.x。今天每张卡的实际处境是:
| 卡 | CUDA 13 能否构建 | 最新驱动分支 | Ollama | vLLM | llama.cpp |
|---|---|---|---|---|---|
| P40、P100 | 不能,只能 CUDA 12.x | R580 LTS | 可以,需驱动 570+ | 不支持 | 可以,CUDA 12 构建 |
| V100 | 不能,只能 CUDA 12.x | R580 LTS | 可以,需驱动 550+ | 不支持 | 可以,CUDA 12 构建 |
| RTX A4000 | 可以 | 当前分支 | 可以 | 可以 | 可以 |
| MI50、MI60 | ROCm 已放弃 | 内核自带 amdgpu | 仅 Vulkan | 不支持 | Vulkan 或社区 ROCm |
| Arc Pro B60 | 非 CUDA | 内核自带 xe | Vulkan | 可以(XPU 后端) | Vulkan 或 SYCL |
这张表里有三条结论,每一条都直接决定便宜卡能不能塞进你现有的技术栈:
- 1. vLLM 的 GPU 要求现在写的是 compute capability 7.5,所以 V100(7.0)和两张 Pascal 卡一起出局。
- 2. Ollama 的文档里三张 Tesla 都还列着,但要求 6.x 架构跑 570 以上驱动。
- 3. NVIDIA 的 595、615 两条 Linux 驱动分支里,P40、P100、V100 只出现在 580 兼容列表中。
还有一个不报错的坑:驱动版本没跟上时,Ollama 不会明确失败,它会静默回落到 CPU,模型照样跑,只是慢得莫名其妙。所以这类卡上机第一步是先把 580 驱动分支装好。
同一批模型上的横向实测
每张卡都在 vast.ai 上租了一台,用 CUDA 12 工具链从源码编译 llama.cpp v0.7.0,按卡指定架构位(P40 用 61,P100、V100、A4000 分别用 60、70、86),统一跑同一批 GGUF 文件:Qwen3 8B、Qwen3 32B 的 Q4_K_M,以及 MXFP4 的 gpt-oss-20b。16GB 的卡跑不了 32B 模型。
git clone --depth 1 --branch v0.7.0 https://github.com/ggml-org/llama.cpp
cmake -S llama.cpp -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=61 -DCMAKE_BUILD_TYPE=Release
cmake --build build -j"$(nproc)" --target llama-bench
build/bin/llama-bench -m Qwen3-32B-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 3 -fa 0,1
P40 上那个 18.4 GiB 的模型完整装进了显存,解码稳定在 12 token/s 左右:
| model                          |       size |     params | backend    | ngl |  fa |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | --: | --: | --------------: | -------------------: |
| qwen3 32B Q4_K - Medium        |  18.40 GiB |    32.76 B | CUDA       |  99 |   0 |           pp512 |        220.66 ± 0.31 |
| qwen3 32B Q4_K - Medium        |  18.40 GiB |    32.76 B | CUDA       |  99 |   0 |           tg128 |         12.02 ± 0.01 |
| qwen3 32B Q4_K - Medium        |  18.40 GiB |    32.76 B | CUDA       |  99 |   1 |           pp512 |        219.15 ± 0.24 |
| qwen3 32B Q4_K - Medium        |  18.40 GiB |    32.76 B | CUDA       |  99 |   1 |           tg128 |         12.41 ± 0.00 |
开启 flash attention 后的完整成绩(pp512 是读提示词的速度,tg128 是出答案的速度):
| 卡 | Qwen3 8B pp512 / 解码 | gpt-oss-20b pp512 / 解码 | Qwen3 32B pp512 / 解码 | 待机功耗 | 峰值功耗 |
|---|---|---|---|---|---|
| Tesla V100 SXM2 32GB | 2909 / 109.2 | 未跑成 | 765 / 31.7 | 42 W | 291 W |
| Tesla P40 24GB | 915 / 47.0 | 1418 / 62.7 | 219 / 12.4 | 11 W | 242 W |
| Tesla P100 PCIe 16GB | 683 / 38.4 | 524 / 65.2 | 装不下 | 28 W | 211 W |
| RTX A4000 16GB | 2733 / 72.5 | 3138 / 114.8 | 装不下 | 16 W | 140 W |
几点需要说明清楚,否则这张表容易被用错:
- – 实测租到的是 V100 SXM2 模组,不是商品链接里的 PCIe 卡。两者显存带宽同为 900 GB/s,但 PCIe 版功耗墙是 250 W 而非 300 W。V100 的 gpt-oss-20b 在那台机器上下载中断了两次,所以没有数据。
- – 基线本来放了 RTX 3090,但那台机器把卡限在 220 W,跑 8B 反而输给 A4000,只能剔除。作为参照,llama.cpp 官方 CUDA 成绩榜上 3090 跑 Llama 2 7B Q4_0 约 158 token/s,V100 约 129,P40 约 55。
- – 排序基本由显存带宽决定:V100 的 HBM2 压过更新一代的 A4000,A4000 又压过 P40 的 GDDR5。P100 是唯一的例外——它的带宽是 P40 的两倍,跑 8B 却更慢,原因很可能是 compute capability 6.0 缺少 llama.cpp 量化内核依赖的 int8 点积指令。
- – P40 的提示词处理只有 V100 的三分之一左右,长上下文、长 RAG 提示词在 P40 上手感明显发涩。
按预算和模型挑卡
买家最先算的是每 GB 显存单价。按 10 月 22 日的亚马逊价格带算下来是这样:
| 卡 | 价格带 | 每 GB 显存成本 |
|---|---|---|
| Tesla P100 16GB(认证翻新) | 约 155 美元 | 约 10 美元 |
| Tesla P40 24GB(翻新) | 约 420 美元 | 约 17 美元 |
| Tesla V100 16GB PCIe(翻新) | 约 365 美元 | 约 23 美元 |
| Tesla V100 32GB PCIe(翻新) | 约 860 美元 | 约 27 美元 |
| Intel Arc Pro B60 24GB(全新) | 约 650 美元 | 约 27 美元 |
| RTX A4000 16GB(翻新) | 约 1045 美元 | 约 65 美元 |
| RTX 3090 24GB(翻新) | 约 1980 美元 | 约 83 美元 |
最后一行就是当下行情最真实的写照:同样 24GB,翻新 3090 的价格接近翻新 P40 的五倍——这也是这么多人愿意忍 P40 的速度、也要买它的原因。
V100 32GB PCIe:这批卡里的整体最优
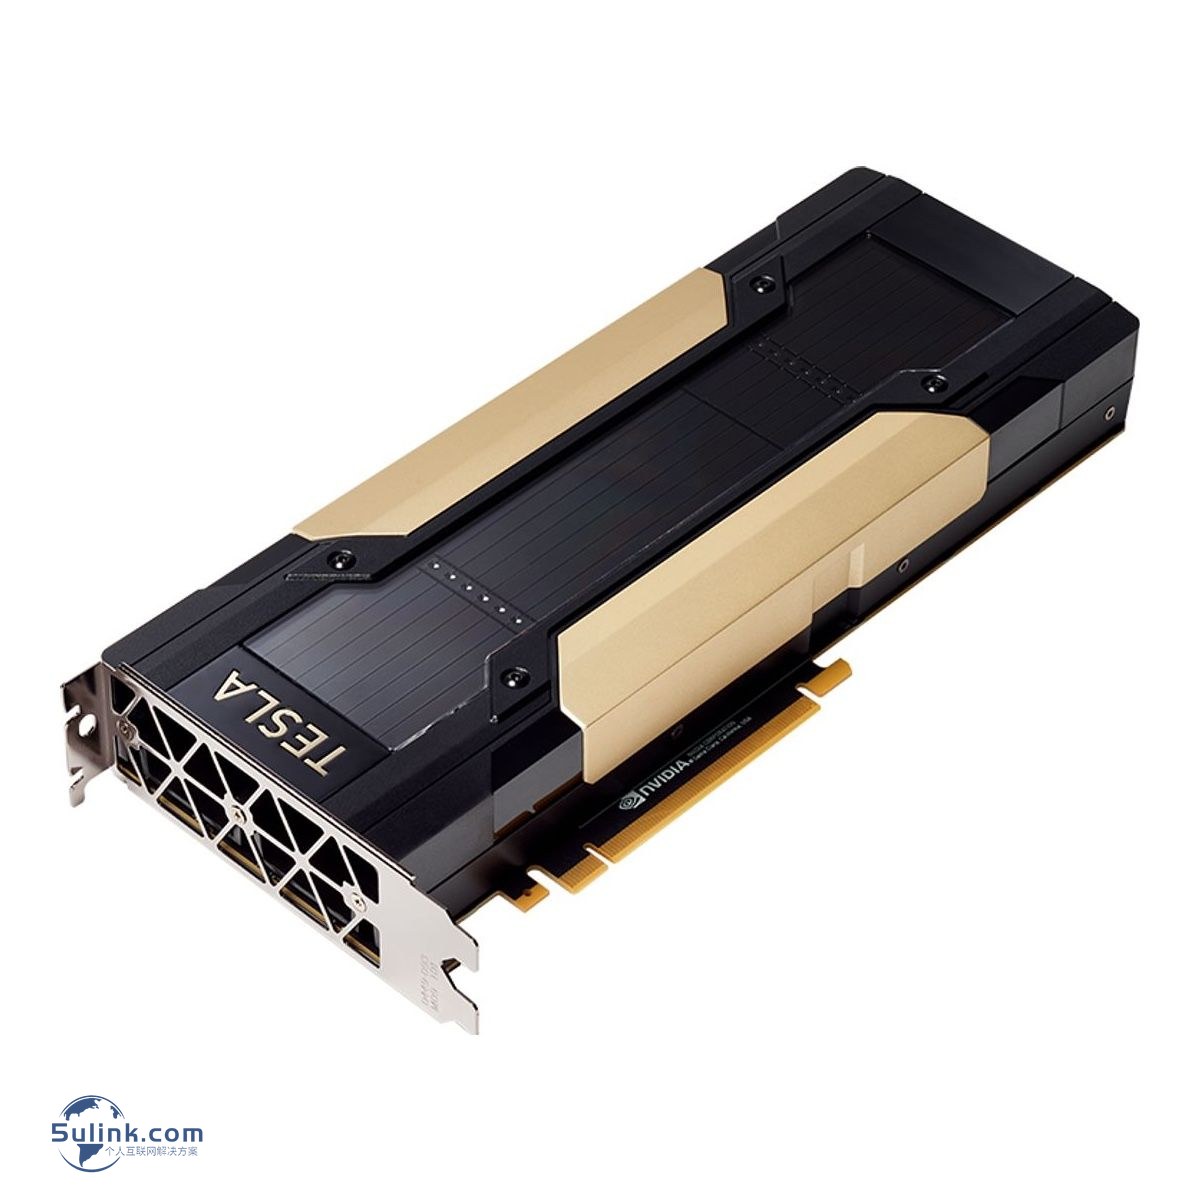
图:NVIDIA Tesla V100 PCIe(图源:NVIDIA)
参与测试的卡里,V100 解码最快,32GB 版本能在 Q4 量化下装进 32B 模型并留出可观上下文。租来的模组上跑 Qwen3 32B 达到 31.7 token/s,是 P40 的两倍多;两个模型上的提示词处理速度都约为 P40 的三倍,长提示词场景差距会更明显。
适合:想要 30B 级别模型跑在舒适阅读速度上,且能接受不用 vLLM。不适合:必须用 vLLM,或者打算一路跟着 CUDA 大版本升级——Volta 已经冻结在 12.x。如果 8B–14B 就够用,16GB PCIe 版约 365 美元。
P40 24GB:最便宜的 24GB
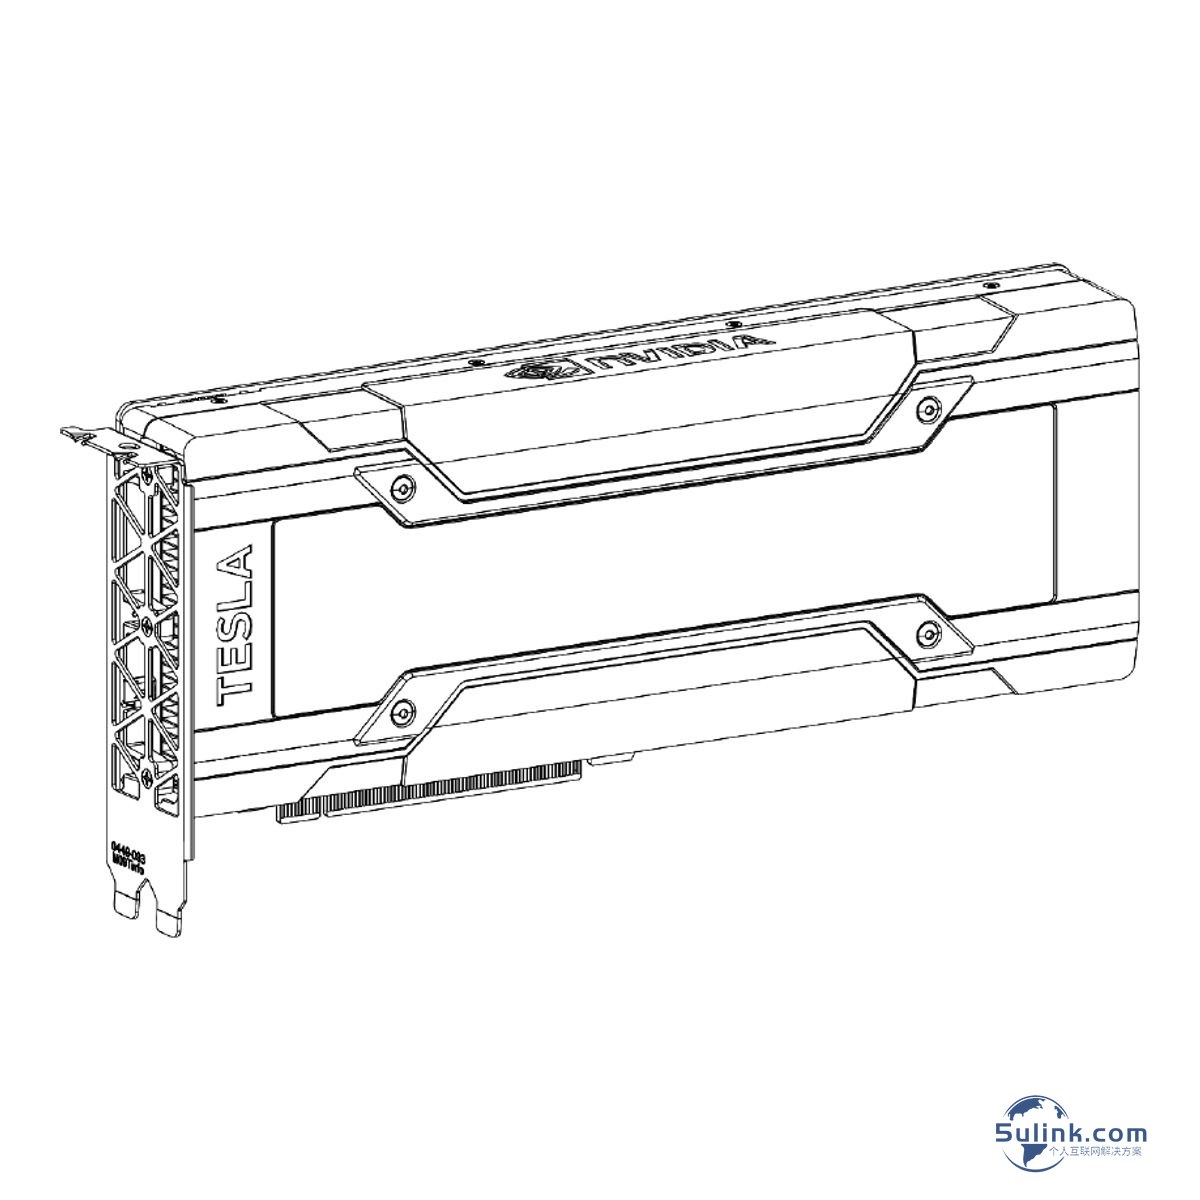
图:NVIDIA Tesla P40 产品资料图(图源:NVIDIA)
绝大多数人是从 P40 开始关注这个市场的,因为它就是这个市场存在的理由:420 美元买 24GB,能装下任何 16GB 卡装不下的 32B Q4 模型。实测待机 11 W,是几张 Tesla 里最低的。
代价是速度:32B 模型解码 12.4 token/s,能读但谈不上流畅,而且 P40 的 FP16 吞吐只有 FP32 的 1/64。适合:24GB 预算型配置,或者干脆上两张凑 48GB。不适合:要微调、要用 FP16 重度引擎。
P100 16GB PCIe:最低价的入场券
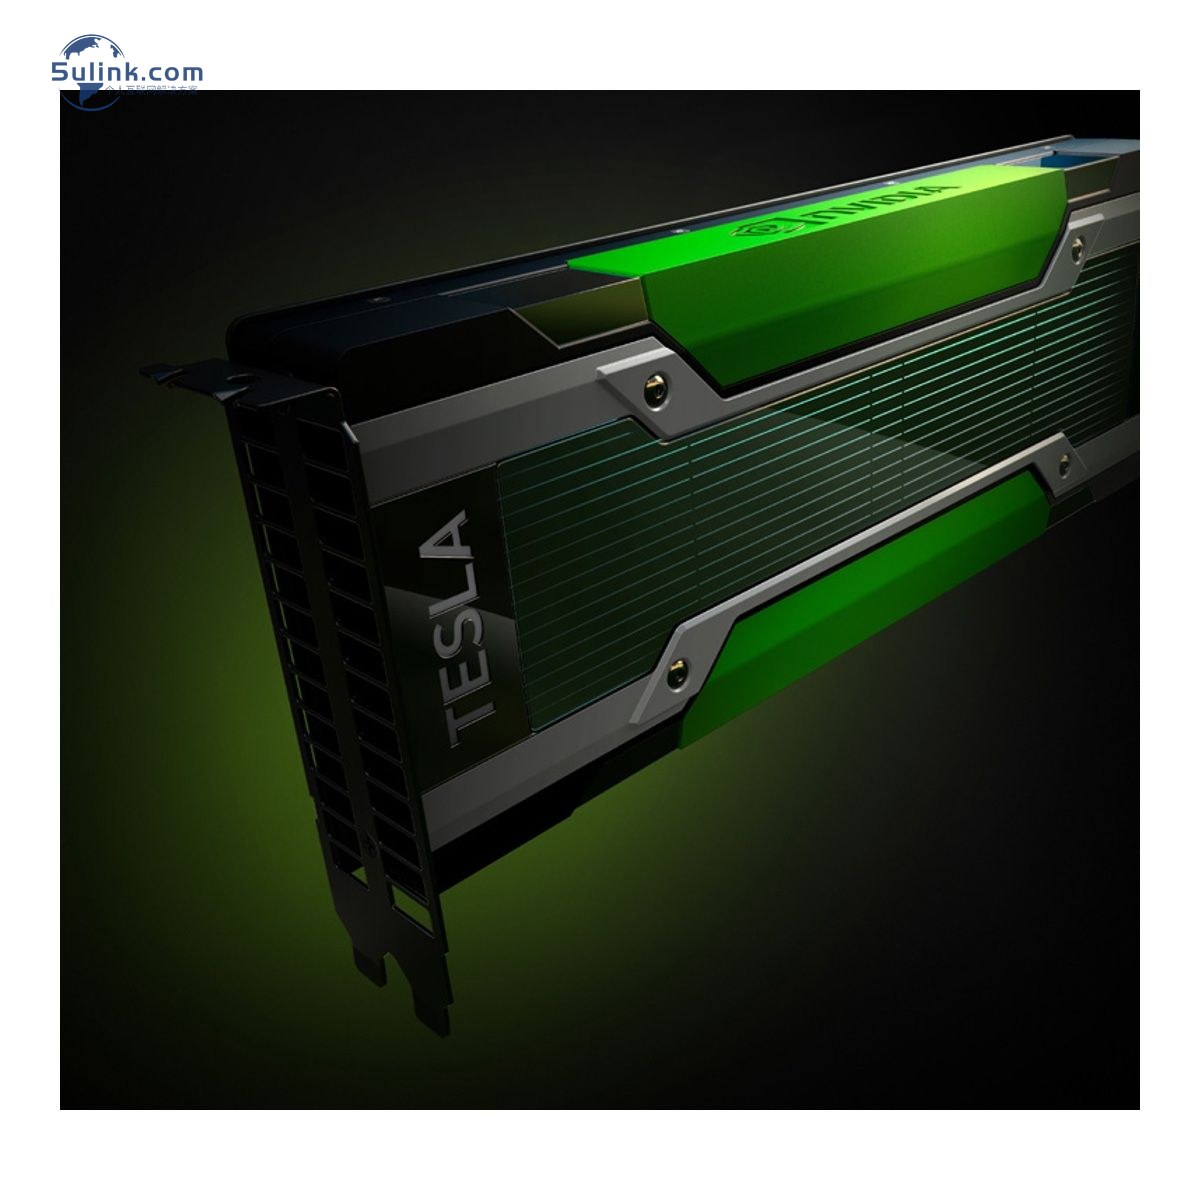
图:NVIDIA Tesla P100 PCIe(图源:NVIDIA)
155 美元是这批卡里最便宜的 16GB,而且用的是 HBM2。gpt-oss-20b 解码 65.2 token/s,略快于 P40,但在稠密的 8B 模型上落后于 P40,提示词处理是全场最慢的。适合:手上已经有一台服务器,想拿 8B–20B 模型试试水。不适合:盘算着以后扩到 24GB——两张 P100 要花掉大约四分之三张 P40 的钱,功耗还是它的两倍。
RTX A4000 16GB:最容易正常过日子的一张
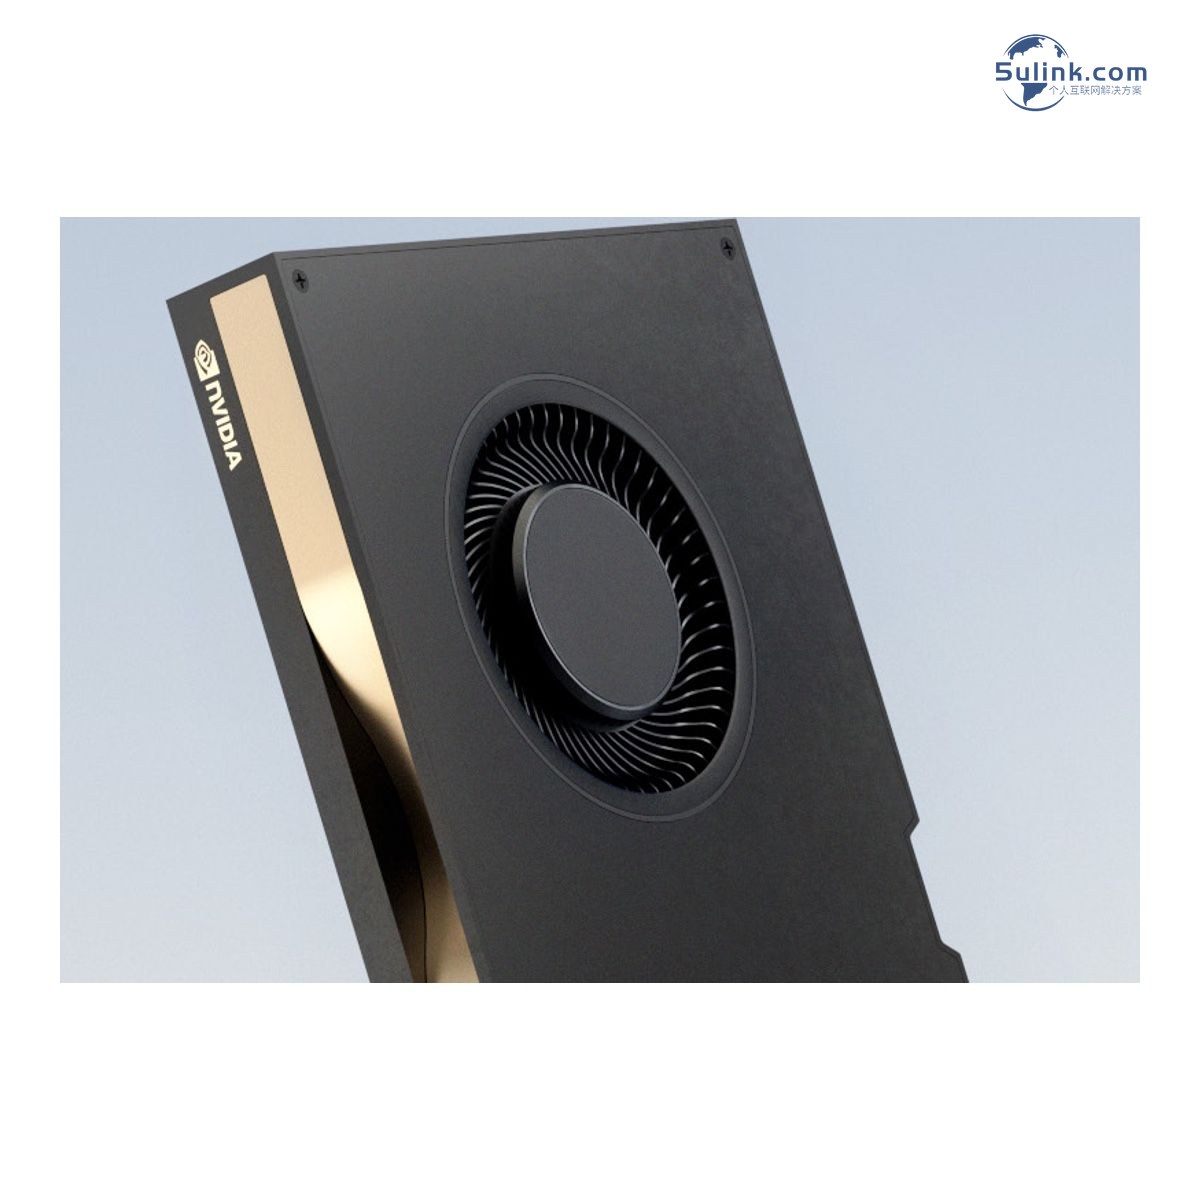
图:NVIDIA RTX A4000(图源:NVIDIA 资料页)
测过的 NVIDIA 卡里,只有 A4000 能当普通桌面显卡用:单槽、自带涡轮风扇、四个 DisplayPort、单根 6-pin 供电、140 W,跑当前版本 CUDA,vLLM 直接可用。gpt-oss-20b 解码 114.8 token/s,是跑成这项测试的三张卡里最快的。
输在价格:翻新价约 1045 美元,这笔钱足够买一张 V100 32GB 还能剩。适合:小机箱、共享工作站、以 vLLM 为核心的部署。不适合:把每 GB 单价当第一指标的人。
Intel Arc Pro B60 24GB:按二手价卖的新卡
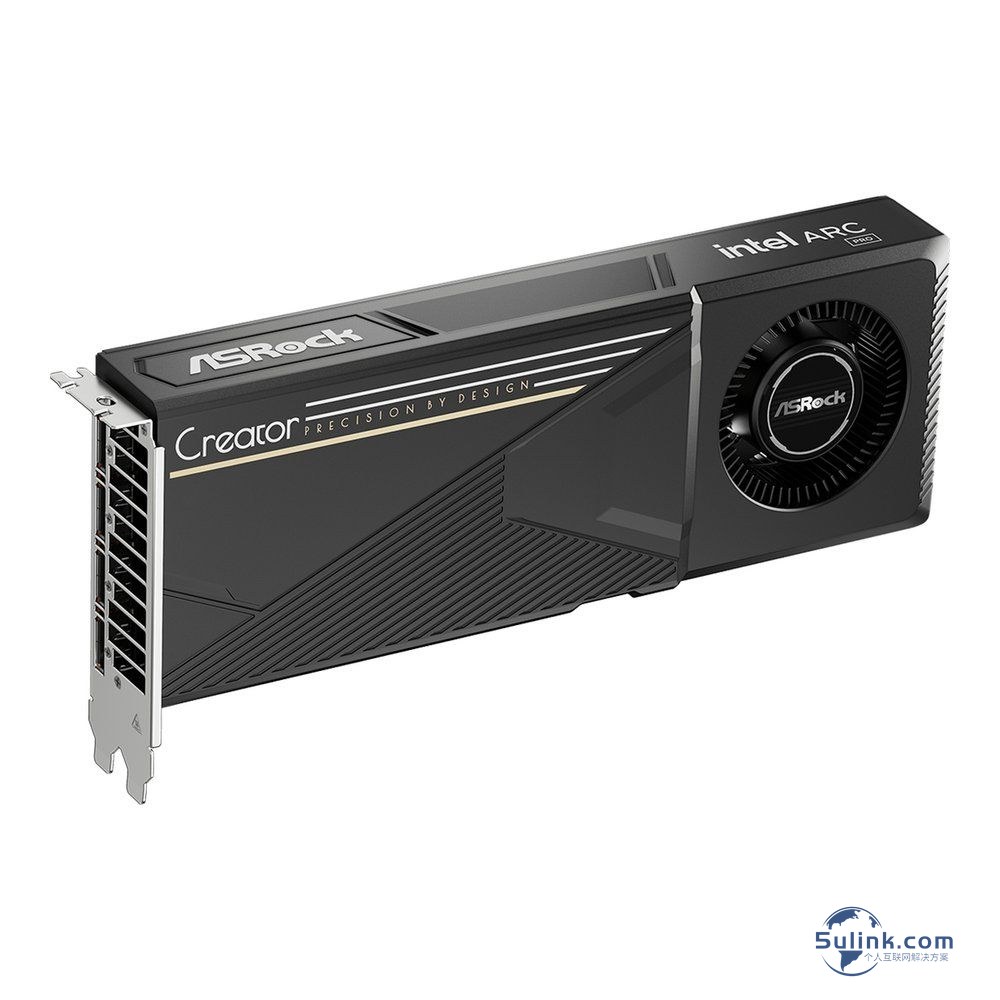
图:ASRock Arc Pro B60 Creator 24GB(图源:ASRock)
B60 没有实测,但它改变了这笔账:全新、24GB、有保修、有显示输出,约 650 美元,每 GB 成本和二手 V100 32GB 打平。llama.cpp 的 Vulkan 成绩榜上它跑 Llama 2 7B 约 69 token/s,高于 P40。
代价是没有 CUDA,凡是只出 CUDA 版本的框架都跑不了。适合:llama.cpp 或 Ollama 走 Vulkan 就能覆盖你的模型的场景。
MI50:参数诱人,但要清楚放弃了什么
Instinct MI50 32GB 出现在每一个二手 GPU 讨论帖里,因为 1 TB/s 的 HBM2 让它在 llama.cpp 的 Vulkan 成绩榜上解码速度约为 P40 的两倍。但 ROCm 6.4 的系统要求里,它的 gfx906 芯片已被标记为不支持,此后每个 ROCm 版本都维持原样;Ollama 的 ROCm 支持列表从 MI100 起步。
Vulkan 跑 llama.cpp 仍然可用,社区也有维护中的 gfx906 ROCm 构建。但亚马逊上找不到可信的 MI50 32GB 在售链接,所以购买渠道这一环补不上。
把被动散热的卡装进台式机
上面每张 Tesla 都是为服务器机箱的强风道设计的,装进家用机箱要提前准备:
- – 供电:EPS 转双 PCIe 8-pin 转接线,约 13 美元
- – 散热:涡轮导风罩 + 97×33 mm 风扇
- – 固件:主板开启 Above 4G Decoding
- – 显示:留一颗核显或第二张卡
- – 混插:不能和任何 Blackwell 卡同机
每一条都值得一句话解释。P40、P100、V100 PCIe 用的是 CPU 供电的 EPS 接口,不是 PCIe 供电口,硬把 PCIe 线塞进去是常见事故;它们自身没有风扇,导风罩套件通常只含罩子和螺丝,风扇要另买,接主板风扇口让 BIOS 能调速——先查风扇额定电流,很多风扇电流超过风扇口能给的约 1 A,这时用 SATA 供电的风扇集线器更稳。P40 要映射 32 GB BAR,P100 和 V100 是 16 GB,不开 Above 4G Decoding 可能根本不开机,或者驱动起不来卡。
Tesla 全系没有显示输出,屏幕必须留给核显或第二张卡。另外 Pascal、Volta 需要 NVIDIA 闭源内核模块,Blackwell 需要开源模块,而两者只能加载一个——Tesla 不能和任何 Blackwell 卡(包括 RTX 50 系和 RTX PRO Blackwell)同机使用。
待机功耗在模型加载后会变。上表的读数都是空载时测的,用户普遍反馈 Tesla 卡在模型常驻时会停在 P0、约 50 W;nvidia-pstated 这个守护进程可以在空闲时把它们降回 P8。
要插两张以上卡,先核插槽间距和通道分配。
按你打算常驻的模型来选
从”最大要常驻哪个模型”倒推,再挑装得下它、还留得下上下文的最低价卡:30B 级别就买 V100 32GB,前提是你愿意留在 CUDA 12 并且不用 vLLM;P40 是预算型的 24GB 选择,慢但便宜;P100 当廉价试验田;A4000 留给需要正常桌面体验、需要当前 CUDA 的人。预算够买新卡的话,再和全新卡对比一轮也不迟。
小夏点评
- 1. 这批卡真正的成本不在卡价,在”软件冻结”。 CUDA 12.x 是终点站,驱动 580 是末班车。买回来发现 vLLM 不认卡、Ollama 静默掉 CPU,比单纯跑得慢更消耗人——性能差可以忍,架构被上游放弃是没法修的。
- 2. 性价比要按”能常驻的最大模型”算,不能按显存单价算。 P100 每 GB 10 美元账面最漂亮,可 32B 模型装不进去,这张卡在你真正想跑的模型上价值就是零;反过来 P40 单价贵一档,却是唯一能把 32B Q4 完整装进显存的便宜卡。
- 3. 对中国 IT 运维和开发者的启示:国内二手市场上 P40、P100 的退役存量非常大,价格比海外更低,是低成本搭本地推理池的现实选择。但要提前把 Ubuntu + 580 驱动 + CUDA 12 这条”冻结栈”锁死,把 EPS 转接线、导风罩、风扇、Above 4G 这些写进采购清单,而不是装完机才发现主板不认卡、电源少根线。老卡省下的钱,有一半会花在”让它正常工作”上——这笔账要在下单前算完。
参考链接
- – 原文:Best Used Datacenter GPUs for Local AI: P40, V100, MI50 and A4000(ComputingForGeeks,2026-10-22)— https://computingforgeeks.com/best-used-datacenter-gpu-local-ai
- – NVIDIA CUDA Toolkit 13.0 Release Notes — https://docs.nvidia.com/cuda/archive/13.0.0/cuda-toolkit-release-notes/index.html
- – vLLM GPU requirements — https://docs.vllm.ai/en/latest/getting_started/installation/gpu.html
- – Ollama GPU 文档 — https://docs.ollama.com/gpu
- – llama.cpp CUDA 成绩榜 — https://github.com/ggml-org/llama.cpp/discussions/15013
- – llama.cpp Vulkan 成绩榜 — https://github.com/ggml-org/llama.cpp/discussions/10879
- – ROCm 6.4 系统要求 — https://rocm.docs.amd.com/projects/install-on-linux/en/docs-6.4.0/reference/system-requirements.html
- – nvidia-pstated — https://github.com/sasha0552/nvidia-pstated