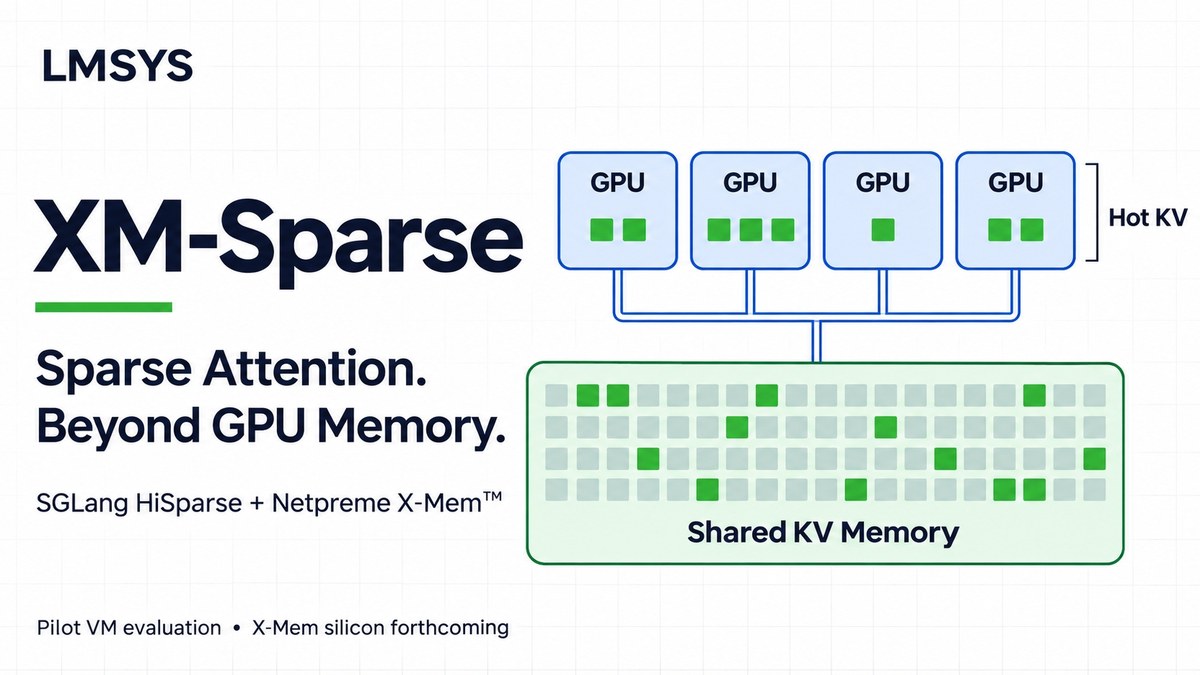
稀疏注意力的新外挂:LMSYS 联手 Netpreme,KV 外置换内存层,解码快 2–3 倍
LMSYS 与 Netpreme 把 KV 外置换成高带宽内存层:16K 上下文 TPOT 降 49.25%,峰值解码吞吐达 2.09–3.04 倍。

Share Life
LMSYS 与 Netpreme 把 KV 外置换成高带宽内存层:16K 上下文 TPOT 降 49.25%,峰值解码吞吐达 2.09–3.04 倍。
NVIDIA 把已初始化的 GPU 显存与进程状态做成可移植快照,Kubernetes 上恢复推理副本仅需 3.6–42.7 秒,比冷启动快 8–36 倍。
GMI Cloud 与 Tensormesh 联合实测:SSD 支撑的前缀缓存让首 token 延迟降 4 倍,命中率从 3% 升到 50% 以上,纯赚性能不加钱。
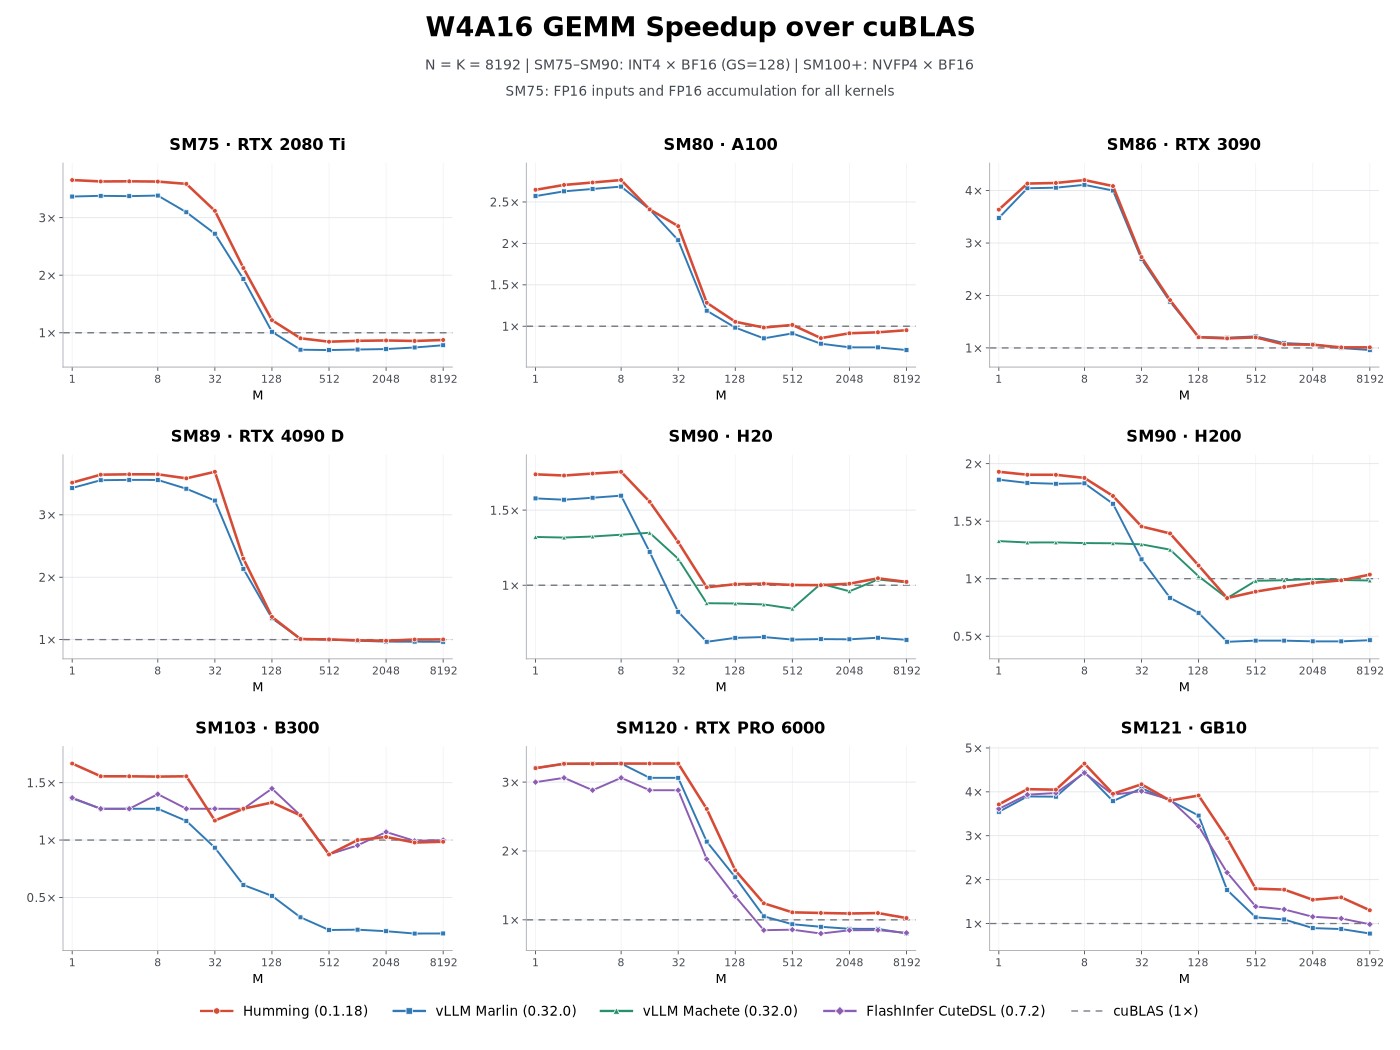
蚂蚁与vLLM社区开源量化内核库Humming:端到端吞吐最高提升43%,单内核编译从23秒降到2秒内,覆盖Turing起NVIDIA GPU与真武810E。
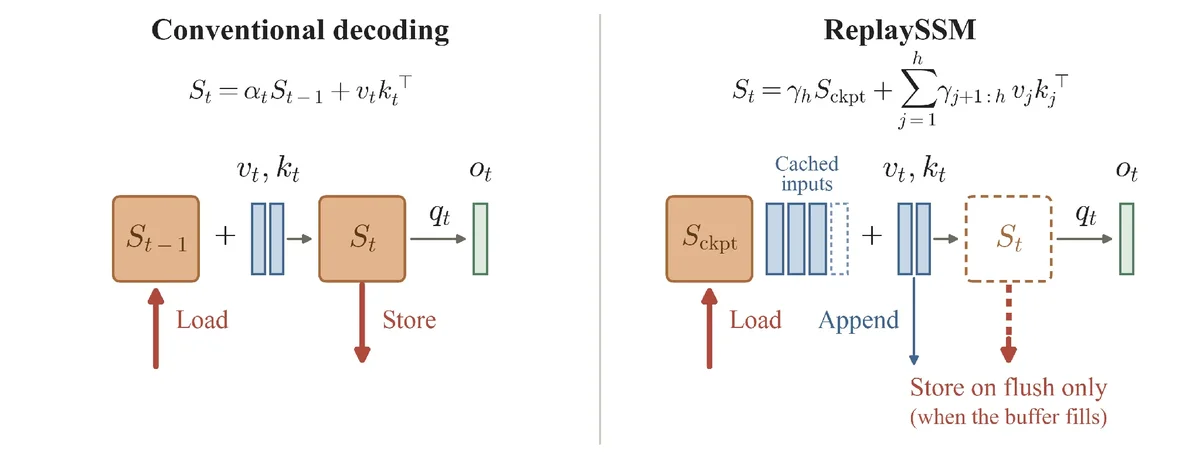
混合模型的解码瓶颈在 SSM 层:NVIDIA 与普林斯顿把状态拆成检查点+输入回放,投机解码提速 2.1 倍,已上生产。

狗云服务器优惠