向量数据库2026基准对决:Qdrant vs Milvus vs Weaviate 深度对比
2026 年的向量数据库市场已经分化成清晰的四层:托管型(Pinecone、Vertex Vector)、开源主力(Qdrant、Weaviate、Milvus)、嵌入式 / Postgres 内嵌(Chroma、pgvector)、大规模混合检索(Vespa)。本文把四份公开基准的可溯源数据放在一起对照,帮你看清”谁快”背后的条件差异。
关于配图与数据来源:本文的封面为 ranksquire《Fastest Vector Database 2026》的”速度 × 场景”四象限矩阵,正文插图为 IoT Digital Twin PLM 基准的选型决策流程图;全文数据来自四个独立来源,每张表下方均标注出处与测试条件,不同来源之间不可直接横比。
数据来自哪里
| 来源 | 时间 | 规模 / 条件 | 用来支撑什么 |
|---|---|---|---|
| IoT Digital Twin PLM(主基准) | 2026‑04 基线 | dbpedia-openai-1M、1536 维、单台 AWS c6i.8xlarge(32 vCPU / 64GB / NVMe EBS);Milvus GPU 用 g4dn.2xlarge + 1×T4;10,000 条随机查询 |
表 1、过滤与部署形态、选型决策树 |
| Tiger Data | 2025‑04 | 50M 向量、768 维,ANN-Benchmarks 口径 | 表 2:Qdrant vs pgvector + pgvectorscale |
| digitalapplied | 2026‑04 | 10M 规模、7 维决策矩阵 | 表 3 |
| ranksquire | 2026‑02 | 768 维及以上的”高维 + 高并发”场景 | 表 4、2026 速度定律 |
软件版本(主基准快照,2026‑04):Pinecone Serverless(API 2026‑03)、Weaviate 1.25、Qdrant 1.11、Milvus 2.5。
表 1:1M 向量 / 1536 维 / 单机主基准(2026‑04 基线)
| 指标 | Pinecone | Weaviate | Qdrant | Milvus |
|---|---|---|---|---|
| P99 查询延迟(ms) | 28 | 19 | 12 | 18 (CPU),8 (GPU) |
| Recall@10 | 0.94 | 0.97 | 0.99 | 0.99 |
| 吞吐(QPS @ P99<100ms) | 1,200 | 2,800 | 4,100 | 3,900 (CPU),8,200 (GPU) |
| 索引速度(vectors/s) | 50K(厂商数据) | 35K | 42K | 85K (CPU),320K (GPU) |
| 运维成本($/M vectors/月) | $0.12 | $320 | $280 | $400(自建集群) |
| 规模上限 | 无限(托管) | 200M 单节点 | 500M 单节点 | 10B+(集群) |
| 过滤延迟 @ 5% 选择性(ms) | 220 | 45 | 38 | 52 |
| 过滤延迟 @ 95% 选择性(ms) | 32 | 21 | 14 | 22 |
| 混合搜索(dense + BM25) | 不支持 | 原生支持 | 不支持(即将支持) | 不支持 |
| Reranker 集成 | 经 API | 原生(Cohere) | 经 API | 经 API |
| 托管 / 自建 | 托管 | 两者皆可 | 自建 | 自建(Kubernetes) |
来源:IoT Digital Twin PLM《Vector Database Benchmarks 2026》,2026‑04 基线,每季度刷新。
六条关键观察(来自原基准)
- 延迟梯队:Qdrant 靠 HNSW + SIMD 领跑,Weaviate 次之;Pinecone 慢是因为优先”每向量成本”而非延迟;Milvus 上 GPU 最快(8ms),但要先投硬件。
- 召回取舍:Pinecone 的量化策略比 Qdrant 少 5‑6 个百分点的 recall(0.94 vs 0.99)。做推荐系统这类”精度敏感”场景会痛。
- 过滤悬崖:过滤命中 <5% 时,所有库都出现 5‑15 倍延迟劣化;Qdrant 与 Weaviate 的 in-filter 策略扛得最好,Pinecone 的 post-filter 最吃亏。
- 索引速度在大规模下会复利:每天摄入 10M 向量,Milvus GPU 约 60 秒、Qdrant 约 240 秒、Pinecone 约 200 秒。
- 成本不只按查询算:Pinecone 单次查询最便宜,但如果你要离线预建超大索引,自建 Qdrant 的”每向量月成本”反而更低。
- 混合搜索稀有但值钱:只有 Weaviate 原生支持 向量相似度 + BM25 全文的同一次查询,文档检索场景质量可提升 10‑15%。
表 2:50M 向量 / 768 维 —— Qdrant vs Postgres(pgvector + pgvectorscale)
99% 召回阈值
| 指标 | Qdrant | Postgres(pgvector + pgvectorscale) | 差异 |
|---|---|---|---|
| p50 延迟 | 30.75 ms | 31.07 ms | Qdrant 低 1% |
| p95 延迟 | 36.73 ms | 60.42 ms | Qdrant 低 39% |
| p99 延迟 | 38.71 ms | 74.60 ms | Qdrant 低 48% |
| 吞吐 | 41.47 QPS | 471.57 QPS | Postgres 高 11.4× |
90% 召回阈值
| 指标 | Qdrant | Postgres | 差异 |
|---|---|---|---|
| p50 延迟 | 4.74 ms | 9.54 ms | Qdrant 低 50.3% |
| p95 延迟 | 5.50 ms | 13.30 ms | Qdrant 低 58.6% |
| p99 延迟 | 5.79 ms | 15.73 ms | Qdrant 低 63.2% |
| 吞吐 | 360.81 QPS | 1,589.79 QPS | Postgres 高 4.4× |
来源:Tiger Data《Pgvector vs. Qdrant》,50M 嵌入 / 768 维 / ANN-Benchmarks 口径。
怎么读这张表:单次查询延迟是 Qdrant 赢,批量吞吐是 Postgres 赢——而且这不是矛盾,而是两种优化方向(Qdrant 优先 HNSW 遍历效率,pgvectorscale 优先并行扫描 + 并发执行)。另外注意索引构建成本的反差:pgvectorscale 建 50M 索引约 11.1 小时,Qdrant 只要约 3.3 小时(pgvectorscale 当时还是单线程串行实现)。
表 3:10M 规模 p99 横评(2026‑04)
| 数据库 | 10M 规模 p99 | 定位 |
|---|---|---|
| Qdrant | ~12 ms | 开源阵营最快 |
| Vertex Vector | ~12 ms | GCP 原生托管 |
| Pinecone | ~10‑15 ms | 托管首选 |
| Vespa | ~15 ms | 大规模混合检索 |
| Weaviate | ~16 ms | 混合搜索 + GraphQL |
| Milvus | ~18 ms | 大规模分布式 |
| pgvector | ~25‑40 ms(取决于索引类型) | Postgres 内嵌 |
| Chroma | ~30 ms | 开发体验优先 |
来源:digitalapplied《Vector Databases for AI Agents 2026》(7 维决策矩阵)。
表 4:p99 / 最大 QPS / 冷启动矩阵(768 维及以上)
| 数据库 | p99 延迟 | 最大 QPS | 冷启动 | 强项 | 短板 |
|---|---|---|---|---|---|
| Qdrant | <8 ms | 15,000+ | <1 s | 纯延迟(Rust 底层优化) | 复杂分布式集群配置 |
| Milvus | <15 ms | 20,000+ | ~2 s | 吞吐(GPU 加速) | 硬件资源要求高 |
| Pinecone | <40 ms | 托管弹性 | 2‑5 s | 零运维的一致性 | 成本高、serverless 冷启动拖尾 |
| Weaviate | <50 ms | 8,000+ | <2 s | 混合检索准确度 | 元数据过滤多时掉速 |
| Chroma | <90 ms | <1,000 | <1 s | 开发速度 | 超过 10M 向量的生产负载不适用 |
来源:ranksquire《Fastest Vector Database 2026: 6 Benchmarks Compared》,2026‑02。原文注明:pgvector 因需要托管 PostgreSQL 环境,未纳入该项独立硬件测试。
三大向量数据库特性解析
Qdrant:延迟与自建性价比
- Rust + SIMD:HNSW 遍历的纯延迟冠军,1M 向量下 p99 < 8ms(768 维口径);
- 过滤在检索中完成(payload filter during search),不是事后补挂,因此过滤选择性对延迟的影响最小(5% 选择性下 38ms);
- 内置量化压缩内存占用——这正是自建成本的主要来源;
- 部署最轻:单二进制即可跑,1‑2 百万向量 / 8GB 内存是它的”开发级”上限;集群用 Raft 共识,3 节点起。
Milvus:吞吐与规模
- 42,000+ GitHub stars(2026‑06 统计),开源向量库里社区最大;
- Kubernetes 原生:需要独立 K8s 集群 + StatefulSet + etcd + MinIO,运维负担最重;
- GPU 索引:索引吞吐约为 HNSW 的 6 倍,查询快约 4 倍(g4dn.2xlarge + 1×T4 实测);
- 索引类型齐全:IVF、HNSW、SCANN,集群规模可到 10B+。
Weaviate:混合搜索
- 唯一原生支持 dense + BM25 同查,文档检索质量提升 10‑15%;
- GraphQL 与 REST API、写入时向量化模块、多租户数据隔离;
- 原生集成 reranker(如 Cohere),其余三家需经 API;
- 注意:同时过滤 50 个以上元数据字段时,QPS 可能下降 40‑60%——务必在部署前先把过滤结构做预聚合。
部署形态与运维负担
主基准把部署分成四类,并给出经验式判断:
| 形态 | 代表 | 特点 |
|---|---|---|
| Serverless / 托管 | Pinecone、Weaviate Cloud | 按查询或按向量月计费,零运维,但控制力与延迟波动受限 |
| 自建单机 | Qdrant 单二进制 | 适合开发与 hobby 规模,无副本、无故障转移 |
| 自建集群 | Qdrant 集群、Milvus VM 集群 | Raft 共识 + 分片,硬件自担,运维负担不轻 |
| Kubernetes 原生 | Milvus、Weaviate Operator | 依赖 sidecar / service mesh,延迟更低但部署复杂 |
经验法则(原文口径):团队 < 2 人用托管;2‑5 名 DevOps 用自建集群;5 人以上或已有 K8s 就上 Kubernetes 原生。
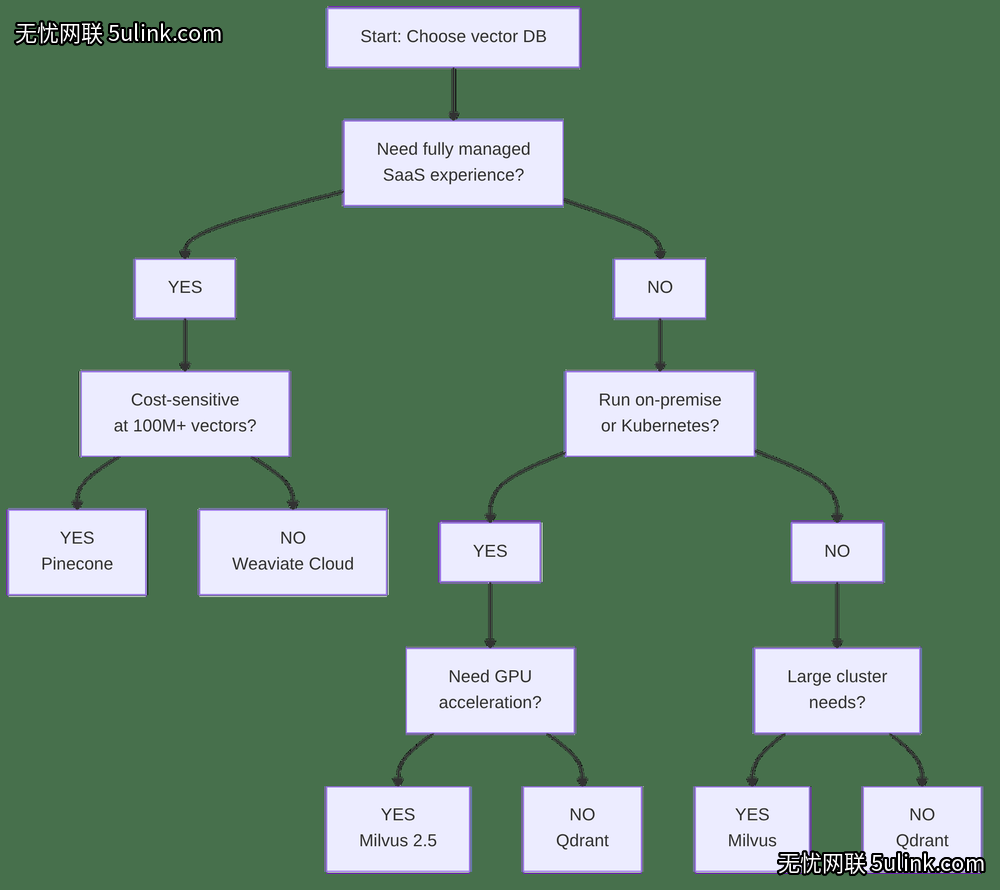
图 1 是主基准给出的选型决策树:先问”要不要全托管”,再问”是否对 100M+ 成本敏感”,最后落到部署形态与规模要求。
选型决策框架
| 场景 | 推荐 | 理由(对应来源) |
|---|---|---|
| 实时语音 Agent / 欺诈检测 | Qdrant | 纯 p99 最低(<8ms / 12ms 两套口径均为最优) |
| 事件管道 / 亿级以上批量 | Milvus(GPU) | 吞吐 8,200 QPS(1M 口径)、20,000+ QPS(高维口径) |
| 文档混合检索(语义 + 关键词) | Weaviate | 唯一原生 dense + BM25 |
| 零运维托管 | Pinecone | 全托管,p99 < 40ms,但冷启动 2‑5s |
| 10M 以内、已有 Postgres | pgvector | 同一套备份、权限与运维;digitalapplied 认为它覆盖约 70% 的实际 AI-agent 负载 |
| 开发调试 / 原型 | Chroma | 进程内跑,部署最快 |
2026 速度定律
检索不应占用 Agent 循环总时间的 5% 以上。(ranksquire 口径)
这条定律的代价是可量化的:某金融科技公司用 Chroma 时查询耗时 120 ms,直接撞上 200 ms 的银行网关上限,交易被丢弃、欺诈漏检;某语音 AI 团队用 Pinecone serverless,3 秒冷启动让对话”听起来是坏的”;某 B2B 分析平台上线数周就打满 Chroma 的 1,000 QPS 天花板。
因此:先用过滤策略(in-filter / 预聚合)而不是换库来救 p99——主基准的数据已经说明,低选择性过滤带来的 5‑15 倍劣化,远大于换库能解决的量级。
小夏点评
-
延迟与吞吐是两条不同的曲线:1M 口径下 Qdrant 拿下了 p99 12ms 的最低延迟;但 50M、99% 召回的实测里,pgvectorscale 的吞吐是 Qdrant 的 11.4 倍(471.57 vs 41.47 QPS),而 Qdrant 的 p99 又低 48%。单请求要快选 Qdrant,批量要吞吐选 Postgres 扩展路线,这两件事在真实业务里经常同时存在。
-
部署复杂度是最容易被低估的成本:托管(Pinecone / Weaviate Cloud)→ Qdrant 单二进制 → Weaviate → Milvus(K8s + etcd + MinIO)。选 Milvus 换来 320K vectors/s 的索引速度,代价是一整套平台工程能力——国内很多团队买的是”功能最强”,交的是运维账单。
-
先问”要不要专用向量库”:digitalapplied 的判断是 pgvector 足以覆盖约 70% 的实际 AI-agent 负载(10M 以内、Postgres 已是数据平台);主基准也给过类似算术——100M 向量下自建 Qdrant 约 $1,100/月,而 Pinecone 在同等高查询量下约 $12,000/月。先用 pgvector 跑通、让基准数据说话,再谈换库。
原文参考
- Vector Database Benchmarks 2026: Pinecone, Weaviate, Qdrant, and Milvus(IoT Digital Twin PLM,主基准)
- Fastest Vector Database 2026: 6 Benchmarks Compared(ranksquire,封面矩阵来源)
- Pgvector vs. Qdrant(Tiger Data,50M 对比)
- Vector Databases for AI Agents 2026: 8 DBs Compared(digitalapplied)
- Best Vector Databases 2026: Pinecone vs Weaviate vs Milvus vs Chroma(iternal.ai)