LLM量化技术深度对比:GPTQ vs AWQ vs bitsandbytes 2026基准全解析
2026 年,LLM 量化已成为推理成本优化的核心手段。2026 年 1 月的 Jarvis Labs 基准在同一模型(Qwen2.5-32B-Instruct)、同一硬件(单卡 NVIDIA H200)、同一套压测 harness(vLLM)下测完了全部四种 4-bit 格式:Wikitext-2 测困惑度、HumanEval 测代码生成 Pass@1、ShareGPT(200 条提示词、10 并发)测吞吐。
关于配图:原文正文含 3 张图(量化原理示意、四格式对比表、选型决策图),本文引用其中对比表与选型决策图两张,数据表亦按原表整理。
先看结论:格式(format)没那么重要,内核(kernel)才决定速度。同一份 AWQ 权重,vLLM 默认内核跑到 68 tok/s,换成 Marlin 内核就是 741 tok/s——同样的权重、同样的 GPU,10.9 倍差距。
量化方法总览
| 量化方法 | 困惑度(↓) | 代码生成(↑) | 吞吐(tok/s) | 首 token 延迟(ms) |
|---|---|---|---|---|
| Baseline FP16 | 6.56 | 56.1% | 461 | 57.7 |
| AWQ(默认内核) | 6.84 | 51.8% | 68 | 277.8 |
| GPTQ(默认内核) | 6.90 | 46.3% | 276 | 107.1 |
| Marlin-GPTQ | 6.97 | 45.7% | 712 | 51.9 |
| Marlin-AWQ | 6.84 | 51.8% | 741 | 73.5 |
| GGUF Q4_K_M | 6.74 | 51.8% | 93 | 958.0 |
| Bitsandbytes (NF4) | 6.67 | 51.8% | 168 | 135.3 |
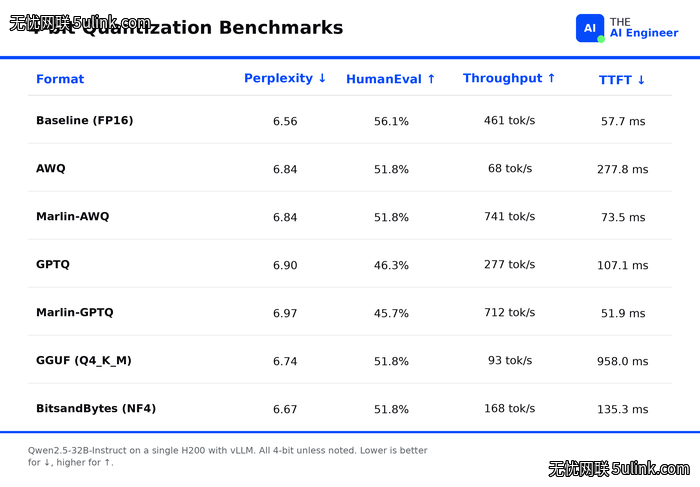
图 1 为原文给出的完整对比表(来源:Jarvis Labs 2026 基准,经 theaiengineer 整理发布)。
关键数据解读
1. 吞吐量王:Marlin-AWQ(741 tok/s)
同一份 AWQ 权重在 H200 上:
- vLLM 默认内核:68 tok/s(甚至慢于 FP16 基线 461 tok/s);
- Marlin 内核:741 tok/s,比 FP16 基线快约 60%,token 间间隔 12.6 ms。
Marlin 的做法是把反量化与矩阵乘法融合成一个内核,避免每次运算都把权重还原成 16-bit;默认内核则每次都要解压,吞吐直接崩掉。同一 checkpoint、同一 GPU,只换一段读取权重的代码。
2. 质量王:bitsandbytes(困惑度 6.67)
- 困惑度 6.67 vs FP16 基线 6.56,仅高约 1.7%;代码生成 51.8%,与 AWQ、GGUF 持平;
- 原因:NF4 把 16 个可用量化值集中在零附近,而 LLM 权重本就集中在零值区域;
- 代价:vLLM 中吞吐只有 168 tok/s(约为 Marlin-AWQ 的 1/4.4),因为格式在每次 forward 时都要反量化回 FP16;
- 附带限制:8-bit bitsandbytes 目前 vLLM 尚不支持。
3. 首 token 延迟:4-bit 可以比 FP16 更快
Marlin-GPTQ 的首 token 延迟 51.9 ms,比 FP16 的 57.7 ms 还低。原因是 FP16 下要搬运 64 GB 权重、4-bit 下只要 16 GB,搬运量小就是延迟低。量化不只是省内存的技巧,在合适的内核上它也是降延迟的技巧。
4. GGUF Q4_K_M:在自己主场才快
- vLLM 内:93 tok/s,首 token 接近 1 秒(958 ms)——vLLM 每次运行都要把 GGUF 的存储布局翻译成自家 GPU 内核能读的格式;
- llama.cpp / Ollama 内:生产级速度(本地、Mac、CPU 的主流选择);
- 质量最好的一位 4-bit 格式之一:6.74 困惑度(优于 AWQ 的 6.84),因为它每个权重矩阵存了更多 scale;
- 免校准:不需要校准提示词,量化更快;
- 有效位宽约 5 bit 以内(Q4_K_M 实为”4.5-bit”),换来更好的局部自适应精度。
5. 内核与硬件门槛
| 项 | 说明 |
|---|---|
| Marlin 支持 | 需要 Turing(2018)代及以后的 NVIDIA GPU;V100、GTX 10 系等更老架构不支持 |
| vLLM 支持 | 支持 AWQ、GPTQ、bitsandbytes、GGUF(GGUF 在 vLLM 内需解包,故很慢) |
| 8-bit bitsandbytes | vLLM 尚未支持 |
选型前必查:先确认 vLLM 版本支持 Marlin、GPU 代次 ≥ Turing,再谈格式。
2026 年选型建议
1. vLLM + NVIDIA GPU → 首选 AWQ
AWQ 在 Marlin 生态里是速度—质量最优解(代码生成 51.8% vs GPTQ 46.3%,因为激活感知的逐列缩放保护了最关键的权重)。原文的判定是:只有当你需要的模型只有 GPTQ 检查点、而没有 AWQ 版本时才选 GPTQ;否则 AWQ 是默认答案。
2. 已经在用 GPTQ → 先换内核,别急着重量化
把 GPTQ 切到 Marlin 内核,吞吐从 276 tok/s 升到 712 tok/s,无需重新量化即可拿到接近 AWQ 的速度。
3. 本地 / CPU / Apple Silicon → GGUF Q4_K_M
GGUF 自带 Intel / AMD / ARM CPU 与 Apple GPU 的原生内核(llama.cpp、Ollama、LM Studio、koboldcpp、jan),且免校准,是本地运行的默认解。
4. bitsandbytes → 原型验证与 QLoRA 微调
运行时动态量化、无需预量化检查点,省掉一步离线流程;代价是吞吐与 8-bit 支持,适合”先把模型跑起来”的阶段。
5. 校准成本别忽略
AWQ 需要校准采样(calibration pass,识别激活幅度最大的约 1% 权重通道并先行放大),GPTQ 同样需要校准集,而 GGUF 完全免校准。要批量出检查点时,校准流水线本身就是一项工程成本。
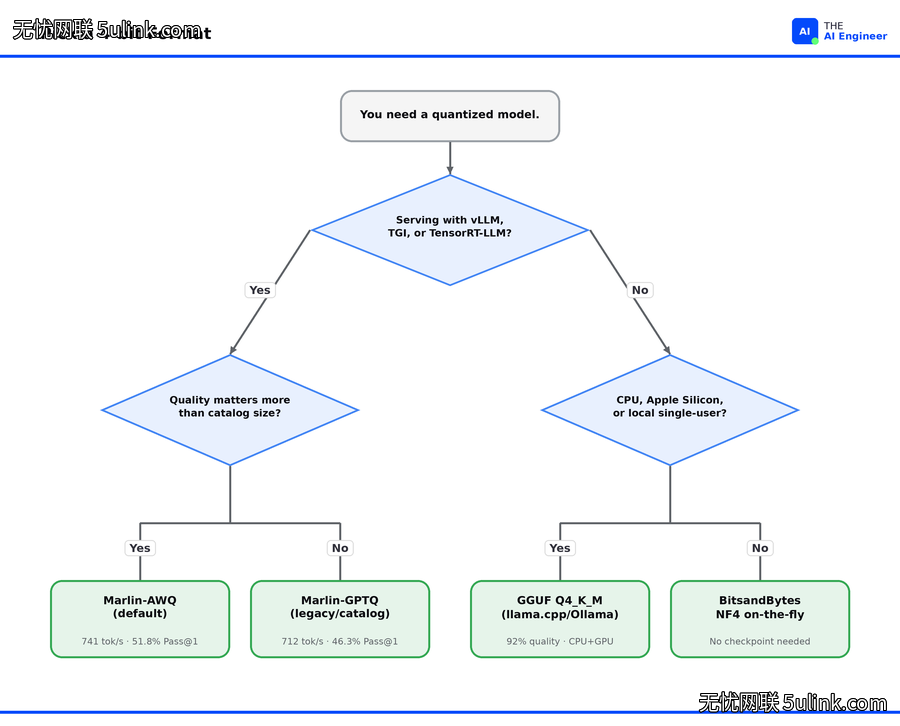
图 2 是原文给出的选型决策图:先看运行环境(NVIDIA/vLLM、消费级本地、CPU/Apple),再看是否已有检查点,最终落到具体格式。
小夏点评
-
Marlin 内核才是采购依据:原文最狠的一句是”格式没那么重要,内核才重要”——同一份 AWQ 权重在默认内核下 68 tok/s、换 Marlin 后 741 tok/s。采购推理 GPU 时,Marlin 支持应当写进选型清单:Turing 代及以后都可用,但要避开 V100、GTX 10 系这类老架构。
-
质量与吞吐的取舍没有”全面最优”:真正最低的困惑度是 bitsandbytes(6.67),但它在 vLLM 里只有 168 tok/s;吞吐最差的其实是 AWQ 默认内核的 68 tok/s 和 GGUF 在 vLLM 里的 93 tok/s。在线服务要走 Marlin-AWQ(741 tok/s)或 Marlin-GPTQ(712 tok/s),离线批处理再谈 bitsandbytes。
-
国内 AI 团队的落地顺序:先问”我的模型有 AWQ 检查点吗”——Qwen 官方为每个 Qwen2.5 版本同步发布 AWQ 检查点,模型方把 AWQ 当作首发级格式,本身就是一种背书;若只有 GPTQ 版本,则切 Marlin 内核而非重新量化。换内核比换格式收益大、风险小。