基准战第二轮:ParadeDB 让 COUNT 和真实搜索重新快起来
上一轮,ParadeDB 把 Top K BM25 性能提升了几个数量级(Part I),并承诺出续集聚焦 COUNT。这篇就是续集。先给结果——同样的 Wikipedia 数据集、同样的基准框架,对比 PlanetScale 旗下 TIN 的原始公告:
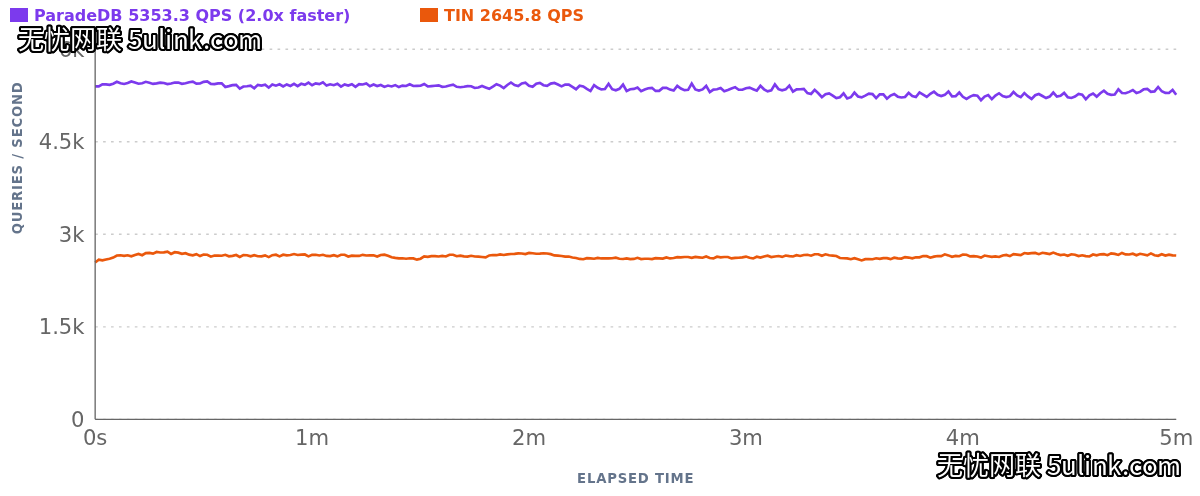
前半篇讲 COUNT 是怎么变快的;后半篇走出”无过滤 BM25 + 简单 COUNT”的舒适区,测试带过滤、带排序的搜索查询——在这些查询形状上,ParadeDB 最快比 TIN 快 66 倍。文章最后还讨论了这对”如何看基准、如何选搜索引擎”意味着什么。
优化一:段分区(Segment Partitioning)
起点是一个简单查询:统计包含 database 的词频(COUNT)。Profile 显示可见性检查占了 80% 以上的页访问——每命中一个文档,都要取回并解码它的 ctid(TIN 可以跳过这步,因为它的文档索引就是 ctid)。
| 数据结构 | 页访问占比 |
|---|---|
| 可见性映射 + 存储的 CTID | 1382 次(81%) |
| 其他全部(postings、元数据等) | 325 次(19%) |
解法来自 ParadeDB 正在开发的”段分区”特性(基于 Spooky LSM 论文):按列值切分段,让每个段的 ctid 范围互不重叠。按 ctid 分区后,每个段的 min/max ctid 可以直接对照可见性映射做预检——不用逐行查。
效果:这条基准查询的可见性相关页访问从 1,382 次降到 30 次。
优化二:把 DocId 映射倒过来存
如果一个段的 ctid 范围里真有需要检查的页(离上次 vacuum 越久越常见),怎么办?原方案是每个文档存一个 ctid、每个命中查一次——数 n 个命中就是 n 次 ctid 查找。
ParadeDB 的改进是把映射倒置:存一列压缩数据,记录”每个 Postgres 页 → 该页上第一个 DocId”。因为段内文档本来就按 ctid 排序,同页文档的 DocId 必然连续,所以只需要对”确实需要检查的页”做范围查询,命中几个查几个。
效果:更新 1,000 行后跑同一条查询,缓冲访问从 7,500+ 次降到不足 400 次,减少 95%。
优化三:高频词用位图
Tantivy 的 posting list 默认用 BP128 编码(128 个文档一组、差值+位打包),对大多数词很好,但对极高频词(稠密 posting)做交集/并集开销很大。于是 ParadeDB 给覆盖超过 10% 文档的词加了位图表示——位运算一次处理 64 个文档,对比逐条走数组。
效果:仅此一项,就把 Wikipedia COUNT 基准的 p99 延迟砍半。
真实搜索长什么样:四种查询形状
TIN 在它优化的形状(BM25 Top K 和 COUNT)上很快。但 ParadeDB 定位是 Postgres 上的 Elasticsearch 替代品——生产环境的搜索远不止这两种形状。Hacker News 数据集实测:
| 查询形状 | ParadeDB | TIN | 差距 |
|---|---|---|---|
| 带过滤的 COUNT(含 database 且 score>10) | 777 QPS | 78 QPS | 10.0x |
| 带过滤的 Top K(BM25 排序) | 820 QPS | 71 QPS | 11.6x |
| Top K 按时间排序 | 378 QPS | 17 QPS | 21.7x |
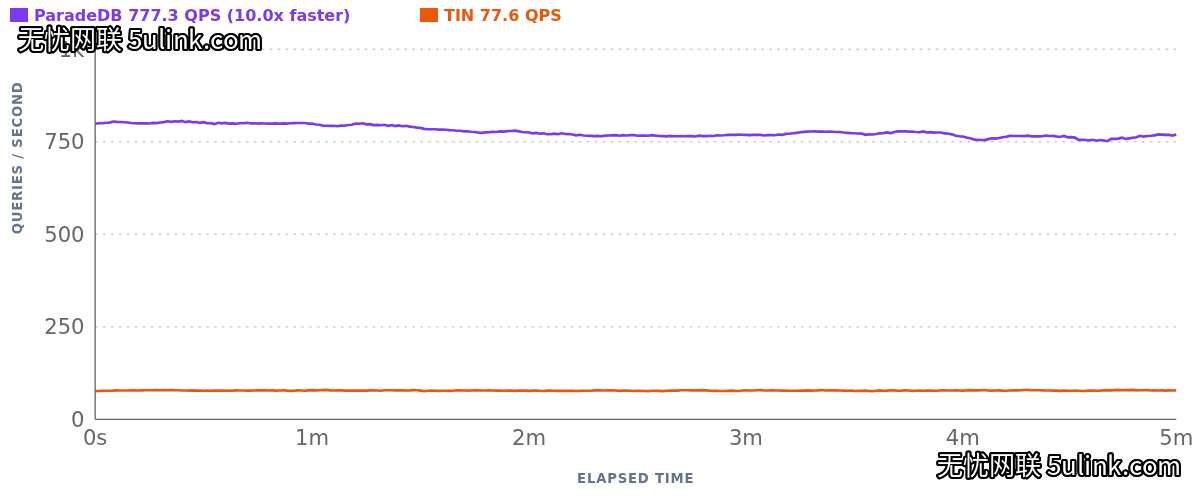
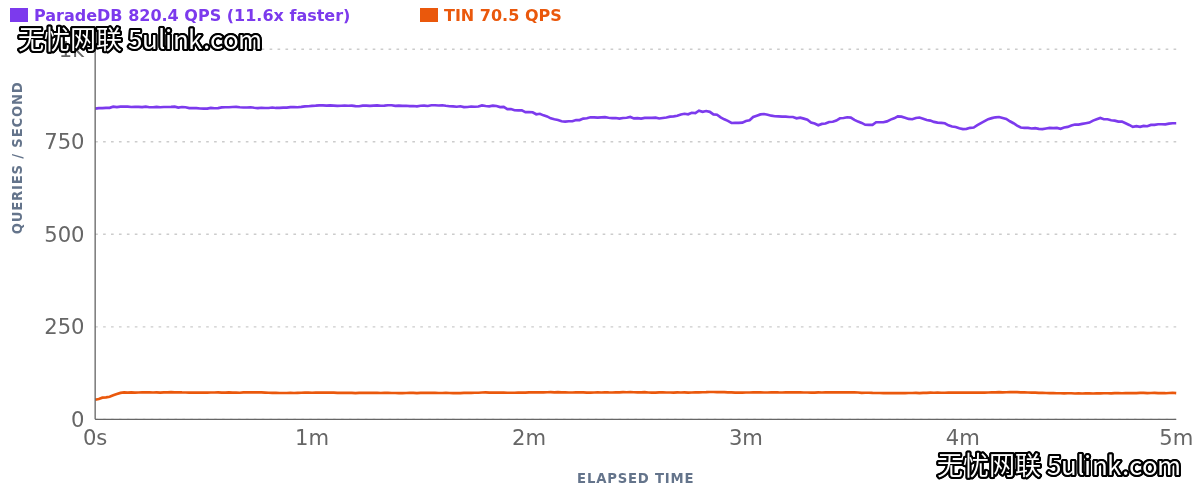
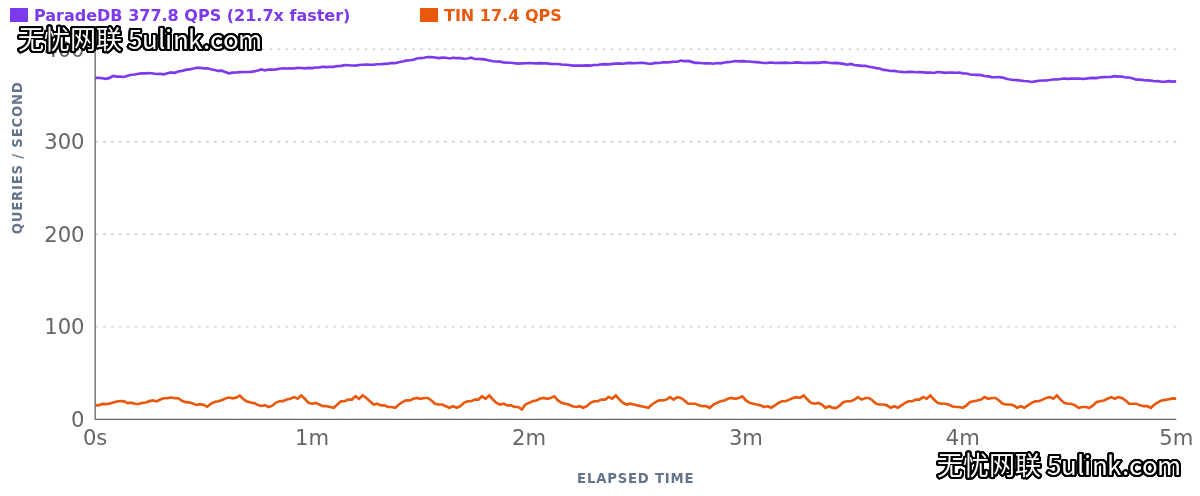
为什么差距这么大?文章认为存在一个根本性的架构差异:查询能下推到索引多少。TIN 是纯文本索引,一个索引只覆盖一个文本列,数值过滤和排序要交给 Postgres 的 B-tree——两边各自独立产出全部匹配再合并,B-tree 不知道哪些文档匹配文本查询,可能白收集几百万条。ParadeDB(和 Elasticsearch 一样)把文本和元数据结构存在同一个索引里、用同一个文档 ID 关联,执行时可以边匹配、边过滤、边排序。
有意思的是,PlanetScale 自己的公告也承认这类查询重要——”一个好的 Postgres 文本索引必须同时支持这些”。只是他们的基准(Wikipedia/StackExchange 单文本列)恰好暴露不出这个差距。
方法论:为什么连自家基准工具都换了
ParadeDB 坦白了基准战背后的技术插曲:他们原本的 benchmarker 工具(基于 k6)做客户端计时,在毫秒级延迟下,网络路径差异会实质改变结果——TIN 被网络延迟”垫高”得比 ParadeDB 多。于是他们改用服务端 PL/pgSQL 计时方案,完全去掉网络开销。
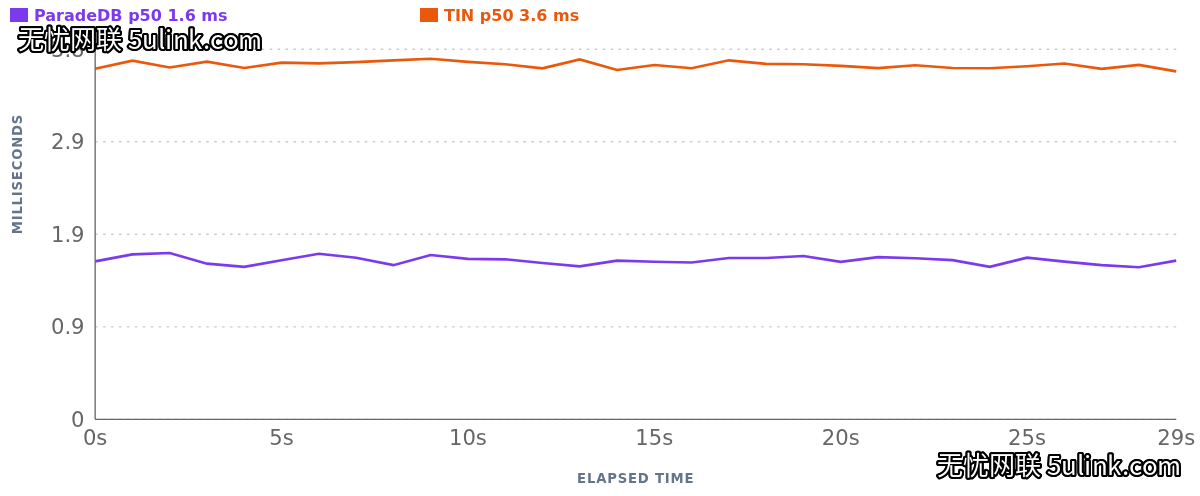
即使换成更公平的方法,最终数字差别不大——但过程值得玩味:客户端视角下 TIN 的 p50 是 3.6ms,服务端公平口径下最终比例几乎没变(2.2x → 2.0x)。文章同时大方承认:这些结果建立在”ParadeDB 设计的、能容纳任意负载的基准工具”上,而 PlanetScale 设计了 TIN 最擅长的基准;任何单一基准都定不了”最快的搜索引擎”,包括这篇自己的。对读者唯一可靠的建议:拿你自己的查询、你自己的数据来测。
小夏点评
- 这篇是”如何读厂商基准”的教科书——工作负载选择决定故事走向,双方都懂;ParadeDB 公开承认自家基准也不能封王,并给出唯一可靠方法(自测),这种姿态在基准战里罕见。
- 三板斧都是可移植的索引工程:LSM 段分区(1382→30)、倒置列存映射(-95% 页访问)、稠密词位图化(p99 砍半)。任何做搜索、分析引擎的团队都能直接抄这三条思路——本质都是”先减少 IO,再谈算法”。
- 对中国 IT 运维/开发者的启示:国内 PostgreSQL 生态体量巨大(PG 系国产数据库、云上 PG 服务众多),生产搜索几乎都是”全文 + 过滤 + 排序”的混合形状,正是文中拉开 10-21 倍差距的场景。选型时别只看标准 BM25 跑分,用自己的数据跑一遍带过滤的 Top K 和按时间排序的查询,差异会自己浮出来。
参考链接
- 原文:https://www.paradedb.com/blog/opening-a-closed-tin-part-2
- 前作(Part I:Top K 优化):https://www.paradedb.com/blog/opening-a-closed-tin
- PlanetScale TIN 公告(本轮论战起点):https://planetscale.com/blog/introducing-tin