PostgreSQL 高写入的隐形天花板:关系扩展锁与分区实战
监控面板一切正常:CPU 占用 35%,磁盘延迟低于 1 毫秒,内存绰绰有余——可写入吞吐就是卡在 3400 TPS 一动不动。这是 EDB 工程师 Vishal Sawale 在 PG Pune 2026 大会分享的基准测试案例:一场高写入负载下的”安静的灾难”,加硬件收益为零,一个配置改动却让同硬件吞吐涨了 7.2 倍。
测试设置:模拟电商大促
工具用 HammerDB 的 TPROC-C 负载(TPC-C 的开源实现,TPC 理事会背书),打原生社区版 PostgreSQL 18。50 个仓库、64 个虚拟用户,全部并发批量插入默认 TPC-C 表(District、Order、Stock、Customer、History),模拟电商高峰的流量形态。基线场景所有写入都进同一个未分区 schema——锁竞争的最坏情况,因为每次写入都要经过同一个文件。
日志里的答案:Lock:extend
负载一上来,会话开始排队,Postgres 日志给出了原因:
LOG: process 71429 still waiting for ExclusiveLock on extension
of relation 20153 of database 20032 after 1000.035 ms
这就是关系扩展锁(relation extension lock)。表在增长时,后端的写入必须追加新页,两个后端绝不能同时认领同一个新块——Postgres 用扩展期间的 ExclusiveLock 把”查表大小、再追加”合并成一个原子步骤,这是保护机制而非缺陷。这条日志平时没人注意,它只在等待超过 deadlock_timeout(默认 1000ms)时才由锁管理器报出来。
虚拟用户从 64 加到 128,客户端翻倍、本以为吞吐小幅回落,结果直接跳水:NOPM 从约 40 万掉到约 5.2 万,超过 75 个后端排在同一个扩展锁后面,单次最长等待 6.7 秒。没崩溃、没丢数据,就是响应变慢、连接池打满——典型的吞吐饱和。
加硬件为什么是零收益
第一反应是堆硬件:更多 vCPU、更快的 NVMe,重跑同一基准。吞吐变化 0%——不是”不明显”,是零。
原因很直白:天花板是软件锁,不是硬件极限。更快的存储只是让每次扩展结束得更早,但所有会话仍然排在同一条队里。硬件规模在这里根本不构成变量,直接换大实例是最贵的错误答案。
解法:分区,同硬件 7.2 倍
第二个场景只改一件事:给最热的表上哈希分区,10 个子分区,把一条长队拆成十条短队。
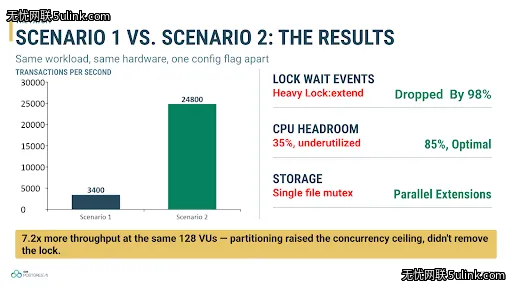
| 指标 | 场景 1(未分区) | 场景 2(分区) |
|---|---|---|
| 锁等待事件 | 大量 Lock:extend | 下降 98% |
| CPU 利用率 | 35%(大量闲置) | 85%(正常水位) |
| 扩展路径 | 单文件互斥 | 并行扩展 |
| 128 VU 吞吐 | 基准 | 7.2 倍 |
注意措辞:分区没有消除锁,它抬高的是并发上限——每个分区有自己的扩展锁,每个写入者排的队短多了。
坑在分区键
10 个分区是配好了,但写入是否真的摊开,取决于分区键。键不只是查询设计的选择题,它还决定每个写入者最终排进哪条队。
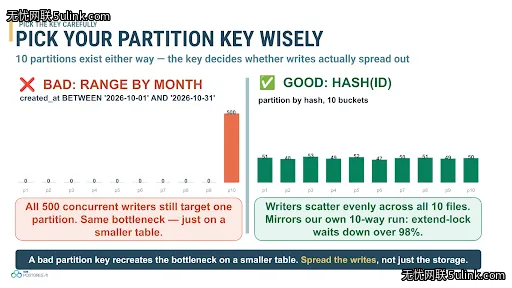
哈希键让写入均匀铺开;选错的 range 键会把写入重新集中到单个分区上,等于换了张小一点的表重演原瓶颈。要摊开的是写入,不只是存储。
跑道模型与自查 SQL
作者的类比:一个文件一把锁,就是一座机场只有一条跑道,所有飞机排队降落;分区相当于加了一条平行跑道,流量没变,但路径平行了。
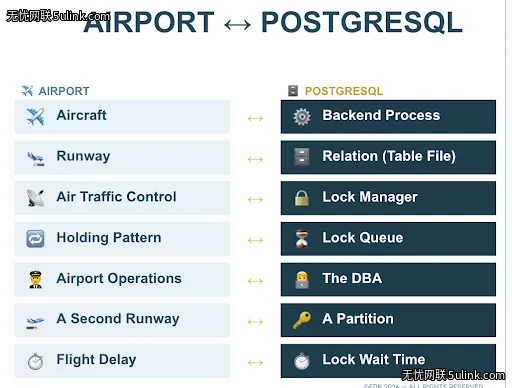
DBA 自查自己有没有表正在”空中排队”,一条 SQL:
SELECT pid, wait_event_type, wait_event, query
FROM pg_stat_activity
WHERE wait_event = 'extend';
有返回行,就说明已经有后端在锁上排队了。
生产意义:安静的停机
这不是崩溃,不是数据损坏,是响应时间问题——在流量最大、写入量最高的时刻最疼。p50 变慢用户会烦,p99 爆炸用户会走。客户在支付、秒杀、抢票页面转圈时,没有任何服务是”down”的,这就是它的危险之处:监控全绿,问题只在最糟的时刻现身。作者补充了两个现场问答:加机器换环境救不了(0% 收益,答案是数据库层的分区);分区可能拖慢跨分区读,但用一点读延迟换写入路径不崩,值得。
小夏点评
- 盯等待事件,别只盯资源指标——这台机器 CPU、磁盘、内存全程”看起来健康”,唯一说真话的是日志里那行 “still waiting for ExclusiveLock”。监控面板应该把
pg_stat_activity的等待事件当一等公民。 - 分区是为并发分的,不只是为了运维清理——多文件=多把锁=并发余量,且分区键决定余量是真是假。哈希键摊写入,糟糕的 range 键会让分区白分。
- 对中国 IT 运维/开发者的启示:电商大促、秒杀、开门红这类”中国式峰值”正是这个瓶颈的触发场景,而国内大量业务库正是”单表+索引分区”的传统用法。把
wait_event = 'extend'纳入大促前巡检清单、给高写入热表评估哈希分区,是一次周二下午就能完成的配置变更——别等它变成黑五故障才被发现。
参考链接
- 原文:https://enterprisedb.com/blog/finding-and-fixing-silent-throughput-ceiling-postgresql