ClickHouse 给 .NET 造了条原生 TCP 快车道:1M 行读取分配从 1.6GB 砍到 6MB
.NET 生态连 ClickHouse 的方式终于不是 HTTP 了。ClickHouse.Driver 现在提供实验性原生 TCP 客户端:直接说 clickhouse-client 和服务器之间跑分布式查询用的那套原生协议,数据全程保持列式 Native 格式。过去 .NET 侧只有 HTTP 一条路,行进列出,两头都要转换;现在这两次转换整段消失。官方给的定调很直接:典型负载下比 HTTP 客户端快 1.5-2 倍。
快在哪:整条链路都按列式重做
ReadOnlySpan。object[] 层每值装箱,收益递减。官方同条发布里的对照数据最能说明问题:读 100 万行,HTTP 客户端 GC 分配 1.6GB,TCP 列式 API 只有 6MB——分配砍掉 99% 以上,GC 暂停直接出局。
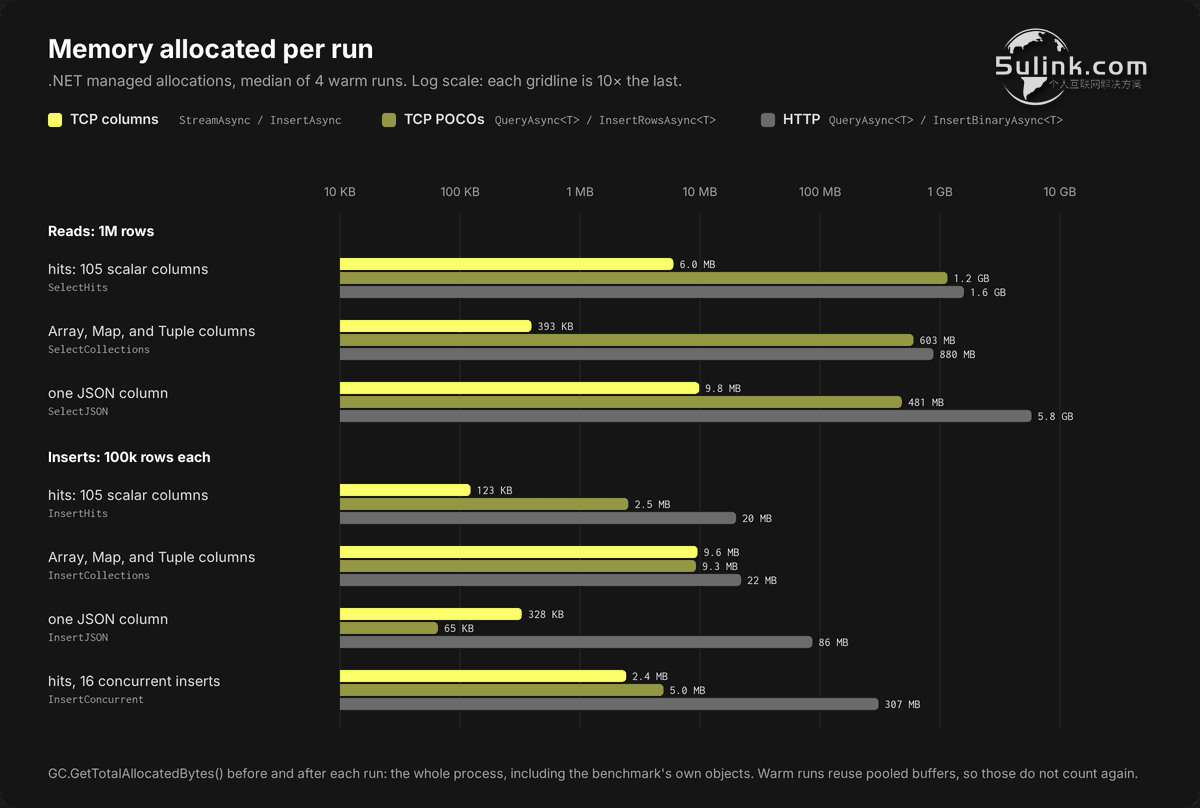
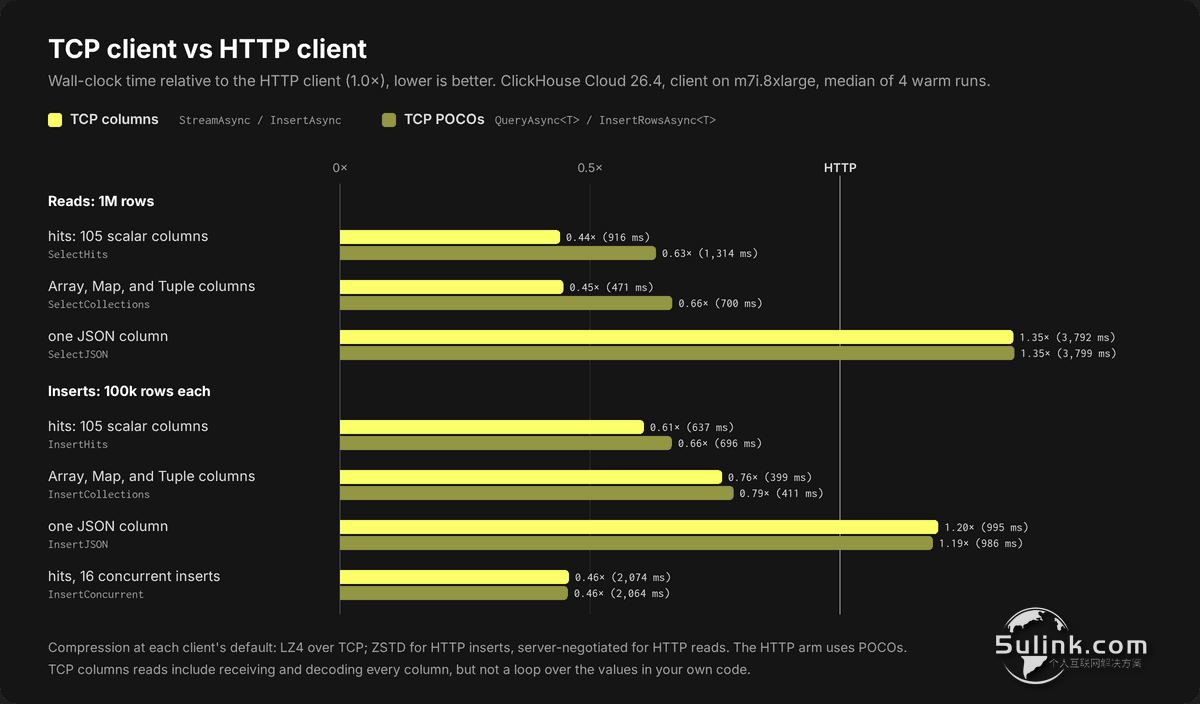
基准:官方对照测试(AWS 客户端 → Cloud 26.4)
耗时口径,越短越好:
| 场景 | HTTP 客户端 | TCP 列式 API | TCP POCO 层 |
|---|---|---|---|
| 1M 行读取(hits,105 列) | 基线 1.00× | **0.44×**(916 ms) | 0.63×(1,314 ms) |
| 10 万行插入(hits) | 基线 1.00× | **0.61×**(617 ms) | 0.66×(696 ms) |
| 16 路并发插入(hits) | 基线 1.00× | **0.46×**(2,074 ms) | 0.46×(2,064 ms) |
客户端在 AWS m7i.8xlarge,服务端在 ClickHouse Cloud 26.4,走真实网络;每场景跑 5 次、取 4 次热跑的中位数。
吞吐口径,越高越好:
| 场景 | HTTP 客户端 | TCP 列式 API | TCP POCO 层 |
|---|---|---|---|
| 单流读 1M 行 hits | 48.6 万行/秒 | **110 万行/秒**(1.15 亿值/秒) | 76.4 万行/秒 |
| 16 路并发插入 | 40.5 万行/秒 | **87.7 万行/秒** | 83.2 万行/秒 |
SELECT 1 小查询(16 路并发) |
1,800 查询/秒 | **3,100 查询/秒** | 3,100 查询/秒 |
唯一的例外是 JSON 列:读取段比 HTTP 慢 35%、插入段慢 20%——JSON 现在只能按文本进出,服务端要多一次序列化。
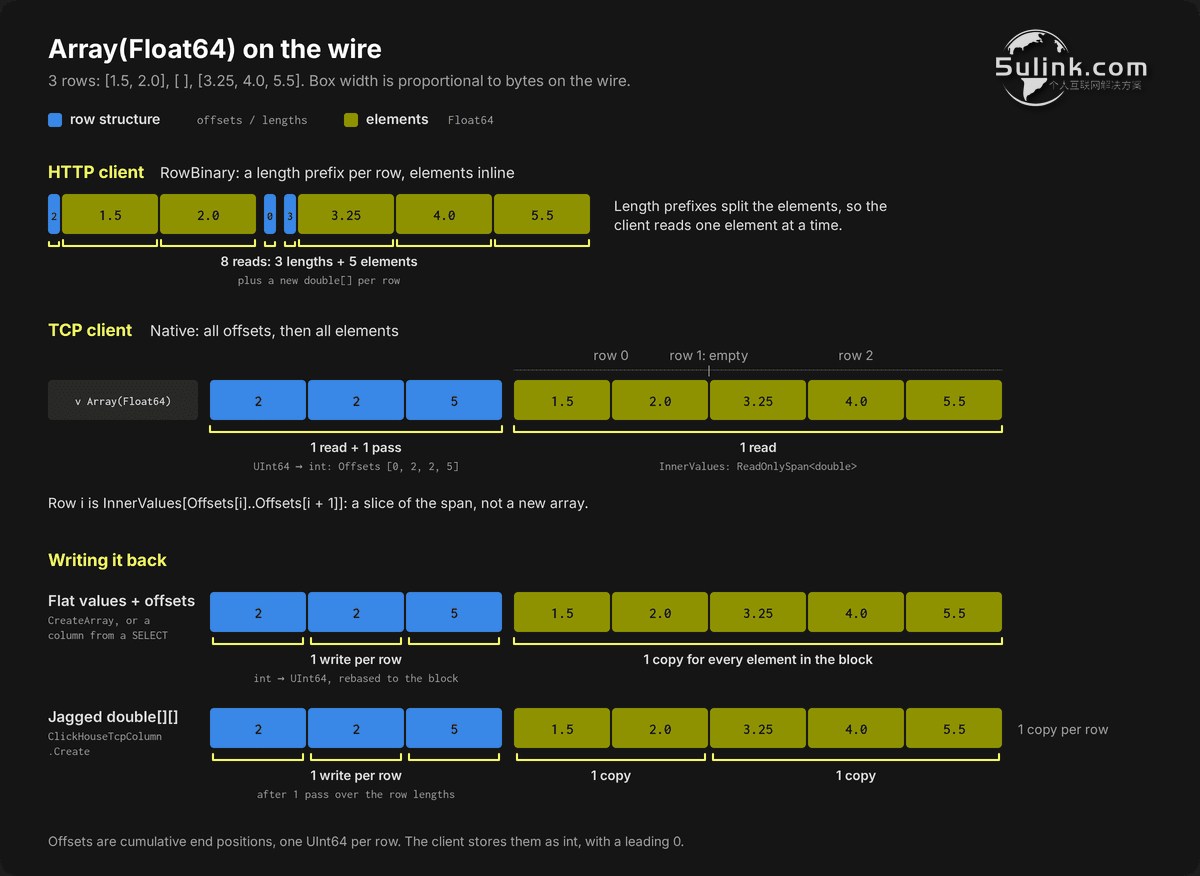
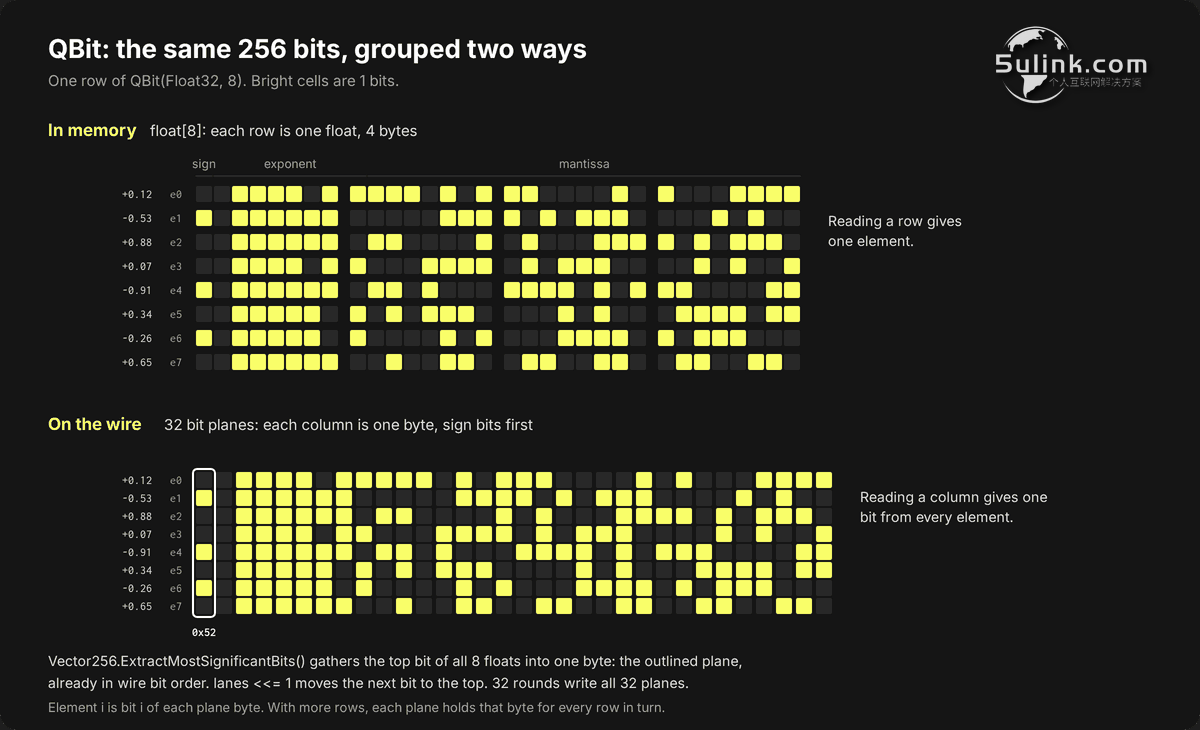
数组、UUID、Nullable 这些复合类型照样直读原生二进制:Array(T) 在线上是「先所有 offsets、再所有 elements」,客户端一次读完整块,一行只是两个 offset 之间的切片;插入时给扁平值 + offsets 就是一次拷贝出去。只有当 wire 布局和 .NET 内存布局对不上时,客户端才动用 SIMD——UUID 靠一条 vpshufb 重排字节,比逐字节搬快约 9 倍;QBit 转置用 ExtractMostSignificantBits 把 8 个浮点的最高位收成一字节(正好是线上的一个位平面),768 维写路径快 16.5 倍、1,024 维快 11.7 倍。
边界:官方自己标了”实验性”
NuGet 装上就警告(CHTCP0001),这不是疏忽,是刻意的。JSON 列按文本处理、DateTime 按数字返回、块数据是借用语义不能存字段、不兼容 Dapper/EF Core 这类 ADO.NET 生态、CSV/Parquet 无、JWT 无、.NET 8 起步。官方建议同样清楚:分析读数、批量写入、性能敏感服务上 TCP;要 ORM、要格式转换、要令牌认证,留在 HTTP。