Agent 分析基准第二轮:GPT-6、Claude Opus 5.5 与 Sonnet 5.5 成绩单
今年 9 月 ClickHouse 发布了 Agentic Analytics Benchmark:29 个模型在合成 ClickHouse 数仓上回答 201 道分析题,全程自己写 SQL、在 Agent 循环里跑。现在第二轮来了——GPT-6 家族(Astra、Luna、Sol)、Claude Opus 5.5 和 Sonnet 5.5 五个新模型上榜,题目、数仓、评审团全部不变。榜单冻结的意义就在于此:新模型只能用同一套题、同一个仓库、同一批裁判加进来。
榜单:头名没动,新玩家挤在中游
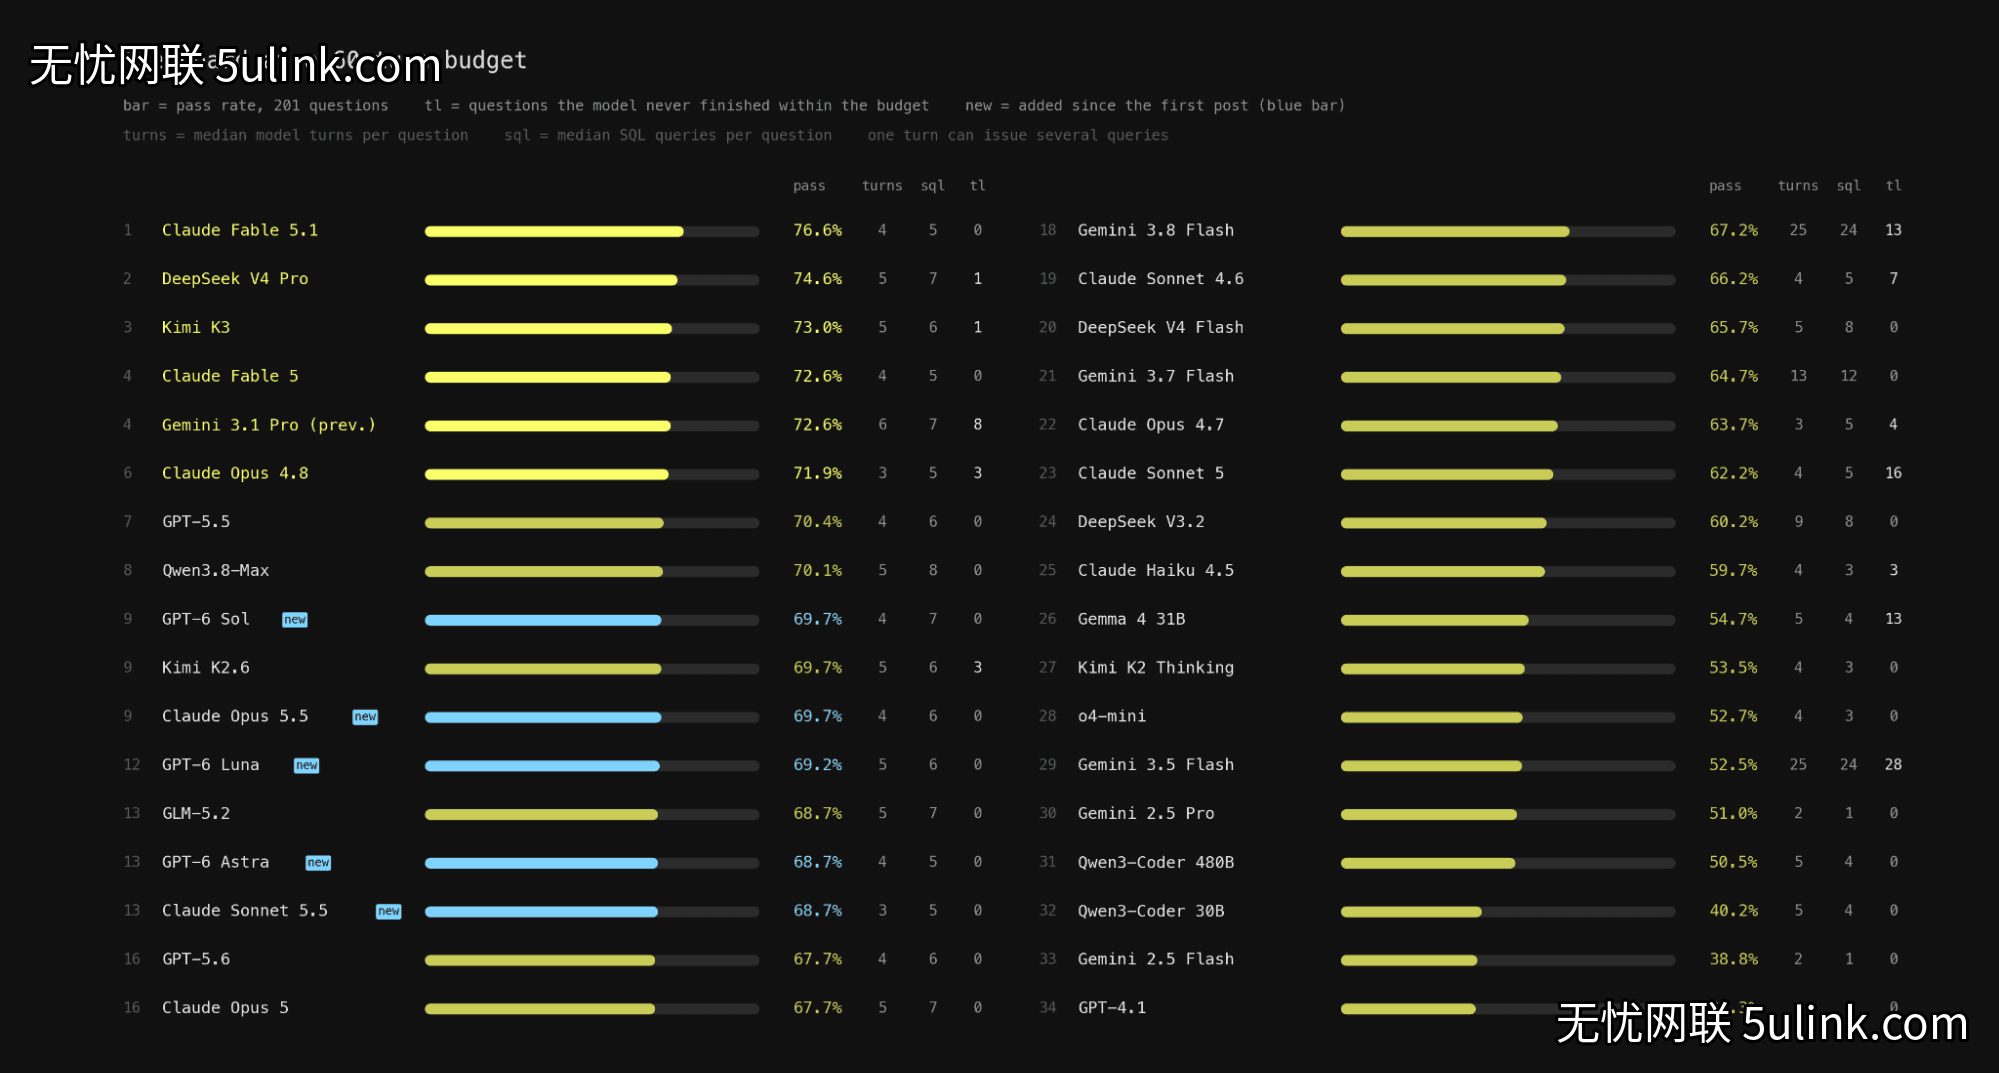
- Claude Fable 5.1 守住第一,76.6%(201 题的 95% 置信区间约 ±6-7 分,亮黄行为统计持平区)
- 五个新模型全部落在 68.7%-69.7% 区间,中游,彼此统计持平,全部进入前 9-15 名
- 没有任何 GPT-6 变体在默认推理强度下超过 GPT-5.5(70.4%),三个变体彼此差距不到 1 分,压着 GPT-5.6(67.7%)
- 五个新模型全部在预算内完成每一题——这在前沿模型里都不是理所当然的事(TL 列即”耗尽 60 轮预算未答出”)
- 污染探针:五个新模型从题目前缀还原匿名实体名全部 0/25,与首轮各模型处于同一低档
GPT-6 支持板上没人跑过的 “xhigh” 推理档,所以”默认档”只是这些行的临时标签,扫档实验还在路上。
基准本身升级了什么
harness 已开源(Apache 2.0),首轮至今的改动值得抄作业:引擎与 timezone 钉死(曾有一次静默的引擎升级翻转了一题的标准答案,这正是可复现基准存在的意义);凭据预检(裁判凭据失效要在第一笔付费调用前拦停整轮,而不是逐题悄悄降分);数值容差改为配置项;宽结果集的列映射修复;用多面 Rasch 模型给裁判投票算能力值与严格度;LibreChat runner 上同一模型产品内得分 69.7% 对直跑 66.2%,噪声内。
本轮真正的看点:Sonnet 5.5
准确率只挪了一点,其他所有指标都在大幅移动:
| 指标 | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| 通过率 | 62.2% | 68.7%(+6.5 分,本轮最大代际步) |
| 同题对打 | 赢 31 / 输 18(净 +13,p≈0.09,方向性提示、未达显著) | — |
| 耗尽 60 轮预算 | 16 题 | 0 题 |
| 每题平均轮数 | 9.1 | 3.5 |
| 每题中位耗时 | 26 秒 | 13.7 秒 |
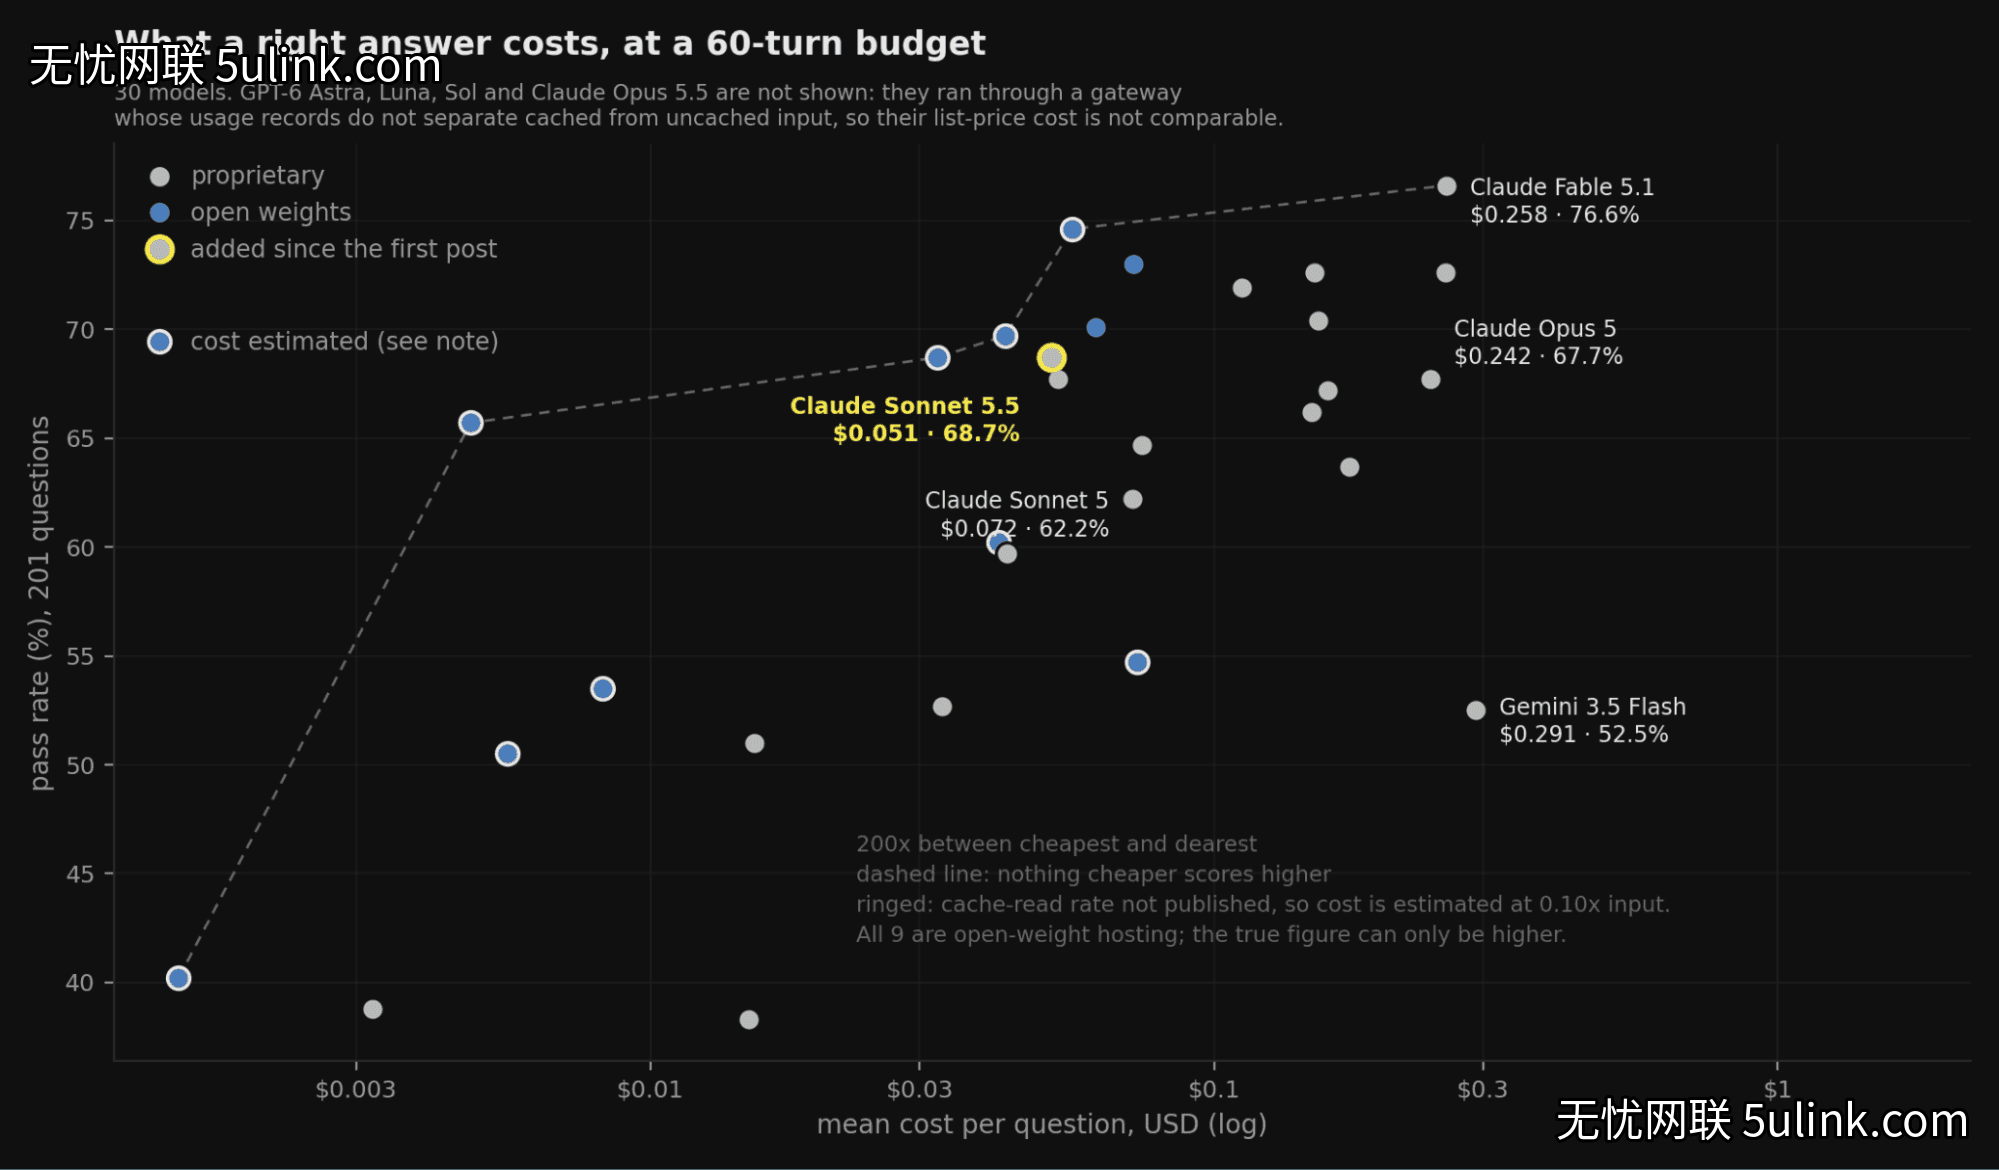
| 整轮成本(标价) | $14.40 | $10.39(约 5 美分/题) |
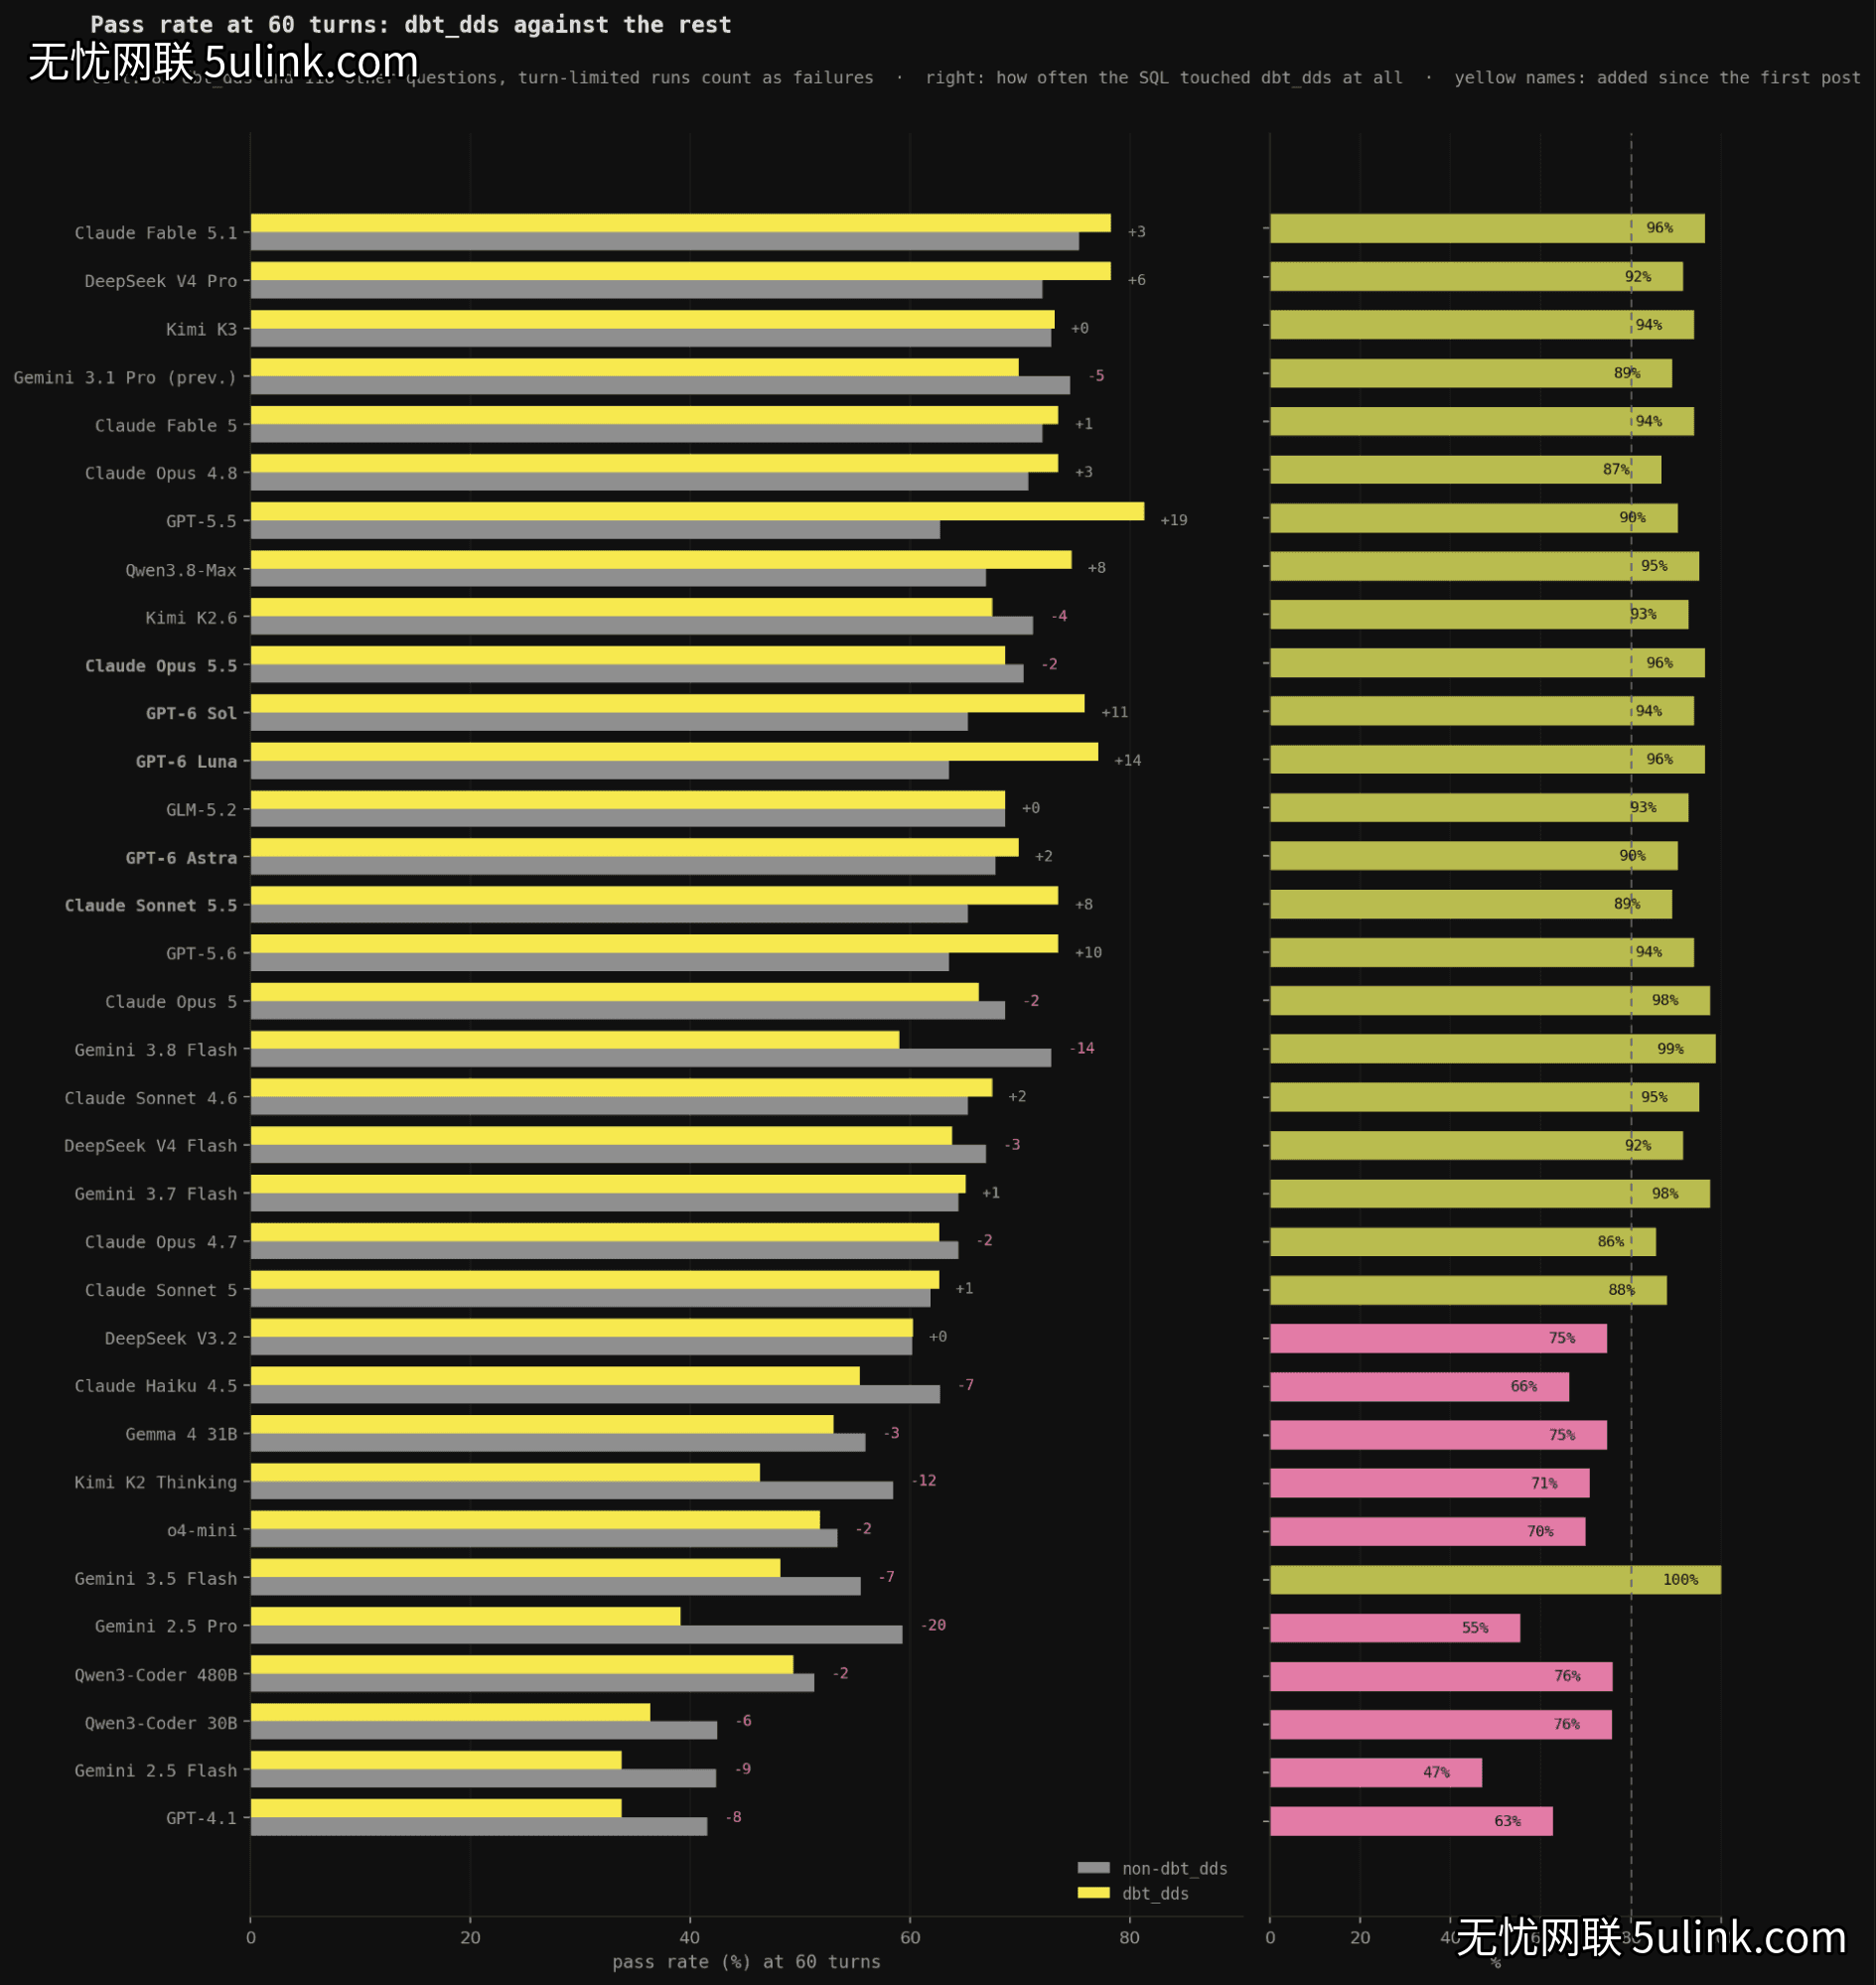
增益的位置很清楚:需要维度 CRM 层的 83 道多跳题上,Sonnet 5 拿 62.7%,5.5 拿 73.5%;其余题 61.9% 对 65.3%。而且不是”更会找表”——两代模型发现维度层的比例都约 89%,是用表用得更好。
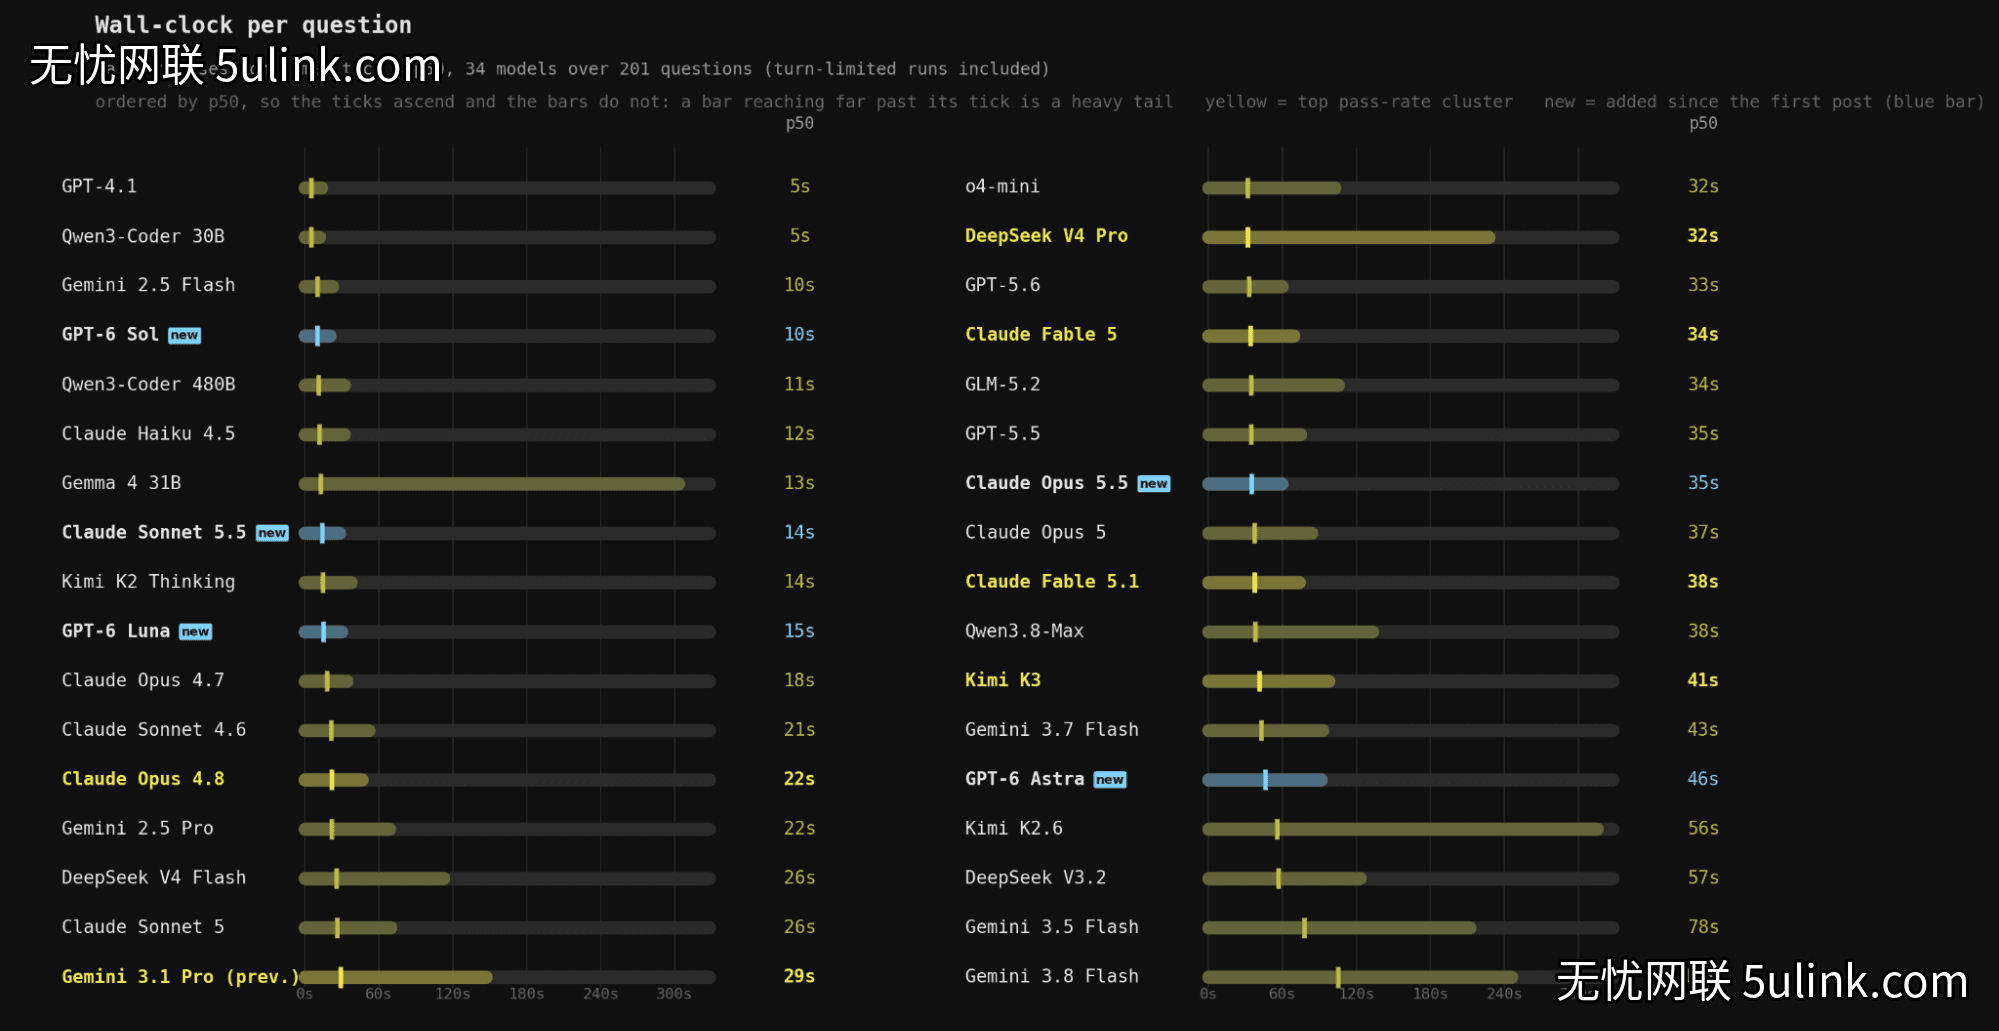
失败形状与成本:两条老结论依然成立
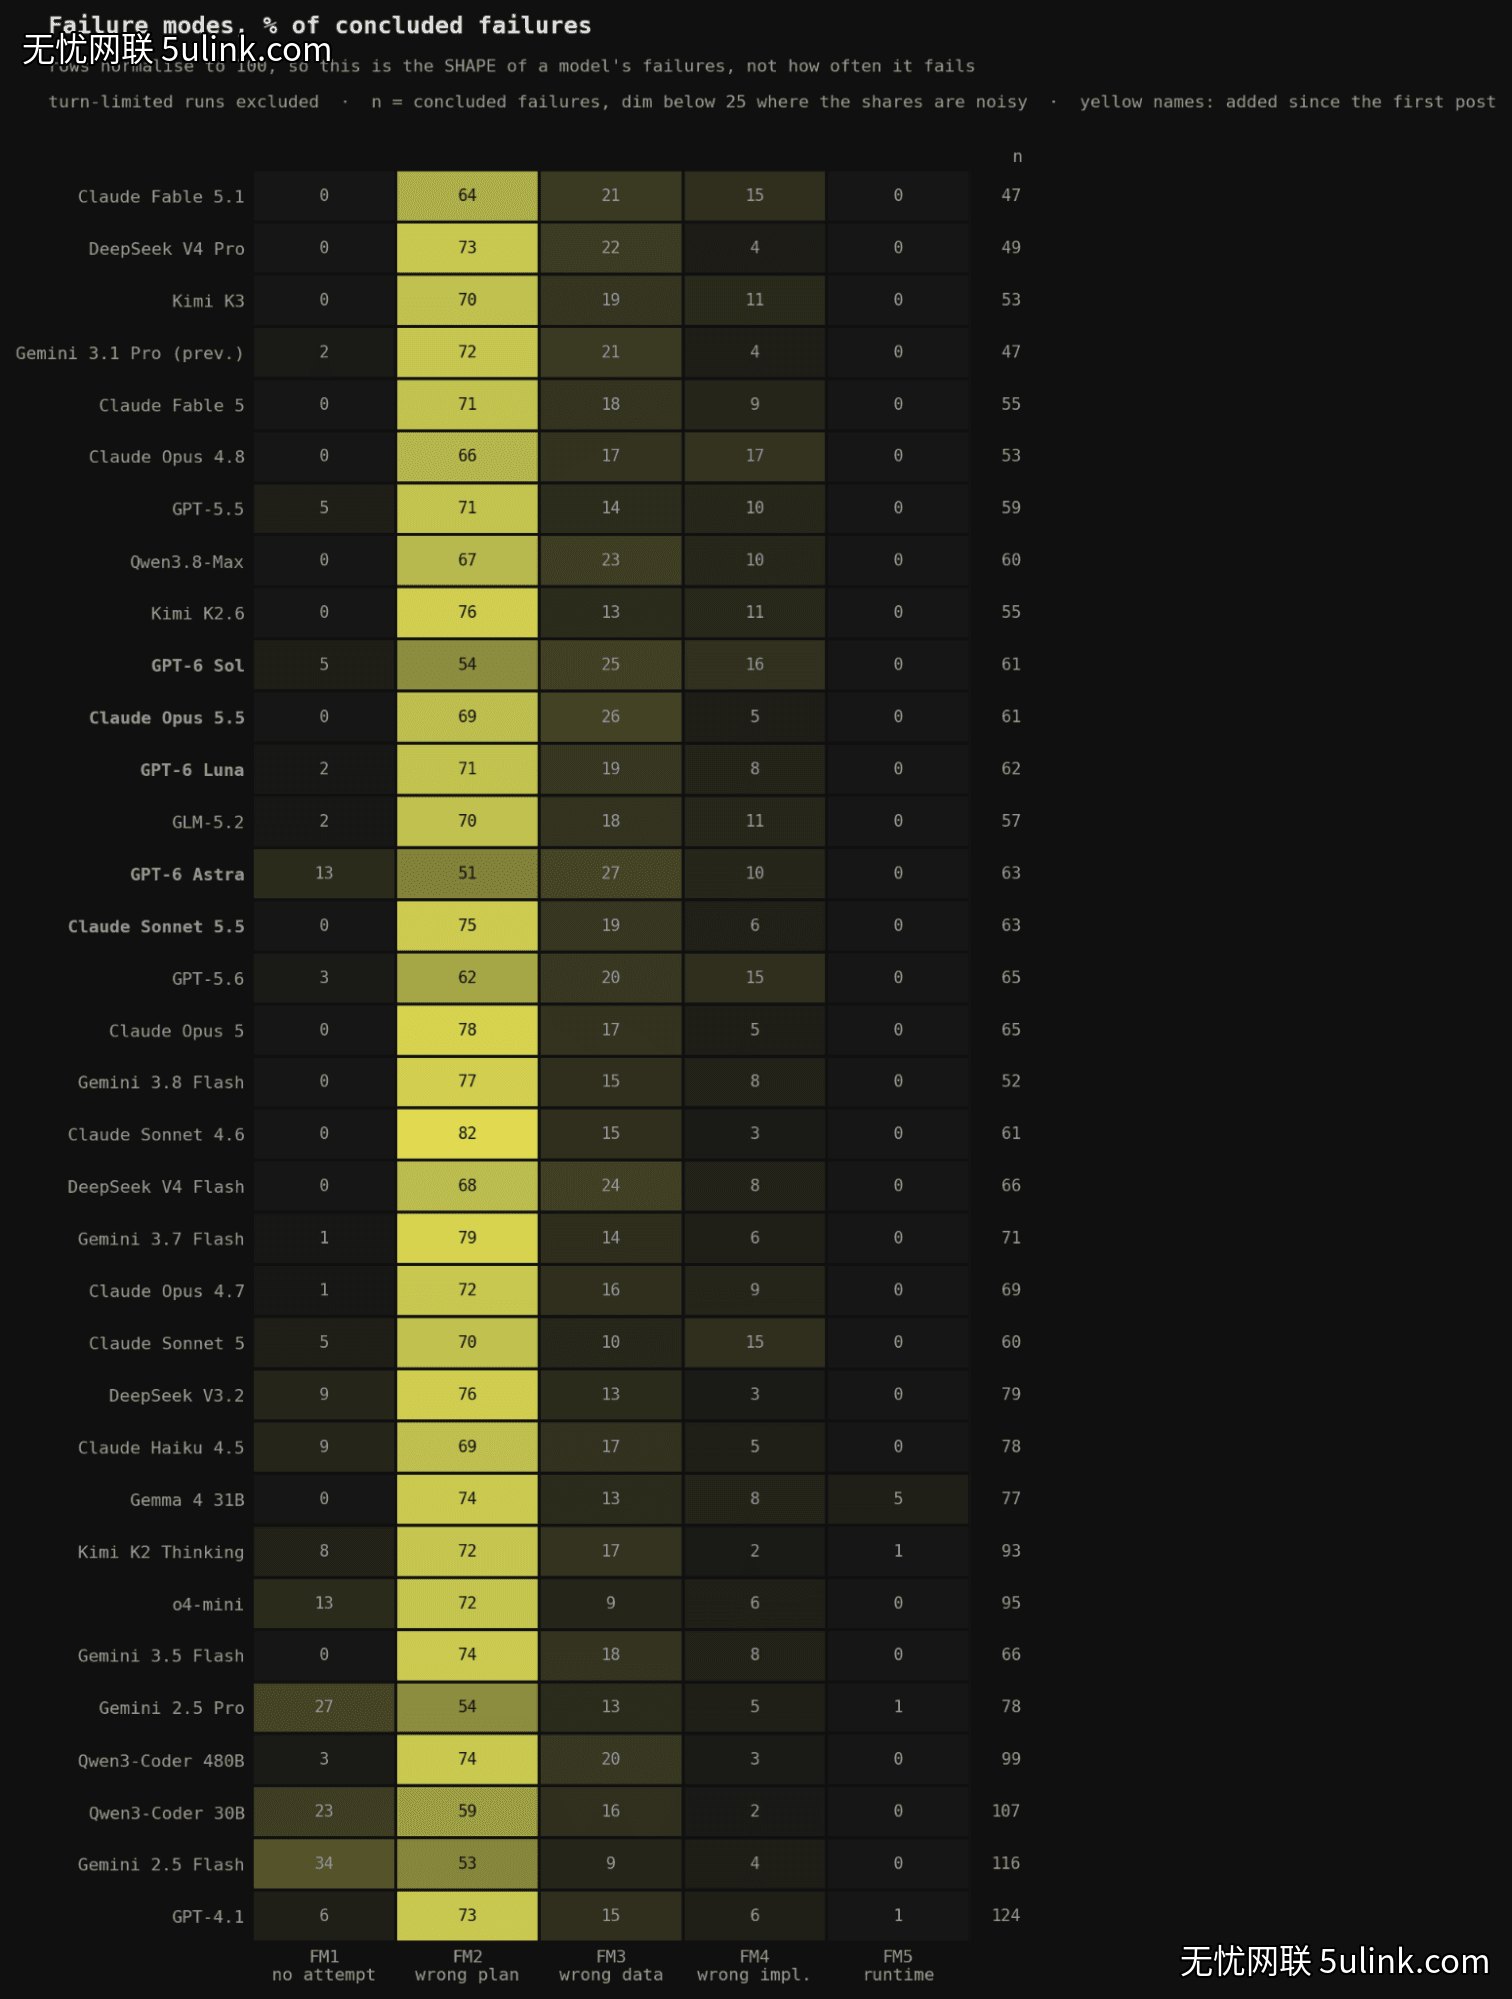
规划仍是第一失败模式。 五个新模型的失败里 wrong plan 全部是最大桶(51%-75%),运行时错误为零,Sonnet 5.5 的 63 次失败中 75% 是规划错误、19% 选错数据、6% 实现错误。SQL 执行对这类模型已经是 solved problem,剩下的全是”决定算什么”。
头部集团内部价格仍差 8 倍,中游在追平。 首轮规律是”家族里便宜的那个座位会跑爆预算”(Sonnet 5 爆 16 题、Gemini 3.5 Flash 爆 28 题),Sonnet 5.5 打破了它:整轮成本约为 Opus 5 的五分之一,零截断,得分只差 1 分。
在自己仓库上跑一遍
结论和首轮一样,且更硬了:要选模型,就把基准在自己数据上跑一遍。头条分数几乎没动,真正变化的是轮数、成本、截断这些榜单数字藏不住的属性。你的仓库会有自己的”分水岭题”——ClickHouse 的是维度建模层,你的可能是缓变维度、半结构化事件表,或者没人写下来的命名规范。
小夏点评
- 榜单没动,动的全在榜单下面——五个新模型挤在同一统计持平带,头部无变化;真正值得抄的是 Sonnet 5.5 的效率曲线:0 截断、3.5 轮、5 美分/题,”便宜座位跑爆预算”的旧规律被打破,生产选型逻辑要重算。
- 规划能力是共同天花板——所有新模型失败最大桶都是 wrong plan、运行时错误为零,意味着 Agent 产品的提升空间在”任务分解与查数路径设计”,不在 SQL 生成,也不在数据库。
- 对中国 IT 运维/开发者的启示:国内团队做 ChatBI/数据 Agent 时普遍按”哪家模型分数高用哪家”选型,但这个基准说明同带模型统计不可区分、成本差 8 倍——正确姿势是拿自己的 schema 和问题集跑冻结 harness(已开源,加模型只是一条注册记录),把”你的仓库的分水岭题”找出来,再按轮数与单题成本定档,而不是盯着排行榜的头条数字。
参考链接
- 原文:https://clickhouse.com/blog/agentic-analytics-benchmark-round-two
- 首轮基准:https://clickhouse.com/blog/agentic-analytics-benchmark
- Harness:https://github.com/ClickHouse/data-agent-mnist