Agent 可以挂掉,工作不能丢:AI Agent 可替换性的最小工程实现
从一笔退款开始的问题
Agent 拿到审批,要处理一笔部分退款。请求发给支付 API,进程崩了。也许支付服务那边退款已经完成,也许请求根本没出去。接替者启动,看到一条状态停在 dispatched(已派发)的操作记录,没有写下结果。
这种歧义不是 Agent 独有的——任何在”变更中途”崩掉的分布式 worker 都会遇到。但传统 worker 从检查点恢复预定流程就行,Agent 做的事更危险:它自己推理。拿着同样的客户请求、没有结果记录,它可能想出另一个方案、换一组参数,或者决定”再退一次款”而不是继续那笔已批准的。
如果原来那笔其实成功了,第二次尝试就会退两次——余额还够再退一部分,什么都拦不住它。
原文的结论一句话:接替者必须继承原来的操作,而不是重新解释它。
操作必须活得比 Agent 久
Agent 的进程、内存变量、推理上下文,全都可以丢弃;业务操作不行——退款本身、它的审批、参数、当前状态。要求:任何关键状态都不能依赖”原执行活着”这件事。
所以在派发退款之前,应用要先把一条持久操作记录提交进事务存储。记录里包括:批准的金额、适用的授权、应用发给支付方的幂等键、应用在对方元数据里的操作标识符,以及一个状态。状态机是 created → dispatched → confirmed / failed,其中 confirmed/failed 只在拿到支付方响应后才写入。
Agent 崩了,接替者取回这条记录和它的关联标识符。停在 dispatched 的记录意味着:调用发出去了,但结果从没写下。接替者继承已批准的操作,不重新生成它;需要核实结果时,拿原始 charge 去 list refunds,在返回的元数据里匹配操作标识符。
关键是持久记录不只是接替者的参考资料——应用在工具边界强制执行它:派发层拿每条出站请求对照已提交的记录做校验。模型可以提议下一步,但只有带着原始参数和身份的已授权操作能到达支付方。模型不能重新定义”批准过什么”。
一套架构:业务数据、遥测、trace 进同一个库
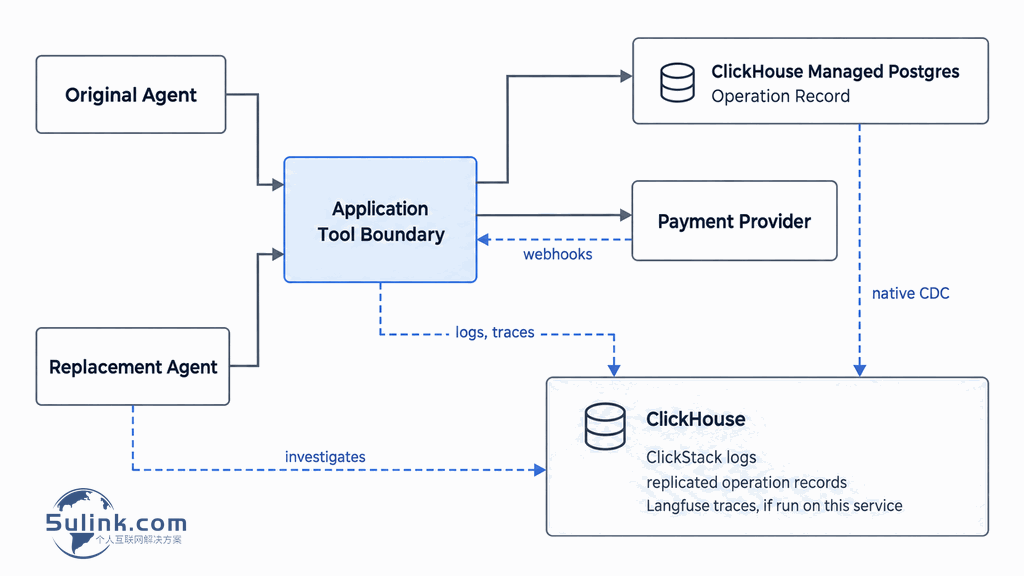
图:ClickHouse Managed Postgres 持有业务数据和权威操作记录,原生 CDC 复制进 ClickHouse;ClickStack 收应用遥测、Langfuse 收 Agent trace,两者后端是同一个 ClickHouse 服务(图源:原文架构图)
把一笔操作和”哪个 Agent run 派发了它 + 那次失败的 HTTP 调用”串起来,在原文的架构里是单标识符查询,不是跨三个工具的对账——因为业务数据、应用遥测、Agent trace 落在同一个库里。
但原文强调两个前提,都是踩过坑的:
重启执行 ≠ 安全接手
LangGraph、Temporal 这类 durable execution 框架能记录执行进度、失败后恢复,也都建议把副作用做成幂等——因为恢复本身解决不了副作用歧义。如果退款在步骤还挂着的时候就已经完成,框架能让 Agent 重启,但它说不出”支付方到底提交了没有”。持久操作记录做的事,就是把那条幂等建议落到一个”下一步不固定”的 Agent 上。
接替者拿记录里的幂等键重试,支付方就能认出这是同一个操作,而不是独立的新退款——即使原 Agent 的在途请求在崩溃后才完成、或者”已判死”的 worker 其实还活着。AWS 的 Builders’ Library 把这个模式写成了规范:调用方提供的标识符,与变更原子地一起记录。
但重试不总是安全,结果可能始终不明——Stripe 文档写明:mutation 收到 500,外部效果照样可能发生。结果不明时,接替者需要证据:Langfuse MCP server 让它按操作 ID 查上一个 Agent 的 trace(退款请求带着记录的幂等键派发出去了);ClickStack MCP server 让它搜同一时间窗的服务事件(出站 HTTP 请求 + 随后的连接失败,收窄失败窗口)。注意只给接替者读工具——它能缩小”发生了什么”,但”能做什么”仍由工具边界控制。而且 trace 证明不了支付方提交了,缺失的 trace 也证明不了请求没发出——Langfuse 异步上报,崩溃可能让 trace 根本没送达。外部结果的权威来源只有支付方本身,执行遥测只能缩小调查范围。
继续工作,不要重新开始
接替者现在有持久记录、有(结果不明时的)执行证据,接下来按应用定义的恢复协议行动,而不是按自己对客户处境的判断:
即使外部结果确定了,还要验证世界没有变:可退余额可能变了、客服可能从别的界面退过一笔、账户状态可能变了、原始授权可能被人撤了。原文那句话值得抄进设计文档:“存储里的批准是历史证据,不是当下行动的依据。”
真正的工程问题是:一个新 Agent 能否确立工作的当前状态、未了义务、不确定影响,然后安全地继续——而不把前任的记忆当作权威。
Agent 是可弃的。工作不是。