“DuckDB 2.0 大版本发布:嵌入式数据库开始当服务器,异步 I/O 把读取吞吐拉满”
DuckDB 团队在 2026 年 10 月 21 日发布了 DuckDB 2.0.0 LTS,代号 Cinnamon Teal(桂红鸭,北美西部的一种红褐色水鸟)。官方自己的定性很直接:这是 DuckDB 迄今最大的一次功能发布,从 1.5 版本开始累计了接近 20,000 条提交,端出来的是打磨过的 Quack 网络协议、异步 I/O、正式化的 VARIANT 类型、agent 模式、触发器、可扩展的 SQL 解析器。如果说 DuckDB 1.0 那次大版本的口号是”稳定与兼容”,那 2.0 的口号就是不加功能不罢休。
对国内做数据平台、可观测、离线跑数和 lakehouse 的团队来说,这条版本线值得重新评估:一个原本只在你进程里跑的嵌入式分析引擎,现在正经开始做服务器、做网络协议、做给 AI agent 用的接口了。
LTS 支持周期:三条版本线同时在跑
| 版本线 | 支持到 | 说明 |
|---|---|---|
| DuckDB 2.0 | 至少 2027 年 10 月 | 本次发布,LTS |
| DuckDB 1.5 | 2027 年 3 月 | 支持期延长,官方原话是”实际上也被当作 LTS 对待” |
| DuckDB 1.4 | 2026 年 11 月 17 日 | 上一条 LTS,即将到期 |
需要选型决策的注意两件事。第一,存储格式是最容易翻车的地方:2.0 之前的版本读不了 2.0 创建的数据库文件;反方向没问题,2.0 可以读写现有文件,这些文件也仍然能被老版本读取。第二,官方的迁移建议写得很明确——复杂架构先在影子环境上跑一遍 2.0.0 再切生产,关键业务等 11 月的第一个补丁版本。
DuckDB 开始当服务器:Quack 协议和 CONNECT
DuckDB 从第一天起就是进程内数据库。今年 5 月发布的 1.5.3 引入了 Quack 协议和 quack 扩展,让任何一个 DuckDB 进程都能把自己的数据库直接服务出去,跑标准客户端-服务器架构。2.0 把这个协议打磨到位:官方说法是性能稳定性都有明显进步,同时新增了 CONNECT 语句——一条命令完成”挂载远端数据库并切换过去”:
-- 服务端
CALL quack_serve(token = 'my_token');

-- 客户端
ATTACH 'quack:localhost' AS qk (TOKEN 'my_token');
CONNECT qk;
SELECT * FROM events;
CLI 也配了快捷开关:duckdb -serve 起服务,duckdb -connect 直连。安全默认值偏保守:服务端默认只监听 localhost,需要跨机器访问就放到 TLS 终止的反向代理后面;allow_other_hostname 选项只用于测试环境,不适合生产。
CONNECT 也不是只服务 Quack——任何支持它的远端数据库都可以切过去,包括 PostgreSQL 和 MySQL。配套的远端下推优化器(remote pushdown)会把查询直接交给远端执行,而不是把整张表拖过网线。对”湖仓 + 业务库”混合部署来说,这是整条链路里最实用的能力。
异步 I/O:对象存储上的速度完全变了量级
2.0 为 Parquet、CSV 以及 DuckDB 原生存储格式引入异步 I/O:I/O 层不再跟着查询执行层节奏走,而是在后台自己发起读取、同时保持多个请求在飞,并且配套了读前队列(read-ahead)和内存治理机制。官方设计文里的实现细节值得记:两套独立线程池,常规 worker 池默认每 CPU 线程一个,异步池默认 4 倍于系统线程数、上限 256;读前队列按批次顺序排队,谁有空位谁补任务,读取任务提前排进异步池,解码线程不用干等。
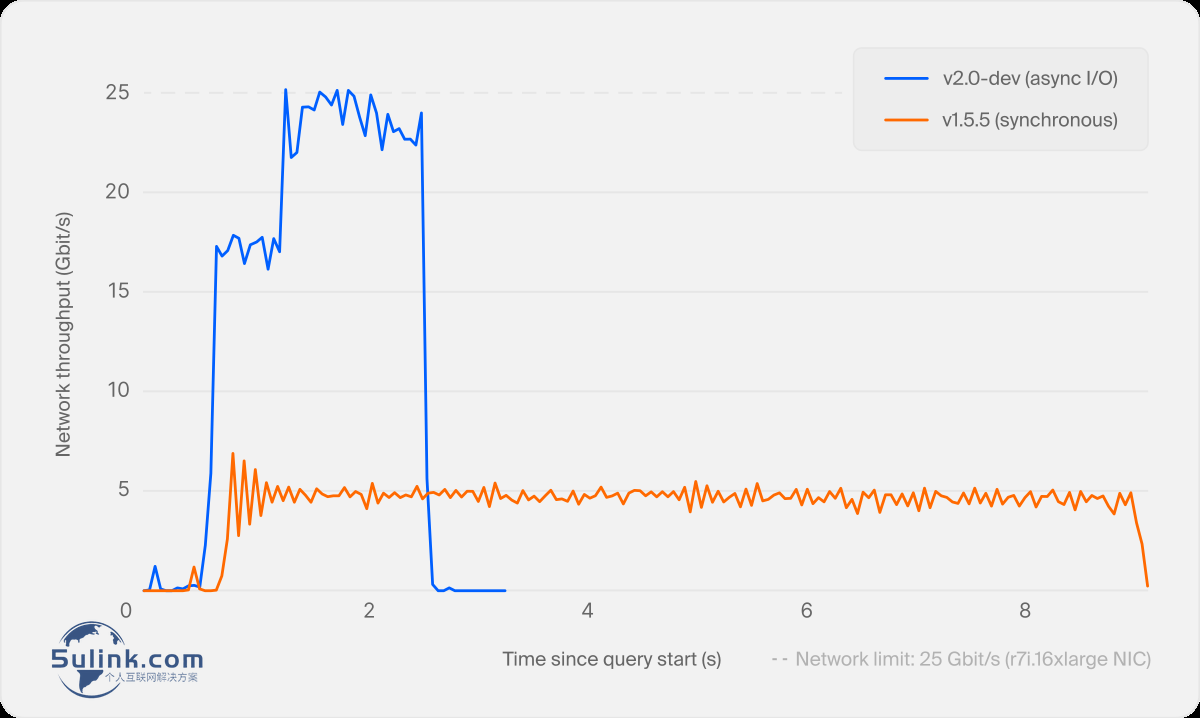
这条曲线的口径要记清楚:TPC-H Query 6(SF100),数据在 S3,跑在 r7i.16xlarge(64 vCPU、512 GB 内存)上,机器和 bucket 同区域,关闭外部文件缓存、每次执行都直读 S3,跑五次取平均。图上的参考线就是这台机器的 25 Gbit/s 网线。
| 场景 | v1.5.5(同步 I/O) | v2.0.0-dev(异步 I/O) | 提速 |
|---|---|---|---|
| Parquet 单文件(约 22 GB,4,880 个 row group) | 8.230 s | 2.844 s | 约 3 倍 |
Parquet 单文件 + 按机器调优(read-ahead 限 64、async_threads=48) |
— | 2.227 s | 比未调优再快 21.7%,约 3.7 倍 |
| Parquet 拆成 976 个小文件(约 22 MB/个) | 9.344 s | 2.945 s | 约 3 倍 |
| CSV(80.89 GB) | 877.563 s | 45.264 s | 约 20 倍 |
| 四条查询并发(Q1/Q6/Q9/Q18,默认内存) | 35.8 s | 15.6 s | 一半不到 |
| 本地冷读(MacBook Pro M4 Max,清缓存) | 1.321 s | 0.883 s | 约 1.5 倍 |
并发那一行最能说明问题:默认内存配置下,1.5.5 平均只有约 6 个核在忙——在 64 vCPU 的机器上,等于九成的算力在等 S3 返回;2.0.0-dev 平均 48 核在忙、峰值打满 64 核,峰值带宽从 10.7 Gbit/s 提到 24.9 Gbit/s。代价是峰值内存从 14.5 GB 涨到 20.1 GB:读得快的前提是内存兜得住。内存压到 16 GB 和 8 GB 时,内存治理会自动收窄读前队列,耗时增加但仍显著快于 1.5.5。
结论官方写得很诚实:异步 I/O 的主战场是远端存储。本地 SSD 冷读收益约 1.5 倍,热缓存基本没差别。所以如果你的数据一直在本地 NVMe、单机跑小表,2.0 的感知不会太强;数据在 S3/OSS 上的场景才是换引擎的理由。
VARIANT 成为正式公民:官方比喻是”加强版 JSON”
VARIANT 用来存半结构化、没有固定 schema 的数据(本质就是 JSON),但保留列式执行的性能。官方原话是”JSON on steroids“:同一列每一行的形状都可以不一样,但它不是文本格式。1.5 引入了 VARIANT,2.0 把整条链路打通——引擎会识别数据中的公共结构并做”shred(拆解)“以压缩和加速,从存储层开始就以拆解形态执行,Parquet 的读写也支持拆解形态的 VARIANT,配套一整组 variant_* 函数。
实际意义:半结构化日志、埋点、事件流不用再为了查询性能先拍平成宽表,也不用整列解析 JSON 字符串。
Agent 模式:CLI 认出了”我在被 AI 调用”
2.0 里最有时代感的一条改动。Claude Code、Codex、Cursor 这类编码 agent 现在大量通过 CLI 驱动 DuckDB,而默认 CLI 输出是给人类看的,对模型来说太啰嗦。于是 CLI 现在能检测”正在被 agent 调用”,自动切到 agent 模式:输出紧凑的 Markdown 表格而不是对齐方框,结果被截断会明确说明,会提前掐掉跑飞的查询,报错按 JSON 返回,长时间运行的查询会先给预估成本、让 agent 自己决定要不要等。官方在 TPC-H 上做了对照实验:agent 模式下模型需要读取的 DuckDB 输出减少了 59%。手动测试可用 -agent 强制开启,agent 侧也可以用 -no-agent 关掉。
给 agent 喂更小的数据块也是同一条思路的配套动作:官方配套文里演示了把 JSON 解析成类型化列,让回给模型的每一行都是必要信息。
全新 PEG 解析器成为默认,扩展可以自己加语法
从 2018 年第一行代码起沿用的 PostgreSQL 血统解析器(YACC/Bison 生成的 LALR(1))正式退居二线,1.5 里可选的 PEG 解析器在 2.0 成为默认。PEG 语法按书写顺序依次尝试候选写法,加新语法不会撞破旧规则——官方举的同类先例是 Python 在 3.9 换成 PEG 解析器,动机一模一样。现在扩展可以把自己的语法规则挂进文法,报错还能给出精确的源码位置。真要退回旧行为,装 legacy_parser 扩展后 SET enable_legacy_parser = true; 即可。对国内做数据平台、又常在 SQL 里做二开/方言扩展的团队,这条比任何性能数字都重要——SQL 方言终于有了合法的扩展点。
触发器来了,增量物化视图在门口
2.0 加入 CREATE TRIGGER:支持 BEFORE / AFTER、FOR EACH ROW / FOR EACH STATEMENT、通过 REFERENCING OLD/NEW TABLE 使用过渡表、同一事件挂多个触发器、RETURNING 子句、DROP TRIGGER。典型用法是审计表。官方还演示了用插入触发器和删除触发器维护”按国籍分组的平均年龄”这种统计表的增量更新——这是把他们路线图里长期挂在”future work”的物化视图又拉近了一步。注意部分组合暂不支持(例如 BEFORE … FOR EACH ROW 和 UPDATE … FOR EACH ROW)。
SQL 方言的新一批语法
- –
$variable简写:配合SET variable = …使用,表达式里直接写$x,不用再套一层getvariable('x')。 - – 可改数据的 CTE:
WITH … AS (INSERT/UPDATE/DELETE/COPY …),让写入操作可以当作管道步骤串起来。 - – NEAREST join:把 top-k 相似度搜索写成 join,向量/embedding 场景直接受益。
- – 嵌套 schema:
CREATE SCHEMA finance.reports这种写法可以用了。 - – JSON 修改函数:
json_set/json_insert/json_replace/json_remove一组。 - – 另外:SQL 标准的
FETCH FIRST、GROUP BY 里允许UNNEST、行匹配不确定时语义明确的MERGE和UPDATE … FROM。
扩展体系:C API v2 和可扩展的扩展仓库
C API v2 比上一代能力更强,把文件系统、表函数这些内部组件也开放给扩展使用。官方态度很直白:先别急着说稳定,欢迎拿去用并反馈。另一条新能力是自定义扩展仓库:CREATE EXTENSION REPOSITORY 可以指向任意可读位置(本地路径、https、s3 都行),带一把或多把 RSA 公钥,DuckDB 在创建时抓取公钥并打印 SHA-256 指纹供比对,之后用 allow_extension_repositories 启用。这个功能的语法后续还可能调整。
核心扩展这批一起更新:DuckLake 出到 1.1(新规范 + 参考实现);Iceberg 扩展新增 REST catalog 的 ATTACH 参数,可从 namespace 推导表位置、读取 catalog 返回的元数据文件;Delta 扩展现在能用 CREATE TABLE 建 Delta 表(含分区和表属性),支持时间旅行,VARIANT 支持也改进了。
迁移和”断舍离”清单
- – C++17 起步,告别 C++11;Linux/macOS 发布构建默认改用 Clang(Windows 上 CLI 用 Clang,多数核心扩展仍用 MSVC)。
- – ICU 库整个移除:时区、历法、排序规则改由 icu 扩展自己实现,时区数据直接从 IANA 数据库生成、压缩到约 45 kB,行为不变、速度更快。
- – 单箭头 lambda 语法默认关闭,推荐 Python 风格
lambda x: x + 1;可用SET lambda_syntax = 'enable_single_arrow';临时打开,但这个开关和旧语法在 2.1 都会彻底删除。 - – amalgamation(单文件合并)构建退役——已经大到基本没人能用。
- – macOS x86_64 逐步淘汰:目前官方还在构建和支持,社区扩展只尽力(best-effort);2.1 起停止支持 osx_amd64。
小夏点评
- 1. 这次发布的重心不是”跑分更快”,而是角色变化:Quack + CONNECT + 远端下推,等于把 DuckDB 从”你进程里的一个库”抬到”能给一批进程、还能给 agent 用的服务”。本地开发机上开一个 CLI 就是数据服务入口,这对小团队非常划算。
- 2. 异步 I/O 是这次最实在的硬核收益,而且收益全部在网络上——对象存储、跨主机查询、大批量 Parquet 扫描这些场景等于直接换了一代引擎。反过来,数据一直在本地 NVMe 上、单机跑小表的团队,不必为了版本号从 1.x 跳到 2.0 去折腾迁移。
- 3. 迁移成本这次是真的存在:2.0 建的库文件老版本读不了,agent 模式、PEG 解析器、lambda 语法、macOS x86_64 都有明确的取舍点。对中国 IT 运维和开发者的启示是——把 DuckDB 2.0 当作”下一代分析层选型”来评估:数据在 S3/OSS 上的日志、埋点、审计场景优先试;先建影子环境验证,等业务窗口再切换;另外现在就别在新代码里写单箭头 lambda,2.1 会一刀切掉。
参考链接
- – 原文链接(canonical):Announcing DuckDB 2.0.0 LTS “Cinnamon Teal”(DuckDB 官方博客,2026-10-21)— https://duckdb.org/2026-10-21/announcing-duckdb-200.html
- – 图来源文:Asynchronous I/O in DuckDB: Work, Thread, Work(2026-07-31,本文基准表数据出处)— https://duckdb.org/2026-07-31/asynchronous-io.html
- – 官方文档:Quack 协议 — https://duckdb.org/docs/2.0/quack/overview.html | PEG 解析器 — https://duckdb.org/docs/2.0/sql/peg_parser.html | agent 模式 — https://duckdb.org/docs/2.0/clients/cli/agent_mode.html | 迁移指南 — https://duckdb.org/docs/2.0/operations_manual/migration.html
- – 配套阅读:Gems of DuckDB 2.0.0(2026-10-26)— https://duckdb.org/2026-10-26/gems-of-duckdb-200.html
- – A Preview of DuckDB v2.0(2026-08-17)— https://duckdb.org/2026-08-17/duckdb-20-highlights.html
- – Agent Mode in the DuckDB CLI(2026-10-09)— https://duckdb.org/2026-10-09/agent-mode.html
- – DuckDB 2.0: Your Database Deserves a Better Parser(2026-08-20)— https://duckdb.org/2026-08-20/duckdb-20-peg-parser.html