扫描版56页,5分钟出带引用的答案:给搜索看不懂的文档搭条RAG管道
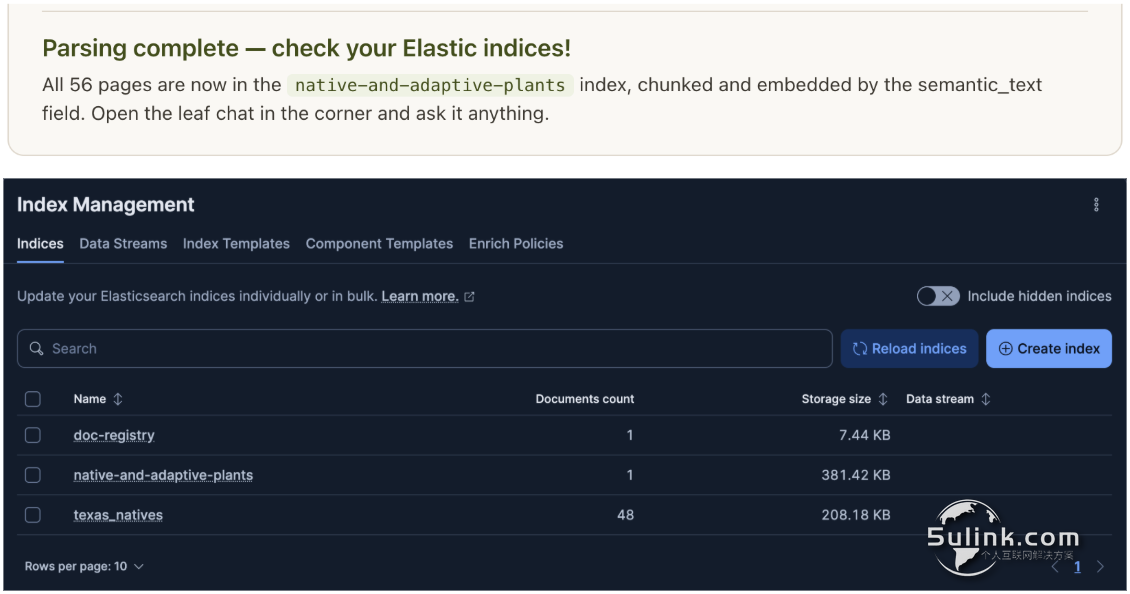
Elastic Labs 放出一个实战教程:上传一份 56 页扫描版德州原生植物指南,问”哪个树种耐浅层石灰土”,不到 5 分钟拿到带页码引用的答案和站内商品推荐。整条管道只有两段托管服务:jina-ocr-v1 把扫描页读成结构化 Markdown,Elasticsearch 的 semantic_text 字段在写入时完成切块和嵌入——没有切块代码,也没有嵌入作业。
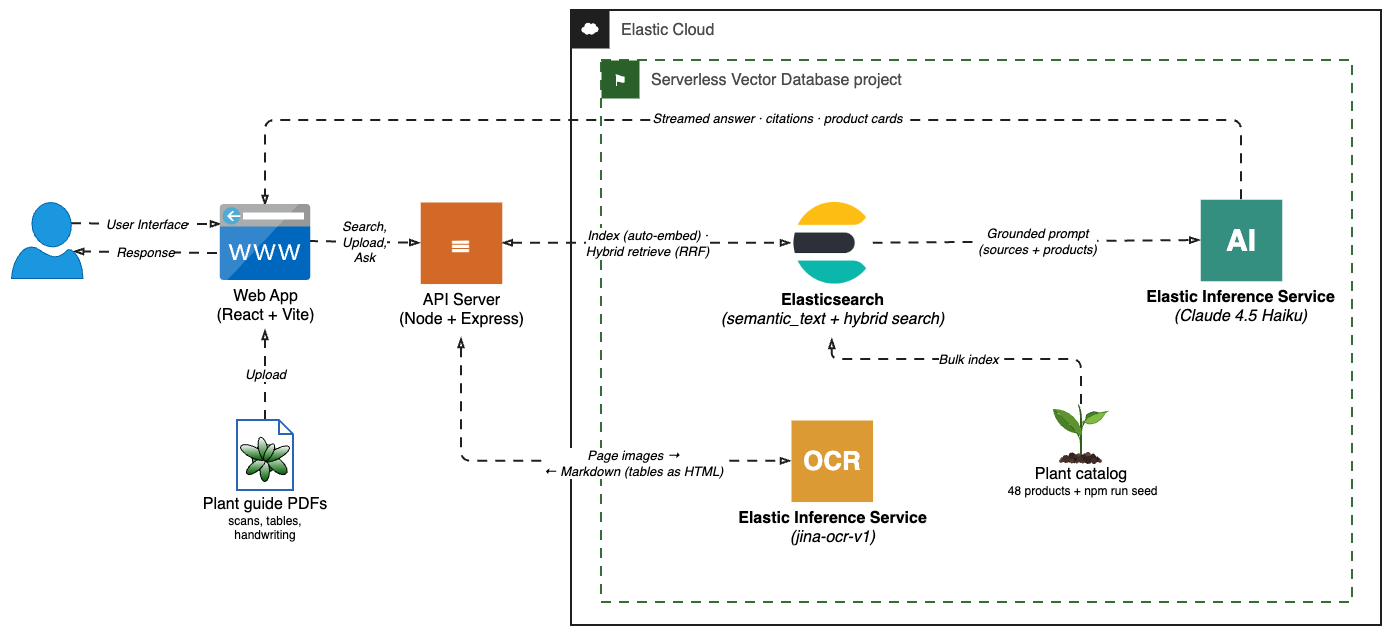
管道架构
| 环节 | 用什么 | 干什么 |
|---|---|---|
| 文档解析 | **jina-ocr-v1**(单模型一趟过) | 版面、文字、表格、阅读顺序一次还原成 Markdown |
| 切块+嵌入 | semantic_text 字段 + 推理端点 | 数据写入即完成,无独立作业 |
| 检索 | **RRF 混合检索** | 词法精确匹配 + 语义匹配双通道融合 |
| 生成 | Claude Haiku 4.5(EIS 上) | 严格 grounding:只答来源里有的,按页码引用 |
| 应用层 | React 前端 + Express 后端 | 凭证留在服务端,解析进度 SSE 推流 |
单模型解析 vs 传统 OCR 链
传统 OCR 要把版面检测、文字识别、表格解析、阅读顺序四个模型串成链,每一环都有独立成本和故障模式;新一代视觉-语言文档解析器一趟完成,输出直接为检索设计:阅读顺序保留的 Markdown、表格以 HTML 形式保数值还原、手写内容行内转写、页眉页脚和印刷页码剔除(引用页码由摄取循环自己盖)。
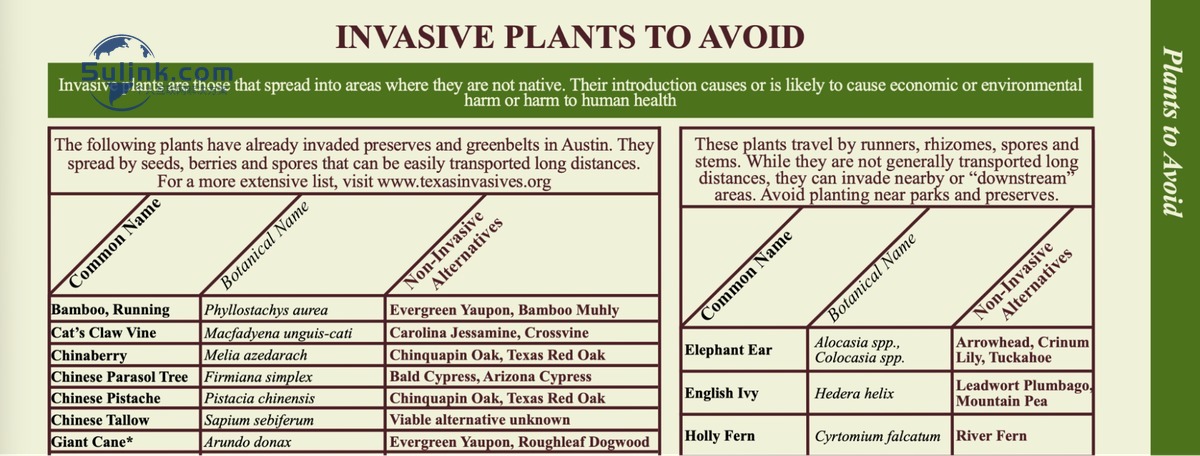
为什么拿植物指南当测试件?这本手册几乎每页都是密集多栏表格:缩写字段(VL=极低水分、B/E=草原生态区标记)、野火值打勾列、斜体拉丁学名、照片说明与数据交错——正是普通 PDF 文本抽取翻车、老式关键词搜索也翻车的典型。能啃下这种表的解析器,就能啃你的发票。
页面循环在哪跑,是个架构决定
解析模型每次只看一页图(清晰度支持到约 2048×2048),所以得有人跑页面循环——三条路线的差别在”跑在哪、算谁的账”:
| 路线 | 谁跑循环 | 输入粒度 | 跑在哪 |
|---|---|---|---|
| Jina Reader API | Jina 服务端 | 一次一个 PDF | 平台外,单独的 Key 和账单 |
| 裸 chat completions | 你的应用 | 一页一次调用 | 平台外 |
| **EIS** | 你的应用 | 一页一次调用 | **平台内,一个 Key 一张账单** |
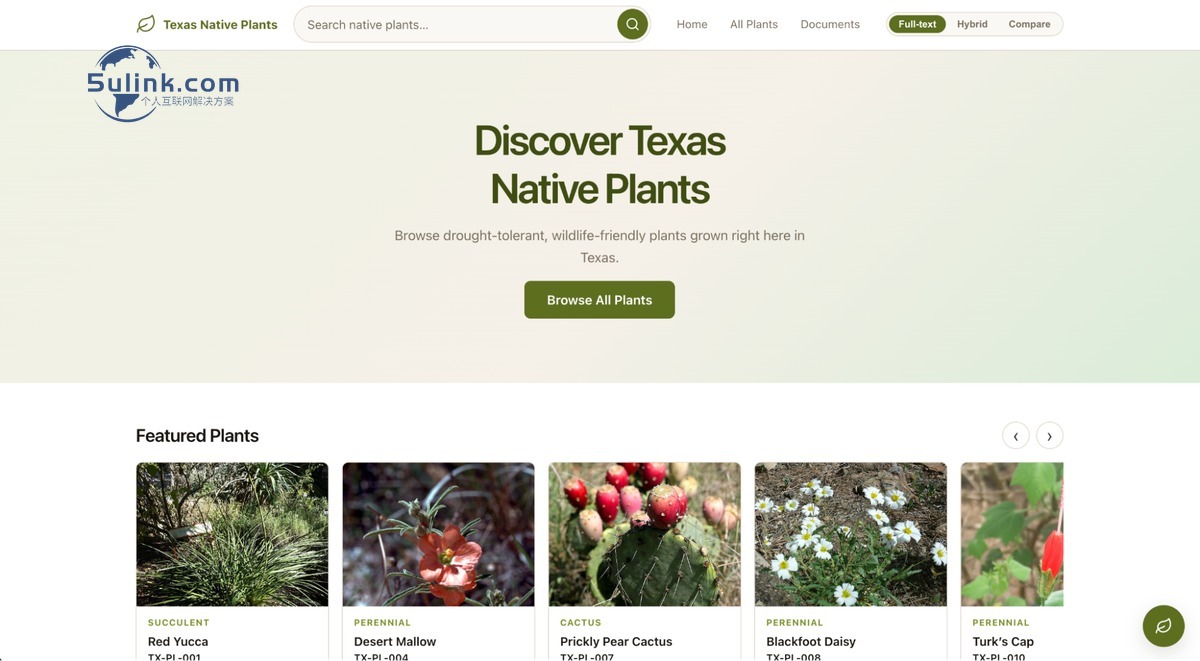
教程选了 EIS:整条管道(解析、嵌入、生成)连同前端目录都在一个 Elastic Cloud Serverless 项目里,一个安全边界、一张账单。
检索和引用怎么做实
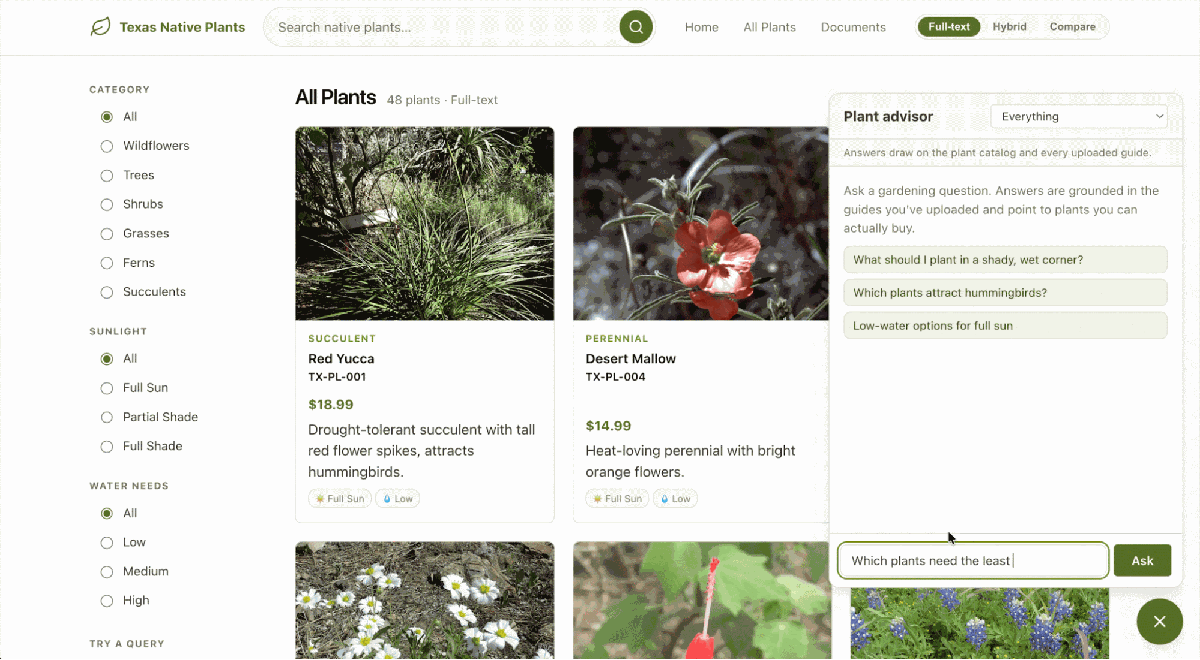
混合检索两路并行:词法通道负责精确术语(拉丁学名 Quercus macrocarpa、价格、缩写),语义通道负责”给碱性石灰土选树”这种没有字面命中的问题,RRF 融合排名;语义高亮器返回最佳嵌入块、普通高亮器返回词法片段,页码从摄取循环埋的页标记还原。生成端把来源、匹配商品和问题一起交给 Claude Haiku 4.5,要求只按来源作答、按名称+页码引用、只推荐目录里存在的商品、答不了就直说。演示里跑下来,混合检索稳定捞出纯关键词漏掉的植物。
小夏点评
参考来源
https://www.elastic.co/search-labs/blog/rag-pipeline-scanned-pdf-jina-ocr