SGLang 登上 TPU:Meta 生产验证,RL 训练追平 GPU
10 月 20 日,RadixArk、Google 和 Meta 三方联合开源了 SGLang-TorchTPU:把 SGLang 整套服务栈搬上 Google Cloud TPU 的原生 PyTorch 后端。发布方给的三个卖点都很硬——Meta 已经在生产环境大规模跑通,RL 训练在 TPU 上端到端跑通,贡献者还能申请免费 TPU 算力池。
这篇的重点不是”TPU 能跑开源模型”,同一天 vLLM 也官宣了自家 TorchTPU 后端。真正的信息量在两件事:一套为 GPU 写的推理引擎代码,如何在不 fork 的前提下落到非 CUDA 硬件上;以及为了这件事,工程上付出了什么代价。
架构:调度器不动,只换硬件要交的那几个作业
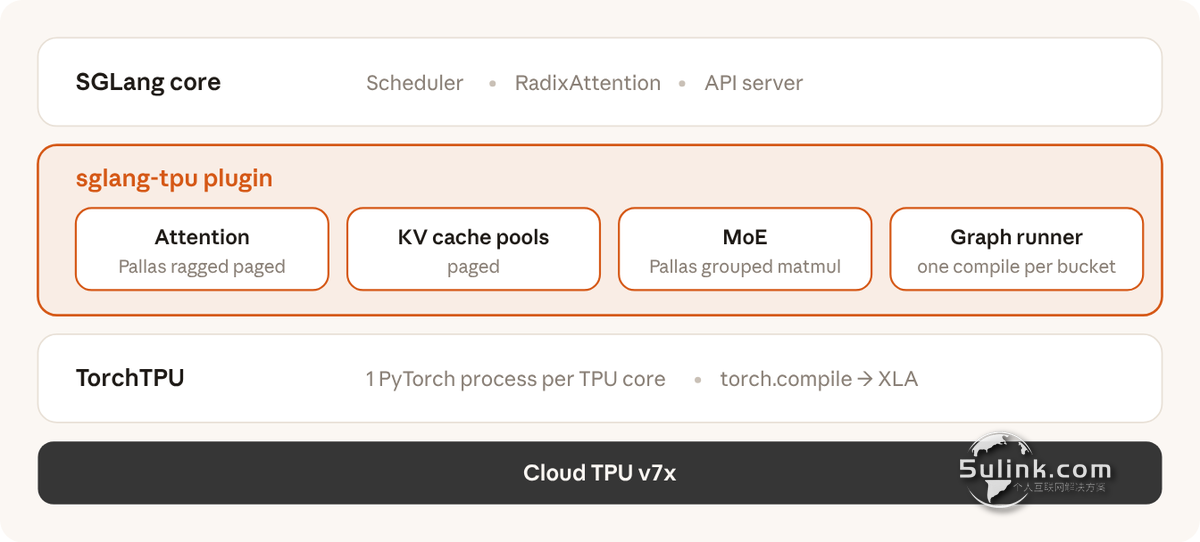
SGLang-TorchTPU 是一个 out-of-tree 插件。装上 sglang-tpu 包后,它通过 sglang.srt.platforms 入口点向 SGLang 注册一个 TPU 平台,用 SGLANG_PLATFORM=tpu_oot 选中。
关键在于分工:调度器、RadixAttention、API Server 全部是 SGLang 原版的,插件只补 SGLang 本来就要求每个硬件平台提供的四样东西——注意力后端、KV 缓存池、MoE 内核、图执行器。
执行模型也照搬 GPU 的路子:每个 TPU core 跑一个独立的 PyTorch 进程,模型在 torch.compile 下编译后下沉到 XLA。
这里有个和 CUDA 生态明显不同的工程细节:没有 graph capture。取而代之的是”桶化”——把每次 forward 补齐到固定的 token 数桶(prefill 阶段)和固定的 batch size 桶(decode 阶段),每个桶编译一次,后续请求按形状直接派发到编译好的程序。
注意力和 MoE 跑在 Pallas 内核上,以 torch.library 自定义算子的形式注册,在编译图里被 Dynamo 当作不透明调用:分页 KV 缓存上的 ragged paged attention,以及按专家分组排序后的 grouped matmul。
一句话总结这套架构的价值:新模型和新功能只要进 SGLang 主仓,理论上就能通过单一实现落到 TPU 上。
KV 缓存怎么搬:边算边传,只留最后一块
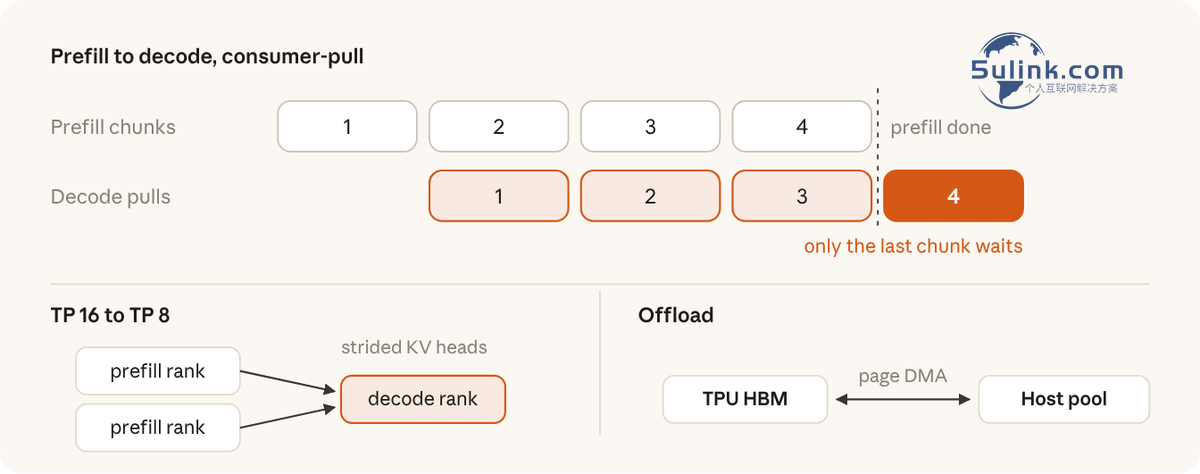
这是全文工程含量最高的部分。当 KV 缓存需要离开设备——无论是卸载到主机内存,还是跨主机的 prefill/decode 分离部署——数据走 TPU Sync,Google 的开源 TPU DMA 库。
| 场景 | 传输方式 | 原文描述 |
|---|---|---|
| KV 卸载到主机 | 整页搬运,HBM ↔ 主机 pinned 内存池 | 直接走 PJRT DMA |
| 跨主机 PD 分离 | **consumer-pull**(消费端拉取) | prefill 每完成一个 chunked-prefill 步骤、提交一批页,就”广播”这批页;decode 端在下一块计算的同时把这一块拉走 |
| 前缀缓存命中 | **不传** | decode 端自己已有的页,一个字节都不发 |
| 不同 TP 规模之间 | 传输途中重分片(reshard) | prefill 各 rank 按步长把自己的 KV head 切片推进 decode rank 的页布局 |
这套设计的直接收益:prefill 结束时,只剩最后一块 KV 需要搬运。多轮 agent 会话里前缀缓存命中的部分完全免传输。
功能与模型覆盖:agent 负载是明线
原文列出的首发功能,按用途整理如下(全部为原文所列,标注 experimental 的是原文标注):
| 方向 | 首发可用功能 |
|---|---|
| 核心服务 | OpenAI 兼容 API、连续批处理、chunked prefill、结构化输出与函数调用(experimental) |
| Agent 与多轮 | RadixAttention 前缀缓存(含混合滑窗与线性注意力模型)、KV 缓存卸载到主机内存、agent 工具调用负载每晚跑 CI |
| 低延迟交互 | 投机解码,支持 EAGLE-3、DFlash、DFlash2、DSPark 和 MTP 草稿模型 |
| 高吞吐批处理 | 数据并行注意力 + 专家并行 |
| 长上下文 | FP8 KV 缓存、prefill 与 decode 的上下文并行 |
| PD 分离 | prefill 与 decode 分主机部署,跨不同 TP 规模做 KV 重分片 |
| 多模态 | 支持图像输入的视觉语言模型:Qwen3-VL、Qwen3.5-VL、Kimi MoonViT、Gemma 4 vision |
| 超大模型 | 跨主机张量并行 + 专家并行 + 数据并行注意力;FP8、MXFP4、INT4 权重;流水线并行与 NVFP4 MoE(experimental) |
首发模型名单(原文表格,含类型):
| 模型 | 类型 | 模型 | 类型 |
|---|---|---|---|
| Muse Spark Open | LLM | Qwen3.8 | LLM |
| GLM-5.3 Flash / GLM-5.3 | LLM | Gemma 4 | LLM |
| Kimi K3 | LLM | MiniMax H3 | Diffusion |
| DeepSeek V4 | LLM | Wan2.2 | Diffusion |
| Ling 3.1 Flash / Ling 3.0 系列 | LLM |
名单之外还列了 gpt-oss、Qwen3-Coder-480B、Qwen3.5、DeepSeek-V3.1 和 R1、Kimi-K2.6、MiMo-V2.5-Pro、Qwen3-VL。
值得单独指出的一点:首发名单 9 行里,7 行来自中国团队的开源模型(GLM、Kimi、DeepSeek、Ling、Qwen、MiniMax、Wan,按公开归属判断),表内唯一的非中国来源是 Gemma 4。名单之外还列了 gpt-oss、Qwen3-Coder-480B、Qwen3.5、DeepSeek-V3.1 和 R1、Kimi-K2.6、MiMo-V2.5-Pro、Qwen3-VL。
Google 自己的配套博文提到,TorchTPU 生态在 Ironwood 上跑 Qwen 3.5 397B-A17B(8k/1k、fp8)时给出了 2.01 美分/百万 token 的成本数据。
排期上,原文说 DeepSeek V4.1 Flash 和 Reflection Beam 紧随其后,从 2027 年第一季度起,新开源模型目标是 Day 0 支持。
可靠性:193 个 TPU 测试进 CI,矩阵由测试生成
这部分是原文里最容易被跳过、但对运维最有用的信息。
规则很直接:凡是标为 supported 的模型和功能,都必须在真实 TPU 硬件上有 CI 测试,支持矩阵直接由测试注册生成;还在验证的一律留在 Experimental。
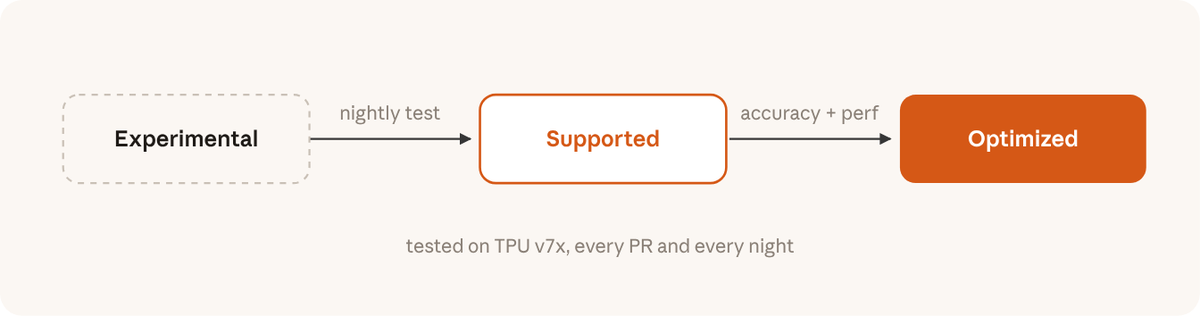
当前 CI 规模(原文数字):
| 项目 | 数据 |
|---|---|
| PR 套件运行环境 | 单机 TPU v7x 切片 |
| CI 覆盖模型数 | **15 个**(单机 + 多机 v7x) |
| 已注册 TPU 测试数 | **193 个** |
| 准确率评测集 | GSM8K、GPQA、AIME、MMLU-Pro、MMMU |
| 功能覆盖 | 投机解码、前缀缓存、KV 卸载、DP 注意力、多机执行、PD 分离 + KV 重分片 |
| 组合测试 | 投机解码 × PD 分离、前缀缓存 × KV 卸载 |
| Agent 负载 | 多机部署上的工具调用负载,每晚跑 |
RL 训练实测:4 颗芯片追平 6 张 H200
服务只是一半,训练这一半也得成立。原文用同一套 PyTorch 栈在 TPU 上端到端跑了强化学习:TorchTitan 做训练器(无 TPU 专用模型代码),SGLang-TorchTPU 生成 rollout,RadixArk 的 RL 框架 Miles 负责把新权重从训练器同步回推理引擎。
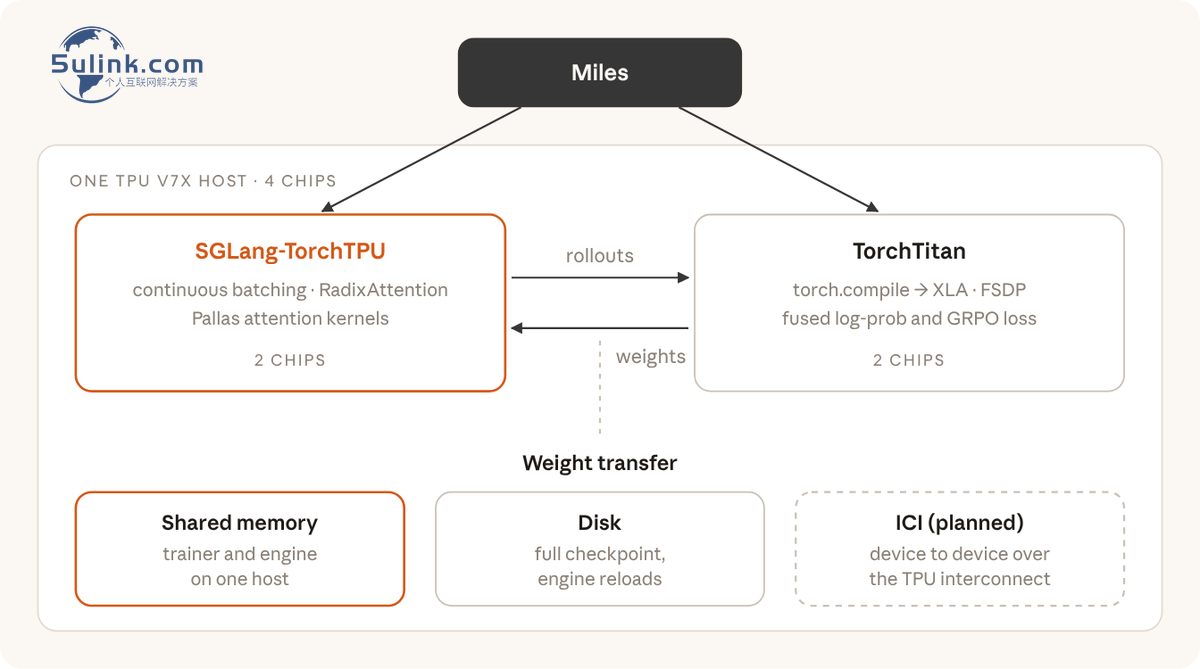
权重回传三条路径,原文给了明确评价:
| 路径 | 适用 | 原文评价 |
|---|---|---|
| 共享内存 | 训练器与引擎同主机 | 当前实验采用 |
| 磁盘 | 可跨主机 | 最慢 |
| **ICI** | TPU 互联,设备到设备 | 计划中,实测比共享内存**快约 50 倍** |
实测设置:Qwen3-4B 用 GRPO 在 DAPO-Math-17k 上训练,单台 TPU v7x 4 颗芯片(2 训练 + 2 rollout),对照组是 6 张 H200,两边各跑两个种子做对齐。
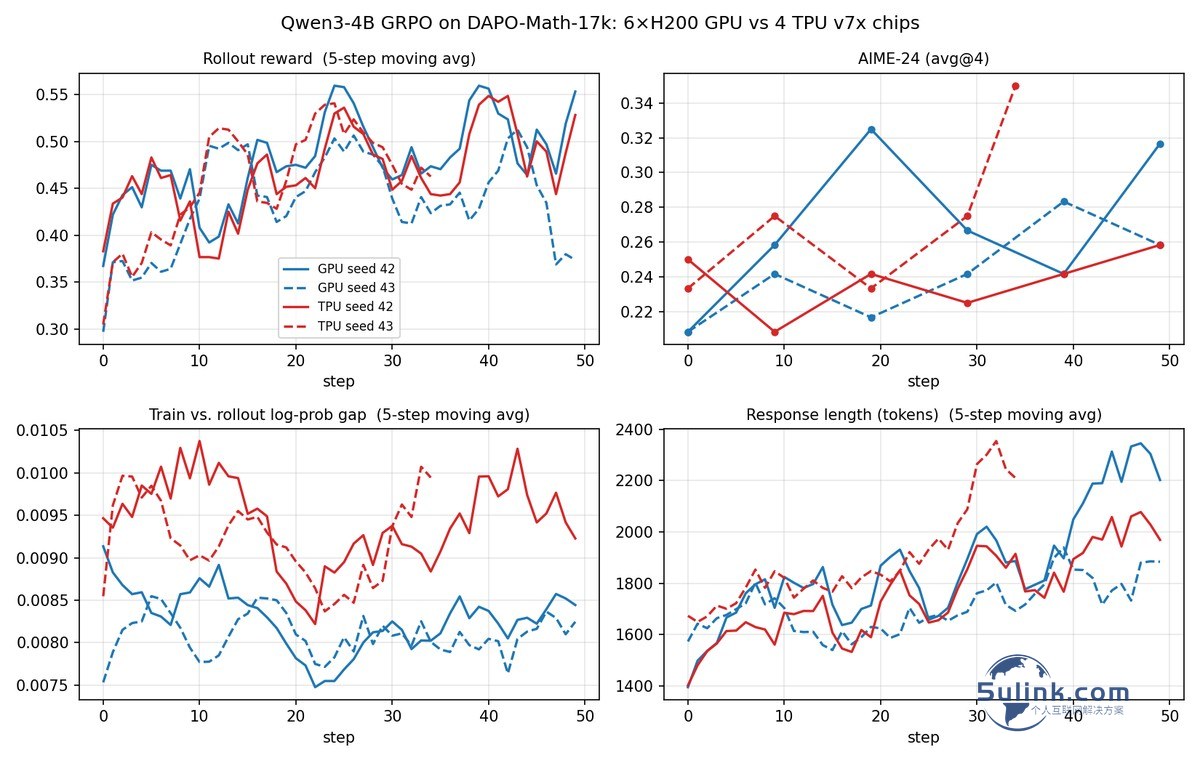
结果按原文口径:TPU 上的 reward 和响应长度曲线在种子间波动范围内与 GPU 一致,AIME-24 在评测噪声范围内。Miles 的 TPU 训练目前是 preview 状态。
后续计划原文列了六条:更大模型(含 Qwen3-30B-A3B 与路由重放)、跨主机训练、改用 ICI 传权重、缩小与 GPU 的 step time 差距、更长周期的对齐验证、训练与推理之间逐位一致的 log-probs。
小夏点评
1. 真正的看点是”插件化”这条路跑通了。 调度器、RadixAttention、API Server 一行不改,硬件层只交四个作业(注意力后端、KV 池、MoE 内核、图执行器),就能让 GPU 起家的引擎落到 TPU 上。同一天 vLLM 的 TorchTPU 插件用的是同一个模式。这意味着推理引擎与加速卡正在解耦——选型时可以把”引擎”和”卡”当成两个独立变量来谈。
2. RL 训练这组数据规模很小,但战略意义很大。 4B 模型、4 颗芯片对 6 张 H200,谈不上性能结论,原文自己也只说”早期学习行为接近 GPU 基线”。真正值钱的是 rollout → 训练 → 权重回传这个闭环在非 NVIDIA 硬件上跑通了,尤其是 ICI 权重同步比共享内存快约 50 倍这一条——互联原生传权重,是所有自研加速卡最需要的能力,这里给出了参照。
3. 对中国 IT 运维和开发者的启示。 第一,首发模型名单里中国开源模型占了 7 行,Google 生态愿意为它们做 Day 0,意味着国内团队的模型选型开始反向影响海外加速卡的路线图,谈算力时手里的筹码比两年前多。第二,工程账要算细:桶化编译换来的是首次启动要编译几分钟(原文建议用 VLLM_XLA_CACHE_PATH 复用编译产物),冷启动成本要写进服务等级里。第三,判断这类新后端能不能上生产,看 CI 覆盖比看功能列表更靠谱——193 个测试、15 个模型、带组合测试和每晚回归,这套门槛才是国内团队评估异构算力供应商时该照抄的清单。