KV 缓存分层:AWS 给推理集群的四层存储方案
瓶颈不在 GPU
AWS 这篇官方文章开门见山:跑大规模 LLM 推理,限制你的往往不是 GPU 本身。GPU 出 token 很快,但真正决定生产表现的是围着它的那一圈——内存、存储、以及连接它们的网络路径。训练是可预测的,推理不是:它对延迟敏感、随并发用户数线性膨胀。所以推理的经济账不在卡里,在喂它的存储层级里。
整个系统的中心就是 KV cache:transformer 每层每个 token 都要算 key/value 向量,逐 token 生成时靠缓存避免重算。但足迹随”上下文长度 × 并发会话 × 层数”线性膨胀——服务 1000 个 agentic 会话就是 1000 份独立 KV。单个模型的活跃 KV 可以到几十到几百 TB,远超任何单机内存。问题不是要不要存 KV,是放在哪、多快能搬回来。
四层存储:按温度分层
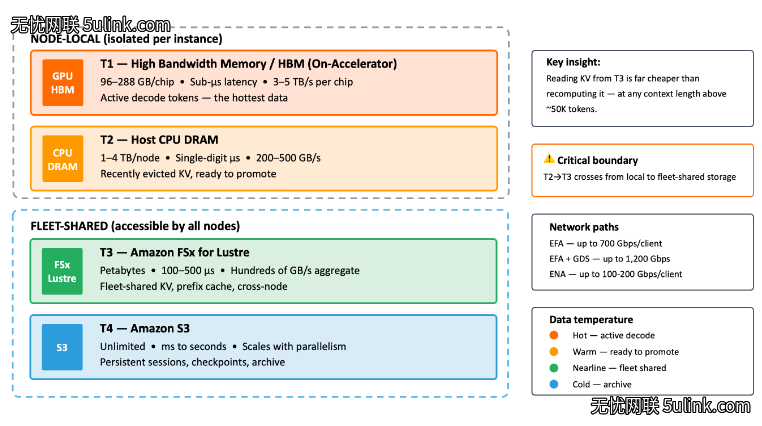
原文把方案画成四层,每层服务一种”温度”的数据:
| 层 | 介质 | 容量 | 带宽 | 延迟 | 放什么 |
|---|---|---|---|---|---|
| T1 | 卡上 HBM | 80–288 GB/芯片 | 3–8 TBps | 亚微秒 | 正在解码的热 KV |
| T2 | 主机 DRAM | 1–4 TB/节点 | 200–500 GBps(DDR5) | 个位数微秒 | 刚驱逐、随时可升回 |
| T3 | FSx for Lustre | PB 级 | 聚合数百 GBps | 100–500 μs | 全集群共享 KV、前缀缓存 |
| T4 | S3 | 无限 | 随并发扩展 | 毫秒到秒 | 持久会话、检查点、归档 |
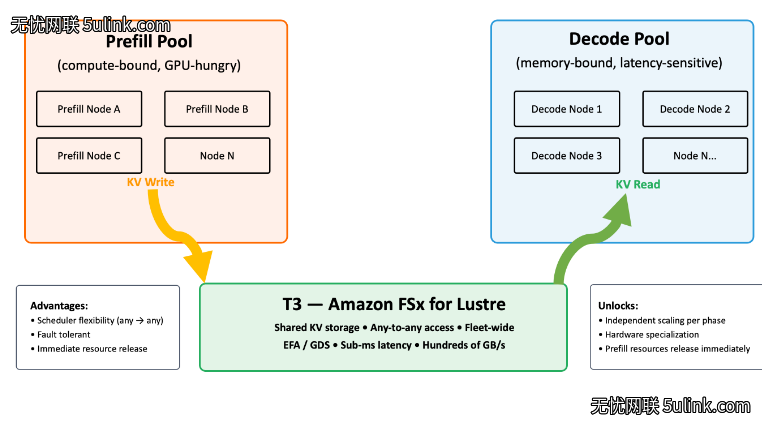
关键区分是 T1/T2 是”单机私有”的——A 节点 DRAM 里的 KV,B 节点看不见;T3 是全集群同时可读的共享层,它把孤立的加速卡节点变成协同的分离式推理系统:系统提示的前缀 KV 算一次、全集群读,直接压低命中请求的首 token 延迟(TTFT);节点故障或请求落到别的节点,KV 还在,不用重算。
网络路径同样重要:EFA 提供节点间和到共享存储的高带宽低延迟通道,GDS 让 GPU HBM 与存储直接 DMA、绕过 CPU 和主机 DRAM。FSx for Lustre 单客户端经 ENA 最高 100 Gbps、经 EFA 最高 700 Gbps、EFA+GDS 最高 1200 Gbps——这个天花板决定单节点能吸收多少并发命中会话。
你的模型需要多少 KV
原文给出可套用的公式:每 token KV 字节 = 2 × 层数 × KV 头数 × head_dim × 每元素字节数,并直接算了两笔账:
- Llama 3.1 405B(GQA,8 个 KV 头):2 × 126 × 8 × 128 × 2B = 516 KB/token
- DeepSeek-R1 671B(MoE + MLA):(512+64) × 2 × 61 ≈ 70 KB/token
模型更大、足迹反而小 7 倍——MLA 缓存的是低秩潜向量而不是完整 K/V 头。架构选择直接决定存储经济学。量化是另一根杠杆:FP16→FP8→INT4 可把每 token KV 再压 50–75%。
按”总 KV = 每 token × 上下文 × 并发会话”,原文的规模表:GQA 模型中等场景(200K 上下文 × 100 会话)约 10 TB,能塞进 Trn3 UltraServer 聚合 HBM;dense 模型的 agentic 场景(1M 上下文 × 500 会话)BF16 下高达 2 PB,必须多层。顺带一个反直觉点:Trn3 UltraServer 用 144 颗芯片聚合 20.7 TB HBM(NeuronLink 706 TBps),是普通 8 卡节点的 9–18 倍——T1 池大到这个程度,很多负载可以直接从 T1 跳到 T3,中间层反而白加复杂度。
数据什么时候搬
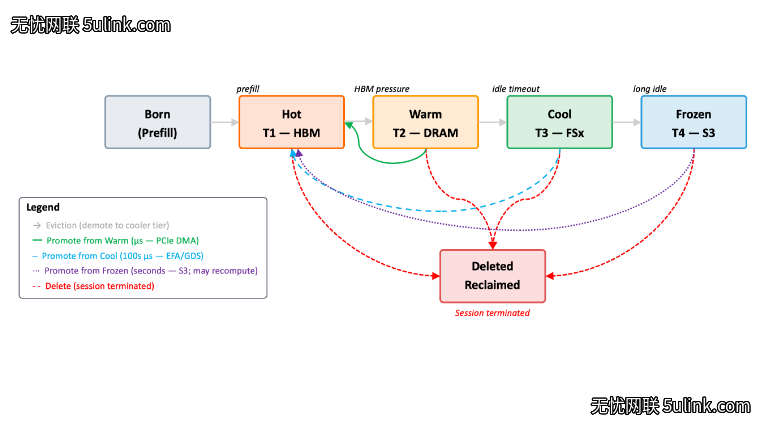
知道层级之后,原文给出可执行的搬运策略:HBM 压力超 85% 就把最久未用的从 T1 驱逐到 T2;会话闲置超阈值就从 T2 降级到 T3;闲置更久导出到 S3。驱逐姿态分两派——eager(prefill 一结束就主动写一份到共享层,节点故障即刻恢复,代价是写带宽翻倍)和 lazy(留在卡上直到内存压力逼你降级,省 I/O 但换节点就得重算)。分离式推理(prefill 池与 decode 池分开)下 eager 是必选项,因为 decode 节点永远不是当初算 prefill 的那台。
晋升侧的决策线是全文最实用的一句话:上下文超过 5 万 token,从 T3(100–500μs)读回几乎总是比重算快;上下文低于 1 万 token,重算很便宜,分层纯属多余。 从 T4 读回要秒级,多数情况下不如直接重算。
前缀缓存值得单独设计:系统提示、RAG 文档前言、通用指令模板产出的 KV 对所有用户都一样,原文建议用内容寻址(哈希前缀 token 得到文件路径)、TTL 失效、按”一次写、全集群同时读”的扇出模式给 FSx 配带宽。
为什么共享层是 FSx for Lustre
T3 要同时满足五个条件,原文认为只有并行文件系统全中:全集群 POSIX 并发挂载、亚毫秒读延迟、聚合数百 GBps、标准文件语义(vLLM/SGLang/LMCache 的 KV offload 都走标准文件 I/O,不需要 SDK)、PB 级容量加 S3 生命周期导出。配置上它给了一张清单:Persistent SSD、与集群同可用区、关压缩、开 S3 数据仓库关联、挂载参数 flock,noatime、I/O 走 O_DIRECT、条带数 ≥ 节点数、每节点 32+ I/O 线程。
框架对接现状(原文表格):vLLM 用 KV Block Manager 把文件系统当 offload 目标;SGLang 的 RadixAttention 天然前缀感知,与共享前缀缓存是绝配;LMCache 原生支持文件系统后端;NVIDIA Dynamo 支持 HBM→DRAM→文件的多级链;llm-d(EKS)用共享 PVC 让 prefill 和 decode pod 共读 KV。
什么时候值得上这套架构
原文的部署判据很克制,不是”全都上”:工作集经常超过全集群 HBM、超 30% 请求共享前缀、平均闲置超 30 秒、加卡主要是为了”存 KV”而不是”跑解码”、峰均并发比超 3 倍、采用分离式推理——满足这些才需要 T3。短上下文低并发只用 T1 就够,中等上下文配 T2 也行。
小夏点评
- 全文最有价值的是把”架构选择”和”存储账单”直接挂钩:MLA 让 671B 的 R1 每 token 缓存比 405B 的 Llama 小 7 倍——选模型时 KV 足迹应该和参数量、精度一起进成本表,这在国内多轮 agent 场景里是实打实的钱。
- “5 万 token 以上读回比重算快、1 万以下直接重算”这条决策线值得抄:它把分层从教条变回工程判断——不是所有负载都配得上四层架构。
- 给国内团队的启示:国内推理集群普遍是单机 HBM + vLLM/LMCache 本地盘,缺的正是 T3 这个”全集群共享层”——国内对象存储毫秒级延迟填不了 100–500μs 的预算,对应位置要用 CPFS/并行文件存储类方案顶上;而”前缀命中降 TTFT”这条对国产大模型的客服/Agent 流量(系统提示高度重复)几乎是立竿见影的收益。
参考链接
- 原文:Accelerate inference with KV cache tiering on AWS(2026-09-21,AWS Storage Blog,作者 Siva Devabakthini 等)
- 关联阅读:Accelerate LLM model loading with GPUDirect on FSx for Lustre
- LMCache 仓库:github.com/LMCache/LMCache
- vLLM 文档:docs.vllm.ai