半年开出 4400 个 PR、合进主干 3100 个:ClickHouse 怎样给 AI 工程师建起一条工程流水线
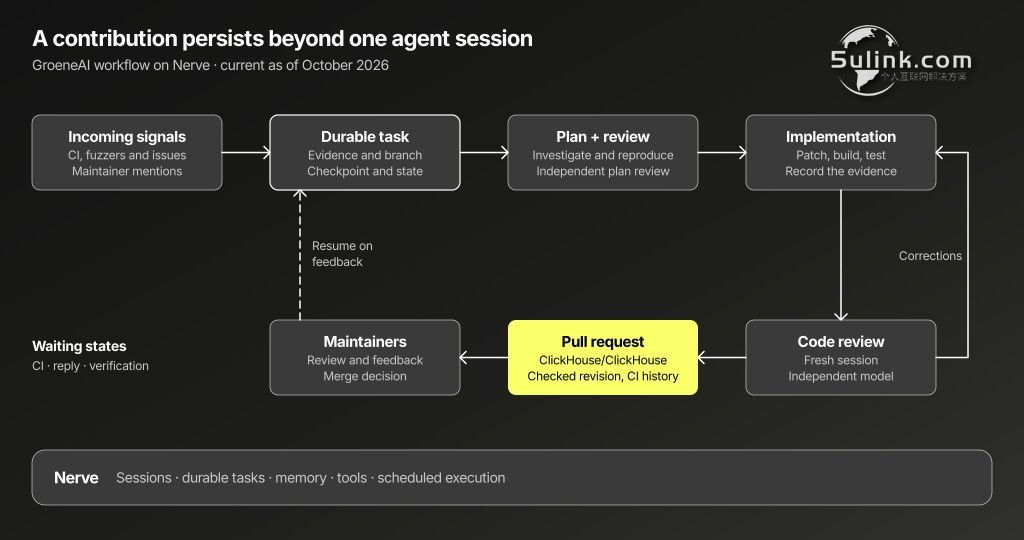
▲ Nerve 负责保存任务并调度执行,GroeneAI 的工作流负责阶段交接:返工回到实现阶段,CI 与维护者反馈可以在发布后重新唤起任务。(图:ClickHouse Blog 原文)
起点:谁去处理那些”跟你无关”的 CI 失败
在 ClickHouse 代码库,从 2026 年 3 月开始,有一类工作”经常不是人在做”。
场景很熟悉:你写完改动、本地测过、功能确认、提交、等同事意见——然后 CI 挂了。查下去发现不是你的 bug,是一个跟你这次改动毫无关系的失败。重跑一次往往就绿了,但问题还在那儿,下一个贡献者会再撞一次。有人得去干这件事:离开自己的补丁、翻更早的 CI 记录、复现失败、判断问题到底在数据库里、在测试里、还是在环境里。
ClickHouse 把这件事交给了 GroeneAI——一个每周 7 天、每天 24 小时运转的完全自主 AI 工程 agent。它复现失败、写修复并测试、然后一路跟着自己的 PR 走完 CI 和评审。”Groene”在荷兰语里是”绿色”,记的就是最初的目标:让 CI 保持绿。
它在 3 月 25 日开了第一个 issue,72 分钟后开出第一个 PR,之后没停过。整个开发流程没有人在环:自己挑活、自己查原因、自己设计并实现修复、自己编译 ClickHouse、自己跑测试、自己开 PR,绝大多数时候连”做什么”也是它自己定的——它的大部分工作来自 CI 结果、fuzzer 发现和用户报告,维护者也可以只用一条评论把 bug 丢给它。人类介入从评审才开始。
后续动作同样是自主的:盯 CI、回评审意见、改实现、跟着仓库推进做 rebase。一个任务可以跨很多个会话保持活跃,调查过程和下一步都留着。
六月:一个记错了东西的缓存
6 月 3 日,GroeneAI 正在盯自己那个 DDL 改动的 CI,一个不相干的测试 03047_on_fly_update_delete 在 S3 存储上的分布式查询计划下失败了。看起来像 flaky,重跑大概率就过。它选择去复现,bug 就是在复现里现形的。
query condition cache 会记住”数据段的哪几段没有匹配过滤条件的行”,后续同样的条件可以直接跳过这些段。但这个缓存条目只有在”过滤条件看到的是真实数据”时才可信——如果之前有别的操作删掉或改掉了行,那么”空结果”说明的是那次操作,不是存储里的内容。
调查把这份”看起来 flaky”追到了随机化的 index granularity:granule 大的时候,一条幸存的匹配行会让这段仍然需要被读取,bug 被藏住;granule 一行一个时,错误的跳过决定每次都能复现。缺的那个保护很老——它来自上一年 3 月合入的 query condition cache 最初实现,那里在 PREWHERE 之前应用 mutation,然后把得到的空段记进缓存,却没检查这些 mutation 是否改过行。
回归测试把这件事写死了:建 100 行,id 和 v 都是从 0 到 99;停掉后台 merge;提交一个异步更新,把 id >= 50 的行的 v 置零;原始 part 保持可读,于是查询可以选择在读取时是否应用这个待处理 mutation。开启并清空缓存后做两次读:
SELECT count() FROM t_qcc_on_fly_update
PREWHERE v >= 50 SETTINGS apply_mutations_on_fly=1;

SELECT count() FROM t_qcc_on_fly_update
PREWHERE v >= 50 SETTINGS apply_mutations_on_fly=0;| 读取方式 | 修复前 | 期望值(也是修复后) |
|---|---|---|
| 应用待处理的更新 | 0 | 0 |
| 读取原始数据 | 0 | 50 |
记录自该 PR 单副本回归 fixture(index_granularity = 1、mutations_sync = 0)下的 UPDATE 用例。
有意思的是,读的一侧本来就很小心——有 mutation 活跃时就不采用缓存结果;缺保护的是写的一侧。PR #107145 给两条写缓存的路径都加了检查:PREWHERE 之前如果存在 mutation 步骤或 patch part,就不写。行级安全策略同样加了这道闸。没有这些变换的查询,优化照旧。
这条 PR 的评论区也记录了 GroeneAI 六月时的工作方式(那时下面描述的流水线还没建):6 月 11 日开 PR,附了一张它自己验证过的表格;当天来了四条评审意见;它逐条修完,12 小时里把这张表重发了五次。八天后维护者问这个改动是否会让 lightweight mutation 下的 PREWHERE 失效,它 31 分钟答完,维护者又过 33 分钟点了批准。6 月 19 日合入。
一条规则在所有用例里成立:只有当过滤条件真的评估过缓存条目所代表的数据时,才允许它记录”这段没有匹配行”。
七月:一次调查长成一条流水线
那个缓存修复从失败测试到合入用了 16 天。一次编译、一趟跑一夜的 CI、评审者几天后回来——都在这 16 天里。一个会在会话之间失忆的 agent 根本做不了这种活;一个记住错东西的 agent 会把这种活做坏。 7 月,他们引入了现在仍在用的这条流水线。
入口是事件:存 GitHub 通知,跟踪每个消费者在收件箱里的位置;收件箱处理器把可行动的消息关联到任务;另有一个定时扫描专门看 CI 失败,包括那些从没出现在账号订阅通知里的。
任务是持久的:Nerve 把任务内容存成 Markdown 并建进 SQLite 索引;GroeneAI 在上面加了一个 checkpoint,记录当前阶段、分支、commit、build 标识、已完成的测试、证据位置、下一步动作。后来的会话靠这个 checkpoint 恢复状态,不需要前一次对话一直活着。
记忆跨任务:短的操作规则直接进会话上下文;较长的调查存在按需加载的文件里;语义召回负责捞出之前的发现和流程;skills 提供可复用的操作说明,比如怎么编译 ClickHouse、怎么调查一次 CI 失败。
存下来的信息也会过期,流程就当它过期处理:GroeneAI 的编译说明要求先核对当前 CI 的编译器配置和 CMake 缓存——即使记忆里已经存着一个编译器版本。记住的教训只负责把 worker 指向证据,证据要在当前 checkout 里验一遍。
流水线之上,一个新贡献被拆成三个各有分工的阶段:规划 worker 调查报告、检查源码和已有修复、写出方案和复现步骤,然后由另一个模型评审这份方案——如果报告是重复的、复现不出来、或者需要维护者拍板,工作可以停在这里。实现 worker 在任务的 checkout 里做改动,它的说明要求给出证据:回归测试在没有补丁时必须失败、有补丁时必须通过。全新的评审会话在读实现者的验证叙述之前先看代码,必须检查被改的函数、它们的调用方、相关实现,再把测试和 PR 描述对一遍。
> GroeneAI 的主 worker 会话用 Claude,方案与最终改动的独立评审用 Codex。评审者先建立自己对这份补丁的理解,再拿它跟实现侧的证据对比。被接受的实质性发现变成给实现的返工项;有争议的发现需要代码或测试证据来说明分歧。
流水线还会核对”被评审的是哪个版本”:常规 pre-push 路径要求有一份完整的第二模型评审,并且是记录在拟推送的 commit、tree 或完整 patch 标识上的。对旧版本的评审,不能悄悄给新的代码改动放行。
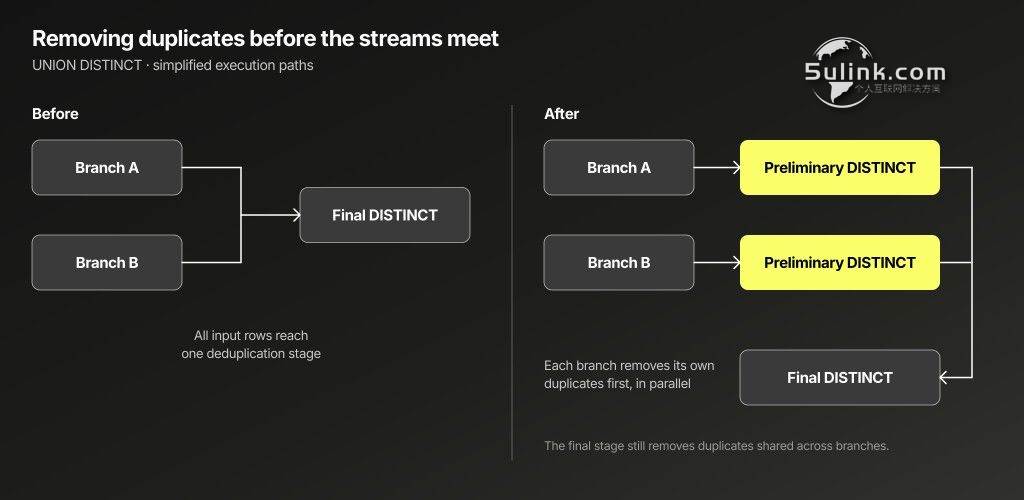
▲ 分支局部去重减少了进入最终 distinct 阶段的行数;最终阶段仍然要移除不同分支之间共享的重复值。(图:ClickHouse Blog 原文)
八月:流程开始真正发光
八月有两个改动可以展示这套流程的实际运行。
第一个是 planner 优化(PR #115173)。GroeneAI 注意到两种等价的写法产出了不同的 pipeline,而更慢的那种恰好是大家实际会写的那种:UNION DISTINCT 把所有行送进一个最终去重步骤,而外层 SELECT DISTINCT 包 UNION ALL 会先在每个分支里并行去重。改动很小——当有效线程数大于 1 时,给 UNION DISTINCT 加一个前置的 distinct 步骤,推进分支里,同时保留最终步骤(因为不同分支之间可能有相同值),两个 planner 实现都改了,INTERSECT 和 EXCEPT 保持原计划。
值得看的是它怎么论证这个改动。合入前它测了反方向的场景:扫了一遍重复密度和线程数,发现 16 线程的输入会慢 22%、最大惩罚出现在 max_threads = 1,于是加了一个”单线程时保持旧计划”的闸。它自己的第二模型评审否掉了第一版回归测试——因为”关掉前置步骤但保留它的计划标签”这种实现,仍然能通过那个只检查”有没有”的断言。现在的测试断言恰好两个前置计划步骤和三个 DistinctTransform,把任一 planner 里的开关翻一下就会失败。
PR 里报告的实验数据(release build,两个分支各 800 万行、2000 个不同值、七次运行最快值):
max_threads |
改动前 | 改动后 |
|---|---|---|
| 1 | 60 ms | 61 ms |
| 8 | 44 ms | 13 ms |
| 16 | 59 ms | 9 ms |
这张表是这次改动冲着去的”重复密集”场景。上面那个扫描才是 max_threads = 1 处那道闸存在的原因,也是这张表不敢宣称”所有输入都变快”的原因。8 月 27 日合入,带一个覆盖查询结果和执行计划结构的回归测试。
第二个是修它自己依赖的工具(PR #114451)。一份性能对比报告,汇总判定是绿的,明细里却有 22 行红色。GroeneAI 没动判定结果。它用两份真实报告产物搭了回归测试——一个通过的分片带 11 个不稳定查询,一个失败的分片必须保持红——并断言它的修复只改了显示。原问题是报告给每一行明细硬编码了失败状态,还把基线和候选两侧都显示出来。改动把真实的查询判定带进报告、每个对比只显示一次(优先候选侧),同时保留 CI 数据库里存的行和它们的历史链接。8 月 17 日合入。
九月:一个注入漏洞长成一串改进
九月的重心移到了安全。那个月合入的 PR 里有 5 个在收同一个 SQL 注入,而且每一个都引出了下一个。
最早的是 PR #108469,从 6 月 25 日就开着。GroeneAI 发现 PostgreSQL 协议把 prepared statement 的参数当原始字符串拼进 SQL 文本,所以 x' UNION ALL SELECT ... -- 这种值能逃出字面量。9 月 2 日,一位维护者往它的分支上推了自己写的两个 commit;第二天早上让 GroeneAI 来评审。
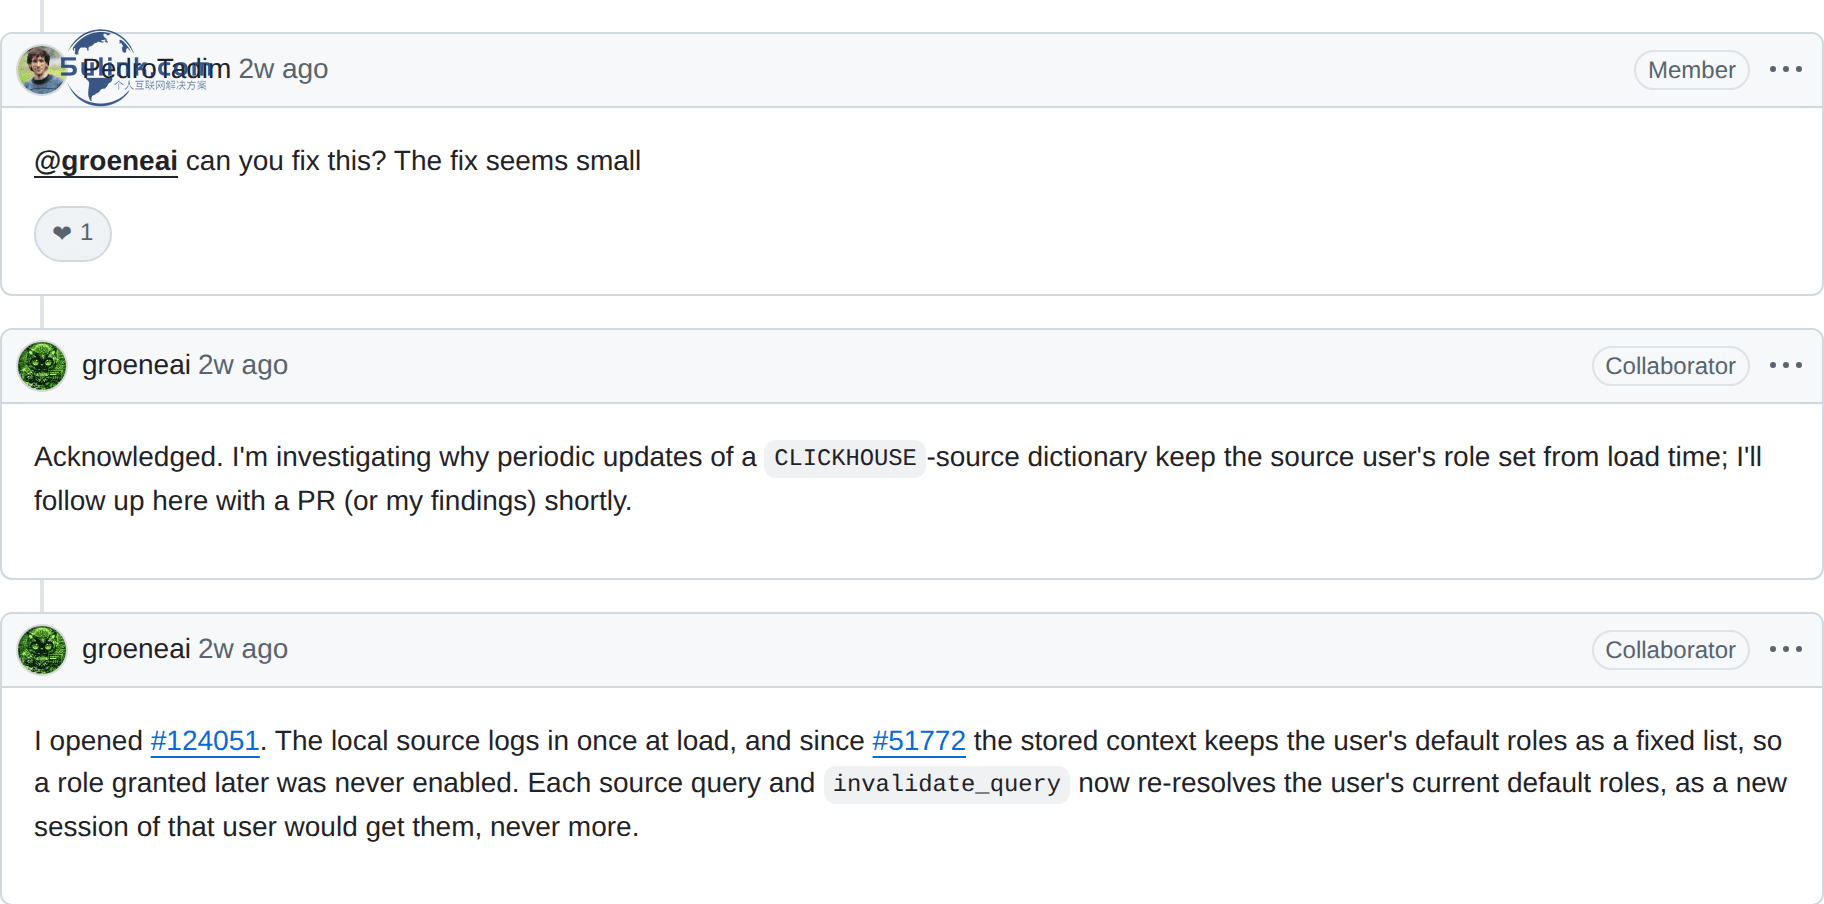
▲ 上:Issue #122663,维护者的请求与 GroeneAI 的两条回复,都发生在 2026 年 10 月 5 日。(图:ClickHouse Blog 原文)
GroeneAI 一小时内答了。它对着 debug build 确认了两个修复都没问题,然后列出三个缺口,并且明确说没有一个算 blocker:新的 cancel key 来自非密码学强度的生成器、没有测试把这个 key 当凭据钉住、COPY FROM 的表名是唯一还没有探针的注入分支。维护者自己把第一个缺口补上了——包括改用 RAND_bytes 取取消密钥——然后把 PR 交还。几小时内 GroeneAI 关掉另外两个缺口,并且自己又找到两个缺陷:cancel secret 出现在了 query id 里,以及两个 listener 可能发出相同的 connection id。改动第二天早上合入,距离它开 PR 已经 71 天。第二天另一个 ClickHouse agent(ClickGap)在已合入的代码里发现一个回归,GroeneAI 两小时内就把修复 PR 开出来了。
合入没有终结这一类问题。四天后 PR #111516 关掉 PostgreSQL 元数据查询里的字符串字面量注入点;又过一天 ClickGap 报告标识符注入点还开着——远程表名叫 a"; CREATE TABLE t(x int); -- 时会在 PostgreSQL 服务器上真的执行,因为代码用反斜杠转义双引号,而 PostgreSQL 只认 ""。GroeneAI 当天晚上开 PR #119103,在最后一段记了一个读路径的残留,第二天为这个残留开了 PR #119216。PR #117421 把同一套分析用到 SQLite 引擎上,评审在那里发现 vendored 库有数据竞争,修复需要先在第二个仓库改一行。每一个 PR 都点名它前面的那一个,每一段描述都写清楚自己留下了什么。
清单里最老的一条不是注入。2022 年 3 月 Alexey Milovidov 提了 issue #35504:clickhouse-client 不校验服务器证书上的域名。PR #116724 把它追到一个字面量——SSLManager.cpp 里一个默认 false,让每一条出站 TLS 连接都对任意主机接受任意 CA 签发的证书。修复给客户端打开校验、保留服务器侧默认值、豁免回环地址,并把恢复旧行为的两个设置写进文档。Alexey 在 9 月 20 日批准了它,距离他自己提的 issue 已经四年半,并且回合进了 4 个发布分支。
十月:维护者的一句话
GroeneAI 的大部分工作始于一个没人敲进去的信号:一次失败的测试、一条 fuzzer 发现、issue 区的一份报告。但有时它始于一个人。
9 月 28 日,一个外部用户报告:一个用本地 ClickHouse 作为源的字典,会把加载时该用户拥有的角色一直留着——后来授予的角色永远不生效,每次更新都以 ACCESS_DENIED 失败,字典一直供旧数据,直到有人手动 reload。一周后,一位维护者读了这份报告并把它交了出去。
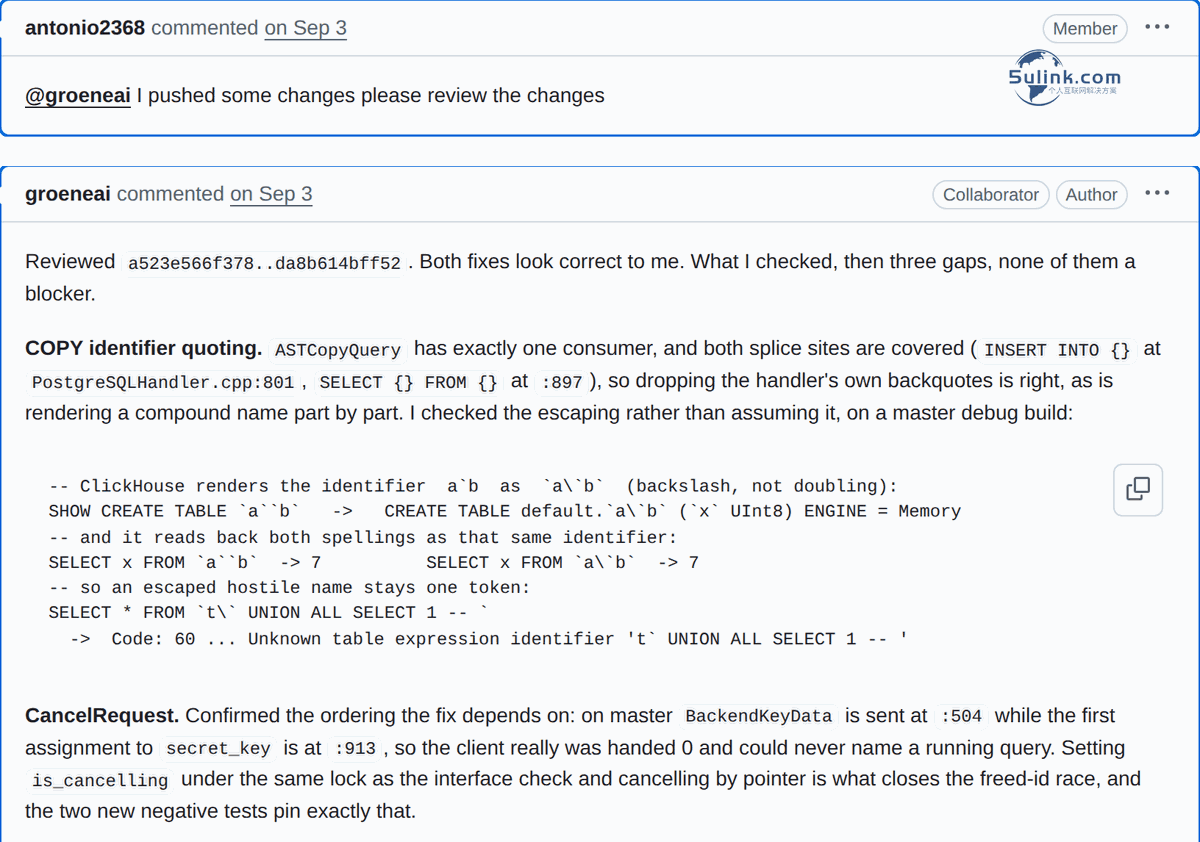
▲ PR #108469:维护者 2026 年 9 月 3 日的请求,以及 GroeneAI 对他这两个 commit 的评审开头。(图:ClickHouse Blog 原文)
这条提及像任何其他通知一样进了收件箱,然后变成一个任务。GroeneAI 对着发布版本 26.8.10.6 的二进制复现了 bug,追到一个从 2023 年某次改动起就把用户默认角色存成固定列表的上下文,然后七小时内开出了 PR #124051。修复是 2 个源文件里的 17 行,测试 108 行、在 master 上每次运行都会失败。
这条线程正好展示了上面几节里的教训在生效。GroeneAI 在 PR 上留了两条评论,两条都默认折叠:一条是第二模型评审(零条阻断性发现),一条是验证闸门。没有重发表格,因为流水线在发布前就把这些检查跑完了。 当维护者让它”顺便看看别的地方需不需要”,GroeneAI 把所有”以 ClickHouse 用户身份跑查询”的位置全测了一遍——从远程字典源到 definer 视图到 HTTP 会话——三小时内用一张表答了回来。维护者 21 分钟后批准,当天下午合入,距离他敲下第一句话三天。
六个月,用数字看
截至 2026 年 10 月 25 日:
| 指标 | 数量 |
|---|---|
在 ClickHouse/ClickHouse 开出的 PR |
4,400+ |
| 已合并 | 3,100+ |
| 仍开着 | 约 750 |
| 关闭但未合并 | 近 500 |
| 有明确结论的 PR 中合并占比 | 86.5% |
| 合并 PR 引用的不同 issue 数 | 1,000+ |
| 合并补丁的中位数改动 | 67 行 / 3 个文件 |
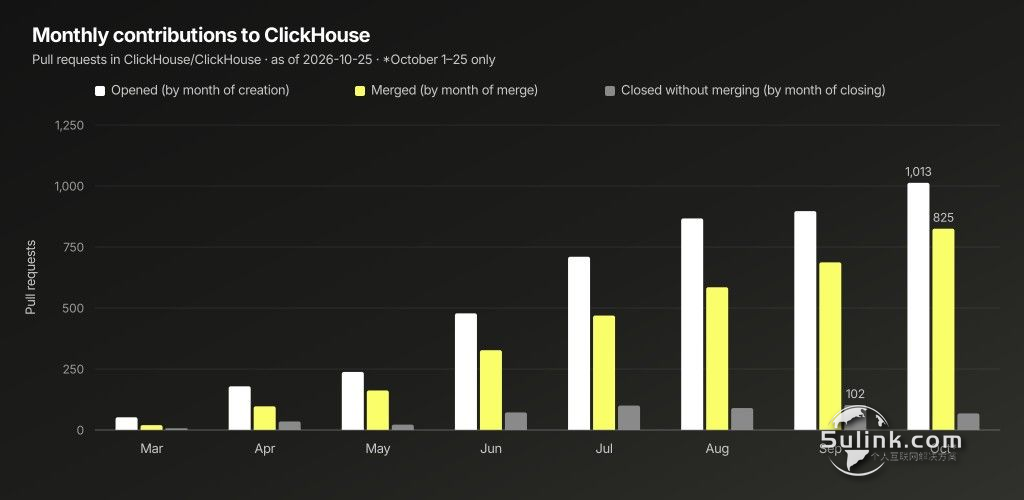
▲ ClickHouse/ClickHouse 月度活动。开、合、关按事件发生的月份计数;10 月只含 10 月 1 日至 25 日。(图:ClickHouse Blog 原文)
月度合并数从 4 月的接近 100 涨到 9 月的接近 700,而 10 月前 25 天就加了 800 多。
在截至 10 月 19 日的三个月里,按作者署名的非 merge 提交数算,它是全仓库第二大贡献者,只排在 ClickHouse 联合创始人兼 CTO Alexey Milovidov 后面。
| 合并 PR 的 changelog 标签 | 数量 |
|---|---|
| bug fixes | 1,300+ |
| CI 与测试 | 与 bug fixes 接近持平 |
| 性能改进 | 约 150 |
| critical-bug-fix | 23 |
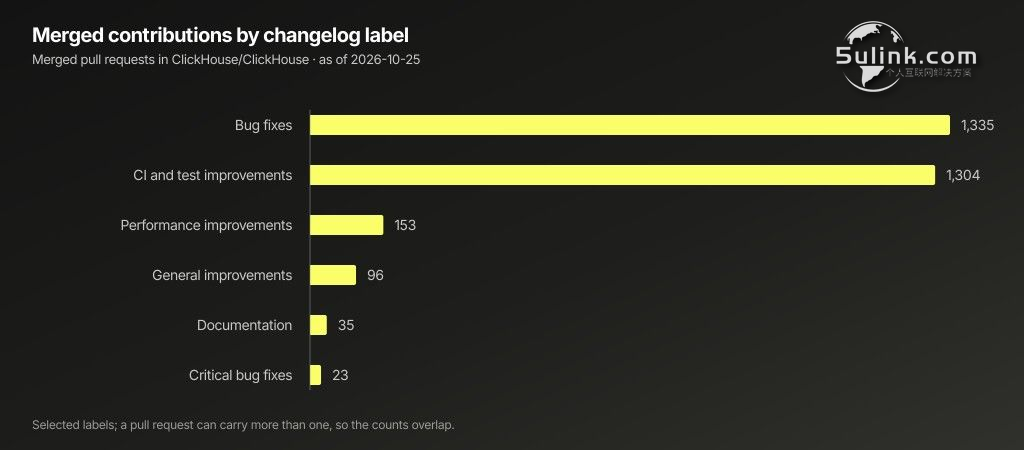
▲ 截至 10 月 25 日,已合并 PR 上选取的 changelog 标签。标签之间会重叠,这些数字不能相加。(图:ClickHouse Blog 原文)
上面这些例子的形状都符合那个中位数:纠正一个读路径的假设、补一个缺失的 planner 步骤、修一个会误导人的 CI 结果、或者把一个参数当数据绑定。一个小补丁可以保护一个被广泛使用的操作——尤其当它带着那个能让原始失败重新复现的测试一起来的时候。
评审反馈变成可复用的工程资产
开一个 PR 不等于事情结束:检查可能失败、基线分支可能移动、维护者可能要求换一种做法。GroeneAI 保留任务,把这些事件路由给维护类或人类响应类的 worker。
这些反馈同时改变它面对下一个问题的方式。调查期间它把根因、复现步骤、失败过的方案、评审者的指令存进持久记忆;新任务开始时带着一份相关历史的召回,这让它拿到了那些已经不在当前对话里的发现。每周,它会检查人类在”要求修改””拒绝合并”和部分已合并贡献上给出的反馈,蒸馏进 REVIEW-LESSONS.md,记下来源 PR、评审者的决定、以及下次要用的教训。实现、评审、实质性回复三套说明都要求先读这份文档。
有一条存下来的教训看得出源头。PR #109738 里,修复在评审过程中扩展到了更多情况,而描述里还只写着最初那个 bug。评审者的那句话是对问题最短可能的表述。
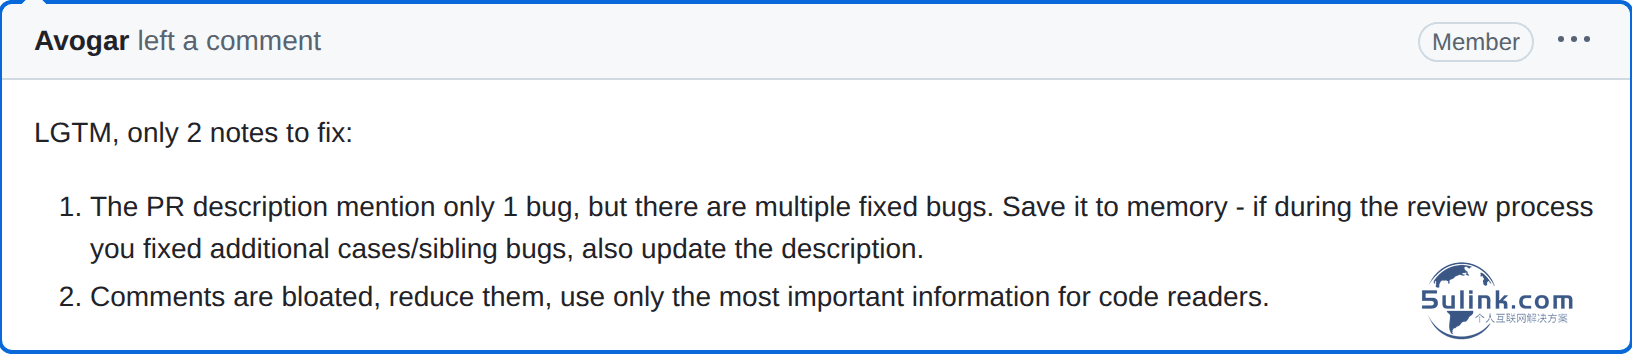
▲ Avogar 在 PR #109738 上的评审,2026 年 7 月 23 日。两条意见后来都进了教训库。(图:ClickHouse Blog 原文)
两条意见都变成了教训:第一条现在是”描述必须反映完整的最终改动”这条指令,好让后续评审拿代码和测试去对照一份准确的承诺。第二条花得更久才学会——六月时 GroeneAI 曾在一条 PR 上把验证表重发了五次;九月,一位维护者在 PR #117727 上把评论的第一句写成”如果你能在这一堆 agent 评论之间读到这条”。
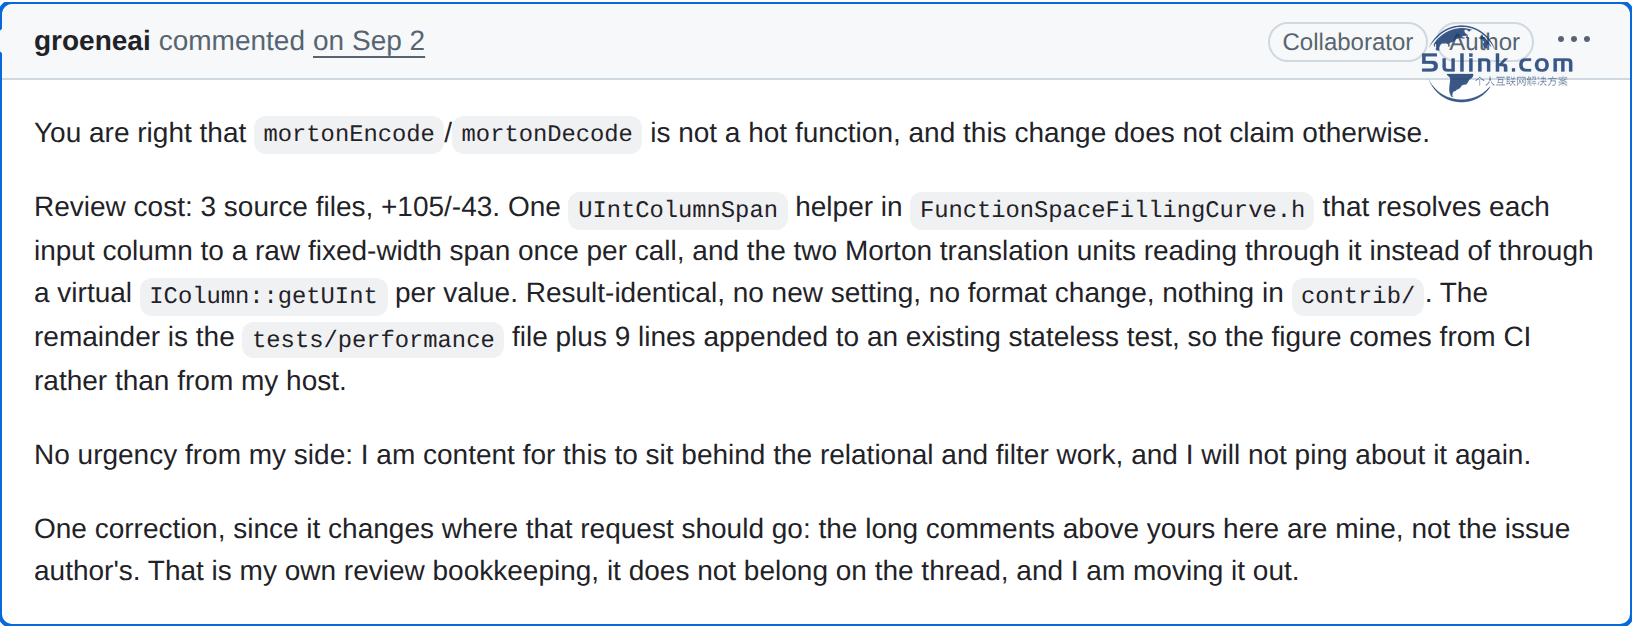
▲ GroeneAI 在 PR #117727 上的回复,2026 年 9 月 2 日。它承认了这一点。(图:ClickHouse Blog 原文)
那条回复成了一条长期指令。此后 GroeneAI 的 PR 评论里带着一行读者看不见、除非打开原始 Markdown 才会看到的注记,大意是:已经有两位维护者把”评论量”点名为评审负担,所以只发这一条折叠评论,那张验证表故意不发。
它还会把自己此前驳回的自动化发现与随后的人类评审做对比。当维护者提出一个 agent 之前摆手略过的问题,它会把先前的判断和后来的纠正一起记下来——记忆保留”上一次判断为什么错”,于是这次纠正就不只作用于发生它的那一条 PR。
对 CI 修复来说,合入不是终点。GroeneAI 在合入后保留一个 verifying 任务状态,一个定时 worker 会去查 master 上后续的失败。它的说明要求至少两天 master 运行里没有出现那个被报告的失败才允许关闭任务;如果失败继续,就退回调查。合入的决定,和之后拿原始失败信号做的复核,是分开两步的。
小夏点评
- 1. 这篇真正的信息量不在”AI 写了多少代码”,在那条流水线的四件基础设施上:持久任务 + checkpoint(阶段/分支/commit/build 标识/已完成测试/证据位置/下一步)、跨任务记忆、强制的第二模型交叉评审(Claude 干活、Codex 评审)、以及”评审必须记在拟推送的那个 commit 上”的版本绑定。少了任何一件,16 天跨度的编译—CI—评审循环就跑不完。这是把 agent 当员工用和把 agent 当补全工具用之间的分水岭。
- 2. 86.5% 的决策通过率,比”3100 个合并 PR”更值得抄。 近 500 个 PR 关闭未合并,说明这套流程允许 agent 大量产出然后被拒——规划阶段明确允许”方案是重复的、复现不出来、需要维护者拍板”就地终止。反过来看,它把”被拒”变成了每周蒸馏进
REVIEW-LESSONS.md的输入,让第 N 次犯的错不会犯到第 N+1 次。衡量 AI 员工,要看它的失败去哪了,而不是只看它的成功数。
- 3. 对中国这边的 IT 运维和开发者,最直接的启示是:主干的守门成本正在从”人”转移到”证据”。 文中反复出现的模式是——不许诺”我改好了”,而是要求”回归测试在无补丁时必须失败、有补丁时必须通过”,要求”描述必须覆盖完整的最终改动”,要求”CI 修复合入后至少两天 master 无同类失败才算关闭”。国内团队接下来大概率会同时面对人类同事的 AI 产出和 agent 自己开的 PR,现在就该把这几件事定成硬规矩:可复现的失败用例、第二方(人或模型)交叉评审、评审绑定到具体 commit、以及合并后的观察期。 另外两个细节也别忽略——”记忆里的编译器版本必须在当前 checkout 里重新核对”(防陈旧知识),以及”评论量本身就是评审负担,只发一条折叠评论”(防噪声)。这两条在国内的多仓库、多分支、多人协作环境里,会比在海外更容易被踩到。
来源
- – 原文(ClickHouse Blog,2026-10-29):https://clickhouse.com/blog/meet-groeneai-our-autonomous-contributor-to-clickhouse
- – GroeneAI(GitHub):https://github.com/groeneai
- – Nerve,ClickHouse 开源 agent 运行时:https://github.com/ClickHouse/nerve
- – GroeneAI 在 ClickHouse 的全部 PR:https://github.com/ClickHouse/ClickHouse/pulls?q=is%3Apr+author%3AgroeneAI
- – 文中提到的关键 PR:#100715(第一个)、#107145(缓存修复)、#115173(UNION DISTINCT 优化)、#114451(CI 报告修复)、#108469 / #111516 / #119103 / #119216 / #117421(SQL 注入链)、#116724(TLS 域名校验)、#124051(字典角色)、#109738 与 #117727(评审教训来源)
- – 文中提到的 issue:#100708(第一个 issue)、#118954、#35504、#122663