ClickHouse 上手 NVIDIA Vera CPU:登顶 ClickBench 硬件榜的缩放效率实测
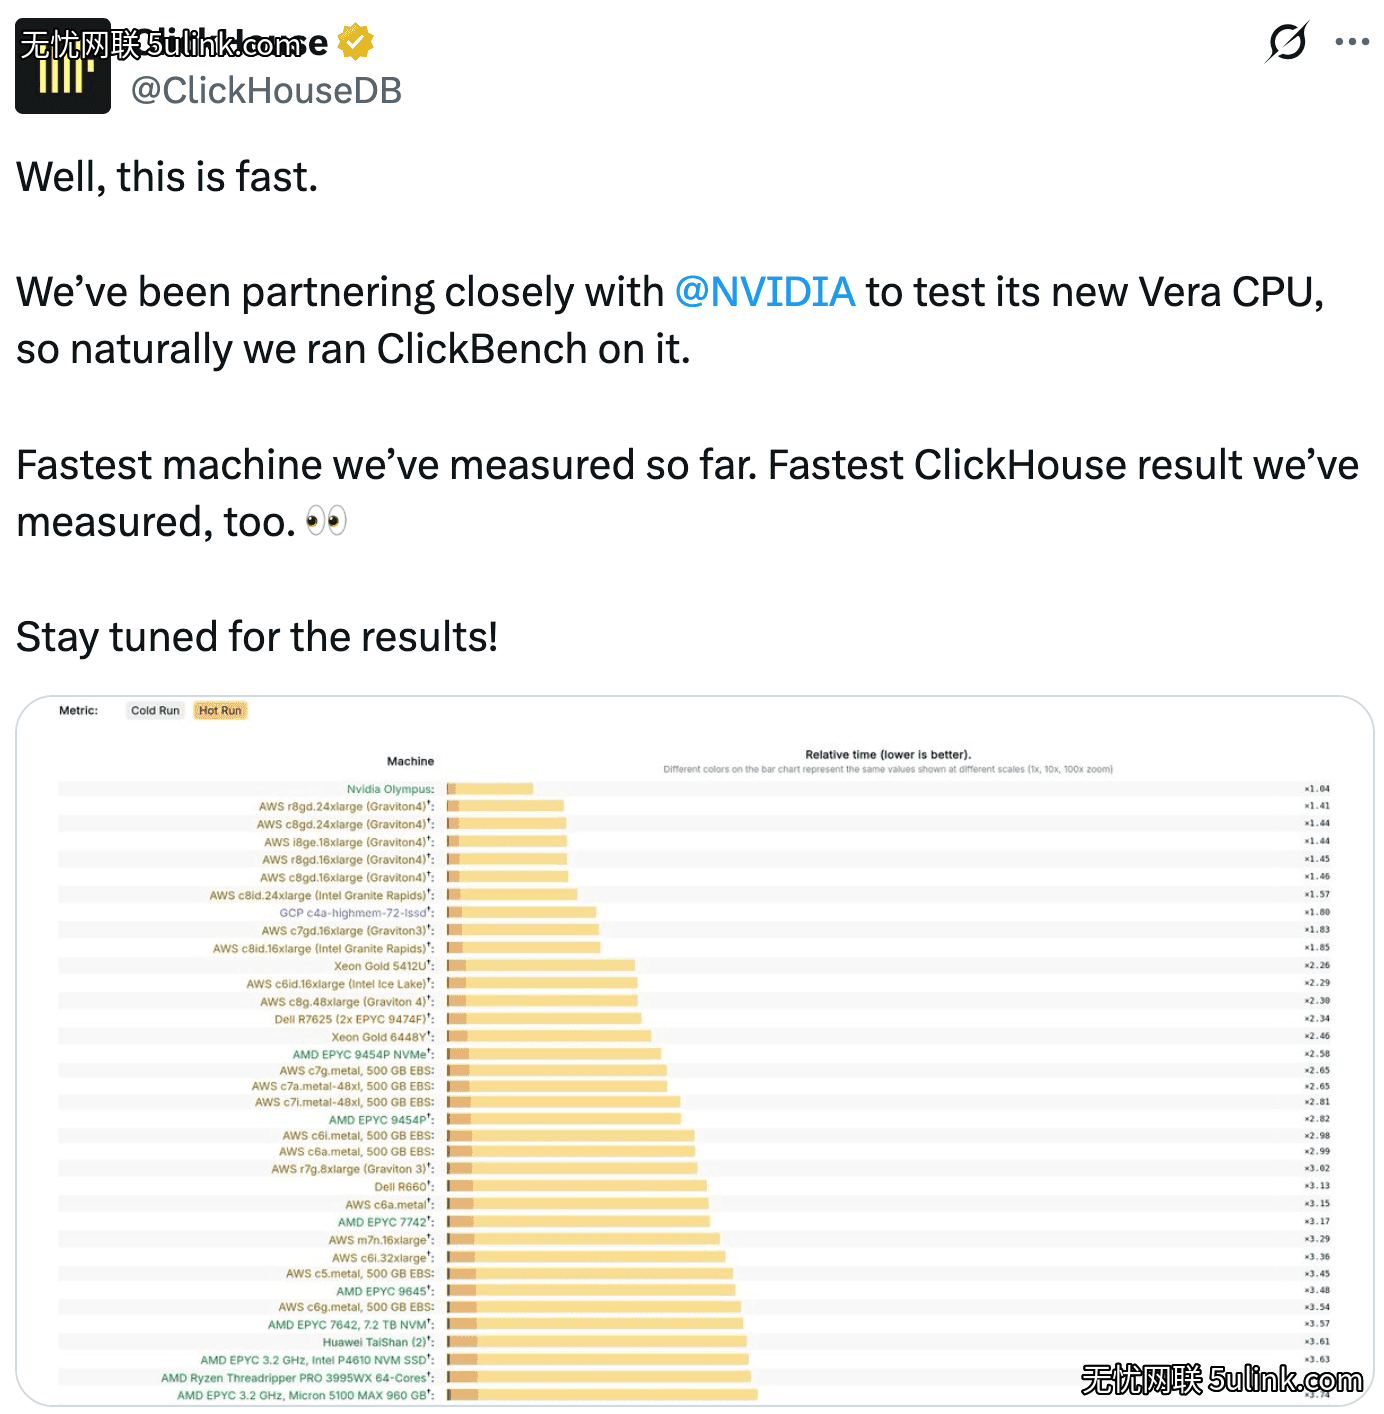
NVIDIA 最近给 ClickHouse 送了一台尚未发布的 Vera CPU 平台早期访问机器。ClickHouse 工程师做的第一件事很符合直觉:把自家热门分析基准 ClickBench 跑上去。用的是官网标准二进制,没有为 Vera 做任何数据库侧优化——结果它立刻以大幅优势登上 ClickBench 硬件排行榜头名。
Vera 是什么机器
| 项目 | 规格 |
|---|---|
| 核心 | 每路 88 个 NVIDIA Olympus 核,完全兼容 Arm-v9.2 |
| 双路合计 | 176 核 / 352 硬件线程(NVIDIA Spatial Multithreading) |
| 缓存 | 每核 L1 数据/指令 96/64 KB,L2 2 MB,共享 L3 164 MB |
| 内存带宽 | 1.0-1.2 TB/s(视 DRAM 容量) |
真问题:机器翻倍,查询能不能快一倍
硬件更强当然什么都更快——这篇文章真正回答的是缩放效率:CPU 核数、缓存、内存带宽全部翻倍时,查询应该快一倍,而不是不到一倍。数据怎么组织、怎么进内存、怎么处理,每一层都影响数据库能不能”吃满”这台机器。
为什么现在关心这个:过去绝大多数查询来自 Grafana、Tableau 这类仪表盘和 BI 工具,而 ClickHouse Cloud 里Agent 自主回答数据问题的比例在上升。Agentic 查询有三个特征——形状更 ad-hoc 且题与题差异大、到达时间不可预测且成批爆发、大量并行(Agent 会派生子 Agent)。这类负载对缩放效率的要求比传统 BI 苛刻得多。
测试方法:三个模拟基本操作的微基准——过滤(WHERE)、聚合(GROUP BY)、连接(JOIN)。数据全部放内存(Memory 表引擎),排除磁盘 I/O 干扰:单列 625 亿条随机字符串(5-10 个 ASCII 字符),表大小正好 1 TB,不压缩。ClickHouse 的查询层与存储层解耦,所以结果可以直接映射到云上和开源版的 MergeTree 表。
基准一:过滤——先撞上内存墙
最简单的子串匹配 WHERE s LIKE '%ab%',按线程数记录耗时:
| max_threads | 耗时 | 加速比 | 效率 | 吞吐 |
|---|---|---|---|---|
| 1 | 50.44 s | 1.00x | 100% | 19.83 GB/s |
| 16 | 3.25 s | 15.52x | 97.0% | 307.69 GB/s |
| 64 | 1.23 s | 41.01x | 64.1% | 813 GB/s |
| 256 | 1.11 s | 45.44x | 17.8% | 900.9 GB/s |
耗时随线程数线性下降——直到 64 线程撞墙,加到 256 线程几乎没有增益。用 1TB 除以耗时验证:撞墙时内存 I/O 达 813-900 GB/s,正好是 Vera 的物理内存带宽。这条查询是内存受限的,加核没用。
把查询改成对每行跑正则 match(s, '[0-9][a-z][A-Z]'),变成 CPU 密集后,缩放几乎完美:
| max_threads | 耗时 | 加速比 | 效率 |
|---|---|---|---|
| 32 | 37.8 s | 32.00x | 100.0% |
| 128 | 9.8 s | 123.44x | 96.4% |
| 176(物理核数) | 7.4 s | 163.47x | 92.9% |
| 352 | 5.3 s | 228.25x | 64.8% |
效率从 176 核(物理核数)开始下滑:之后的线程由逻辑线程(SMT)服务。SMT 擅长掩盖缓存未命中、分支预测失败这类停顿,对纯计算负载只能帮 10-30% 的忙——曲线形状和教科书预测完全一致。
基准二:聚合——低基数也要算得动
按首字符分组(255 组,典型低基数聚合),用 sipHash64 保证查询 CPU 密集:
| max_threads | 耗时 | 加速比 | 效率 |
|---|---|---|---|
| 32 | 27.4 s | 32.27x | 100.8% |
| 64 | 13.9 s | 63.60x | 99.4% |
| 176 | 5.4 s | 163.72x | 93.0% |
| 352 | 4.9 s | 180.43x | 51.3% |
64 线程前接近完美缩放,之后同样在物理核数后回落。Vera 的神经分支预测和预取帮 ClickHouse 高效读写哈希表、掩盖数据倾斜带来的访问延迟。执行计划里主要算子都带 × 352——表被切成 352 个虚拟块并行处理,聚合哈希表按流建立后合并,全程满并行。
基准三:连接——事实表 × 维表
从 1TB 大表抽样 62.5 万行(0.001%)建维表,跑一个典型的事实表-维表 JOIN:
| max_threads | 耗时 | 加速比 | 效率 |
|---|---|---|---|
| 32 | 35.9 s | 31.55x | 98.6% |
| 128 | 9.3 s | 121.78x | 95.1% |
| 176 | 7.3 s | 155.15x | 88.2% |
| 352 | 6.1 s | 185.67x | 52.8% |
耗时几乎与线程数成比例下降。底层是 ClickHouse 的 parallel_hash join 算法——哈希表由所有查询线程并行构建,同时构建运行时过滤(runtime filter)加速探测。真实场景里连接列通常是事实表主键(外键连接),还能解锁另一项近期加入的优化,这篇实验里没用上。
附赠:SIMD,单线程下的 3.5 倍
多线程之外,正交的另一条并行路线是 SIMD。25 亿行 UInt32 上跑 WHERE x > 2000000000,单线程耗时 0.42 秒;在比较循环前加 pragma 关掉编译器自动向量化,同一查询变 1.48 秒,慢 3.5 倍。向量化开着时,ClickHouse 用 Vera 的 128 位 NEON 指令一次比较 4 个 32 位整数。NEON 之外 Vera 还有更强的 6×128 位 SVE2 实现,ClickHouse 对 SVE2 的支持正在和开源社区一起加(PR #122860)。
CTO 怎么看
> “NVIDIA Vera 是我们见过最快、最强大的服务器平台。ClickHouse 承诺把它的巨大潜力转化为世界级的分析性能。” —— Alexey Milovidov,ClickHouse CTO
文章结尾留了钩子:后续会有一篇讲 ClickHouse 如何分析、优化、测试大规模查询性能的工程文章。
小夏点评
- 1. 这篇的价值不在”Vera 很快”,在缩放效率曲线——内存受限查询在 64 线程撞墙、CPU 密集查询在物理核数(176)后效率从 93% 滑向 65%,两条曲线就是下一代 ARM 服务器容量规划的教科书:SMT 线程别按满线程数做预算。
- 2. Agentic 查询是被点名的负载方向——形状多变、爆发到达、大量并行,恰好是最吃缩放效率的形态。数据库在 ARM 高核数平台上的表现差异,会从”跑分”变成真金白银的成本差。
- 3. 对中国 IT 运维/开发者的启示:国内数据库跑 x86 为主,Vera 这类 ARM 高核数平台正在进入采购视野(国内也有多家 ARM 服务器厂商)。迁移前别只看单核跑分,用这篇的方法自测:跑一个内存带宽打满的过滤查询和一个 CPU 密集的聚合查询,看效率曲线在哪里弯下去——弯点就是你的实际并发上限,这比厂商宣传的核数靠谱得多。
参考链接
- – 原文:https://clickhouse.com/blog/clickhouse-performance-on-nvidia-vera
- – NVIDIA Vera CPU 官方介绍:https://developer.nvidia.com/blog/nvidia-vera-cpu-boosts-ai-factory-throughput-to-accelerate-agentic-workloads/