这篇是三天前《开源模型吃掉八成流量之后:vLLM 和 SGLang 到底怎么选》的姊妹篇:两家的选型判断线那篇已经写完,这篇把 LMDeploy 拉进同一张基准表——三家同场跑分,重点看第三家的增量在哪。
先看结论表
| 项目 |
vLLM |
SGLang |
LMDeploy |
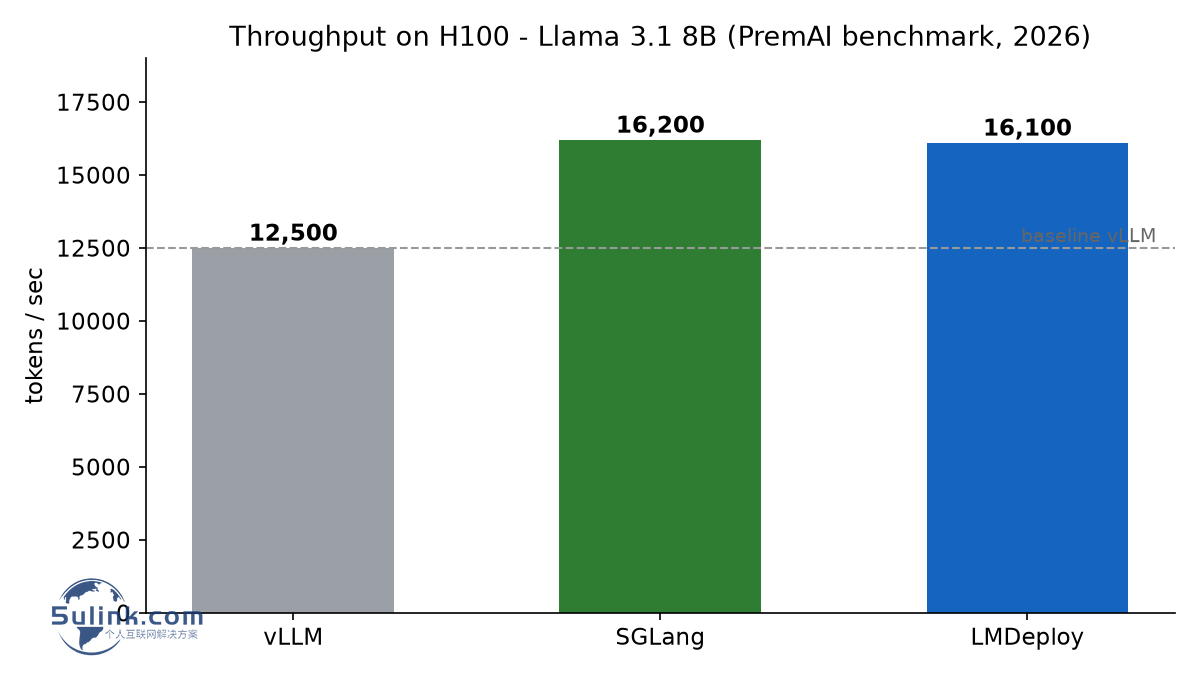
| 吞吐(H100,Llama 3.1 8B) |
**~12,500 tok/s** |
**~16,200 tok/s** |
**~16,100 tok/s** |
| 核心技术 |
PagedAttention |
RadixAttention |
**TurboMind(纯 C++)** |
| 多轮对话 |
好 |
**极好(快 10-20%)** |
好 |
| 量化支持 |
Int4、AWQ、GPTQ |
FP4/FP8/Int4/AWQ/GPTQ |
**同类最强(Int4 快 2.4 倍)** |
| 首 token 延迟(TTFT) |
低并发下优秀 |
命中缓存时最好 |
**整体最低** |
| 部署复杂度 |
容易(pip install) |
中等 |
中等 |
| 社区规模 |
最大 |
增长中(**40 万+ GPU**) |
中等 |
| OpenAI API 兼容 |
是 |
是 |
是 |
| 适合 |
通用生产、兼容性优先 |
Agent 工作流、多轮、前缀复用 |
量化模型、显存受限 |
29% 的吞吐差不是抽象数字:按每天 100 万次请求计算,每月约 1.5 万美元的 GPU 成本差。流量越大,这条差距越值钱。
vLLM:地基,但代价是内存
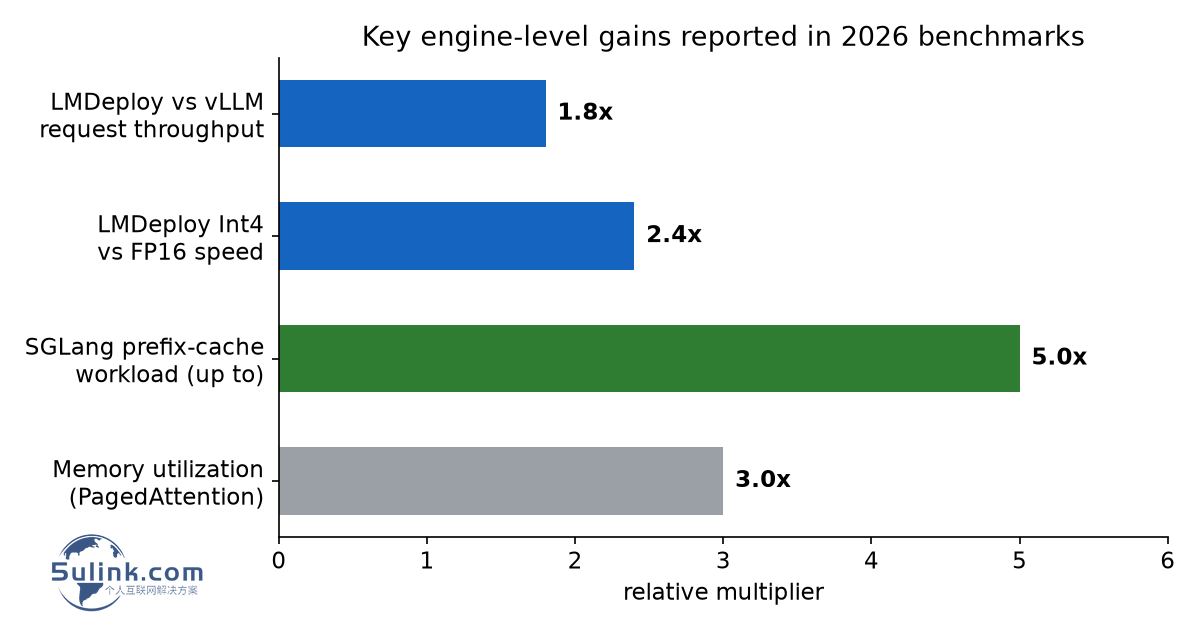
PagedAttention 把显存利用率从大约 30% 提到 90% 以上,相对老一代推理栈吞吐提升 2-4 倍,且兼容性好、pip install 就能跑,社区最大。
代价在基准里也能看到:A100 80GB 跑 Llama 2 7B Chat(FP16)时,vLLM 吞吐只是”中等”,显存占用却和 TensorRT-LLM 一个量级——灵活的架构本身有性能成本。
SGLang:RadixAttention 才是主角
RadixAttention 把已计算的 KV 张量存进一棵基数树(radix tree),跨请求做前缀匹配:系统提示词、few-shot 示例、对话历史这些共享前缀,命中就直接复用计算,前缀密集的负载最高快 5 倍。
独立测试(H100,Llama 3.1 8B):约 16,200 tok/s,比 vLLM 快 29%。
多轮负载因缓存命中再快 10-20%,命中时 TTFT 显著下降。
原文给出的缓存命中率区间:75-95%。
部署规模:40 万+ GPU。
风险点:内存压力下 RadixAttention 可能把缓存的前缀挤掉——省下来的钱会以另一种形式还回去。
LMDeploy:TurboMind 的增量在哪
这是三家里唯一纯 C++ 推理引擎(无 Python 侧开销),也是本篇重点:
官方宣称请求吞吐比 vLLM 高 1.8 倍,独立基准证实,量化模型上尤其明显。
Int4 推理比 FP16 快 2.4 倍;量化让显存需求降约 4 倍,70B 模型能塞进单张 A100 80GB。
实测场景:A100 80GB 跑 Llama 3 70B(4-bit 量化、100 并发),700 tok/s,TTFT 是所有被测引擎里最低的。
各并发档位 TTFT 都保持最低——vLLM 在 H200 上 64 并发时 TTFT 近乎即时,SGLang 命中缓存时更好,但”全程最低”这项归 LMDeploy。
量化路径上,原文的独立测试里 ExLlamaV2 是速度/显存比最好的,AutoAWQ 显存占用最低,LMDeploy 的强项是同类最强的 Int4 速度。
代价:要接受 C++ 后端与 NVIDIA 专属代码路径,社区规模不如另外两家。
基准条件(原文)
硬件:A100 80GB、H100 80GB
模型:Llama 2 7B Chat、Mistral 7B v0.1 Instruct
精度:Float32 / Float16 / Int8 / Int4
批大小:1(单请求延迟取向)、max tokens 512、每配置 10 次重复
小夏点评
三家的差距是负载依赖的,不是”谁绝对最快”:SGLang 的 29% 建立在多轮/前缀复用(命中率 75-95%)上,LMDeploy 的 1.8 倍建立在量化 + 纯 C++ 上。单轮、短上下文、FP16 的负载跑不出这个差距。
原文口径要留意:批大小 1、max tokens 512、10 次重复,是延迟取向的测法;而”每月省 1.5 万美元”是按 100 万请求/日外推的。国内团队引用这类数字时,最好按自己的并发档位重测——并发一上来,排名会变。
给中国 IT 运维/开发:如果你们的推理服务是”多轮 + 长系统提示词”(客服、Agent、代码助手),SGLang 的 RadixAttention 是目前最容易兑现的免费午餐,但要盯住缓存被挤掉的场景;如果是”卡少模型大”(单卡跑 70B),LMDeploy 的 Int4 路线(显存降 4 倍、70B 进单卡 A100)比加卡便宜得多,代价是接受 NVIDIA 专属栈和 C++ 后端。vLLM 的位置是”不想折腾就要的那份确定性”——它慢 29%,但 pip 装完就能跑、社区最大。两家日常怎么挑的完整版见姊妹篇(https://www.5ulink.com/archives/5278),这篇只补第三家的实数。
参考来源
PremAI:vLLM vs SGLang vs LMDeploy: Fastest LLM Inference Engine in 2026(2026-02-28)