把 KV 缓存挪进 SSD:首 token 延迟降了 4 倍,GMI Cloud × Tensormesh 联合实测
> 这是 GMI Cloud 与 Tensormesh 工程团队的联合技术基准:在模拟真实生产流量的多轮对话负载下,评估 SSD 扩展 KV 缓存对 LLM 推理性能的实际影响。原文发布于 2025-12-30。
核心结论:同硬件、零成本,TTFT 快 4 倍
| 指标 | 基线 vLLM | 仅 RAM 缓存 | RAM + 大容量 SSD |
|---|---|---|---|
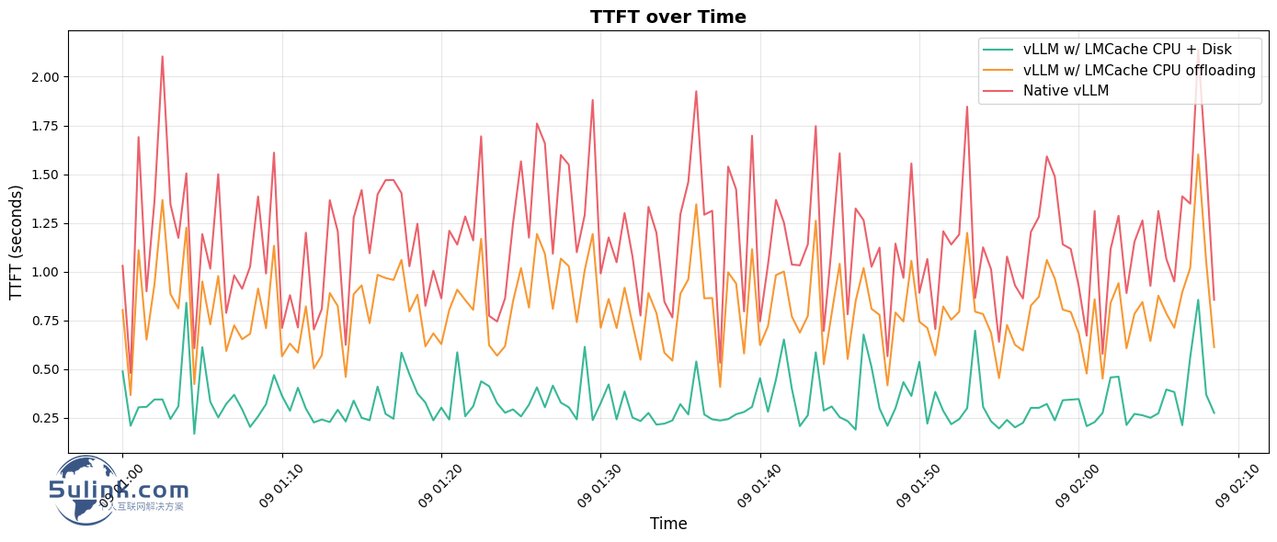
| 首 token 延迟(TTFT) | 基准 | 仅 **1.4x** 改善 | **4x** 改善 |
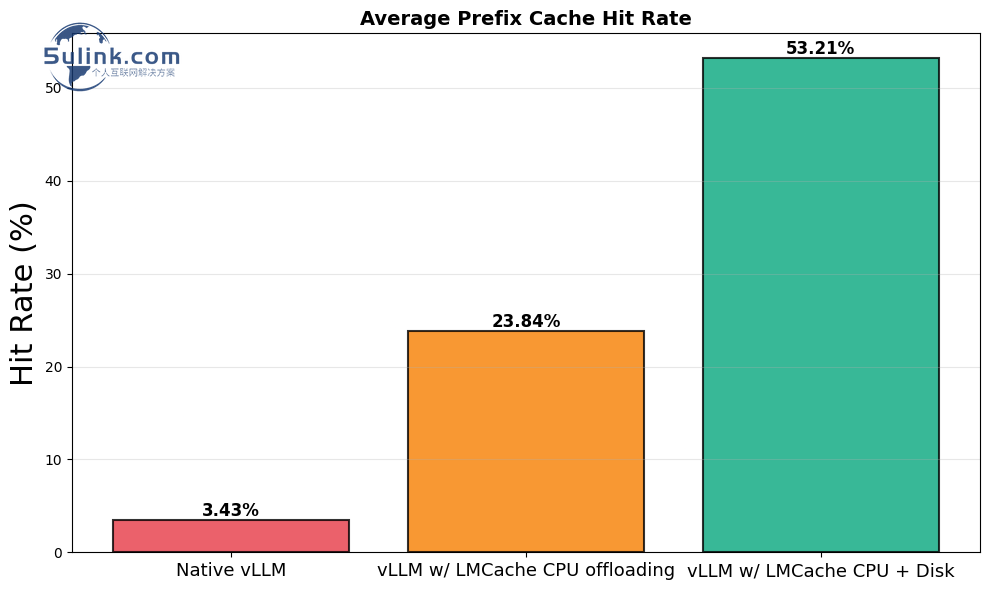
| 前缀缓存命中率 | ~0 | 快速驱逐、难以维持 | 从 **3% 升至 50%+** |
| 延迟波动 | — | 长 prompt 波动大 | 显著平滑 |
| GPU 冗余重算 | — | 有限 | 明显下降 |
关键判断:缓存容量(footprint)才是 KV 缓存能否生效的决定性因素。RAM 装不下就疯狂驱逐,命中率上不去;接入大容量 SSD 后缓存才”养得活”,4 倍收益才兑现。
怎么测的:用合成数据还原真实流量
出于客户数据隐私,GMI 没有用真实数据,而是按线上客户 prompt 特征构建了高仿真合成数据集:
两套推理栈对跑:基线 vLLM(标准 KVCache)vs 集成 Tensormesh 缓存层的 LMCache-enabled vLLM,分别测”仅 RAM”和”RAM + 大容量 SSD”两种配置。
实测结果
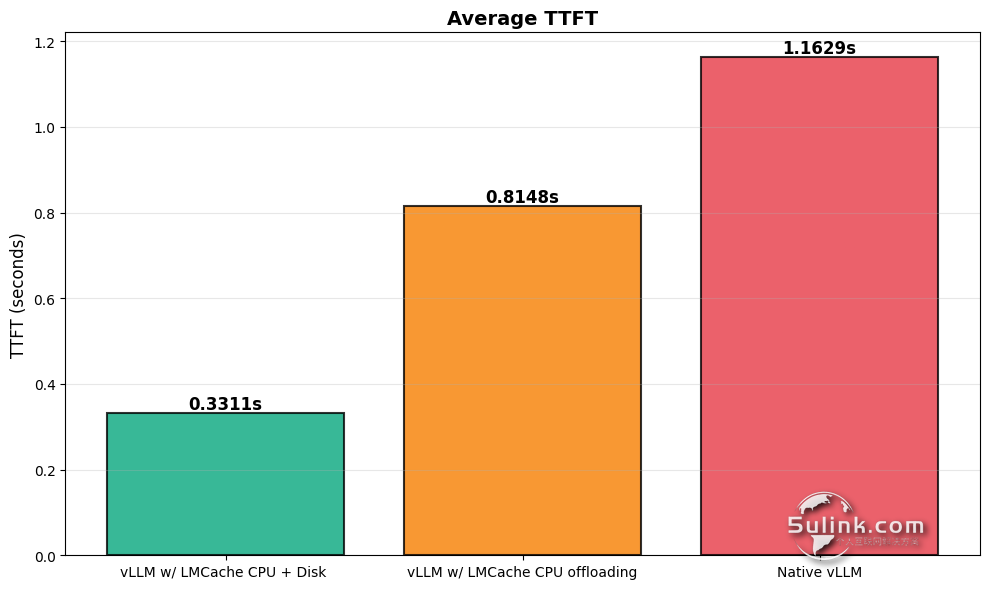
仅 RAM 缓存:TTFT 只有约 1.4x 改善——缓存太小、驱逐太快,多轮场景基本白搭。
SSD 扩展缓存:TTFT 改善 4 倍,命中率随缓存预热爬向 50%,不同 prompt 长度之间的延迟波动被明显抹平。
平均首 token 延迟对比:
前缀缓存命中率(从近 0 爬到近 50%):
TTFT 随时间变化(缓存加载后波动收敛):
对 LLM 服务架构意味着什么
GMI 工程团队的原话是:这是一套”没有额外成本、纯赚性能”的方案。
背景:Tensormesh 与 GMI Cloud
Tensormesh 主打缓存加速的推理优化,宣称最高可将推理 GPU 成本和延迟降低 10 倍,近期完成由 Laude Ventures 领投的 450 万美元种子轮。GMI Cloud 是 NVIDIA Cloud Partner,提供 Blackwell 与 H100/H200 GPU 集群及模型推理服务。